456数据如何建立转化漏斗?从步骤设计到流失归因
很多团队建漏斗时直接套模板:把「访问—浏览—下单」三步往上一放,就开始看转化率。因为步骤定义决定流失率高低,所以步骤设计不合理的漏斗,数字再好看也没有优化价值。456数据建议按五步建立漏斗:定起点终点、拆中间步骤、设跳步规则、看转化分布、做流失归因。
本文要点
- 漏斗价值取决于步骤定义是否贴近真实转化流程
- 第一步定起点与终点,起点错误漏斗整体失真
- 中间步骤按行为顺序拆分,数量控制在关键环节
- 跳步规则要显式定义,避免误判流失
- 流失归因四步:定流失层、圈人群、查路径、看来源
一、漏斗建立五步概览
因为漏斗是把转化过程拆成可量化的步骤序列,所以建立漏斗要按五步走:定起点终点、拆中间步骤、设跳步规则、看转化分布、做流失归因。
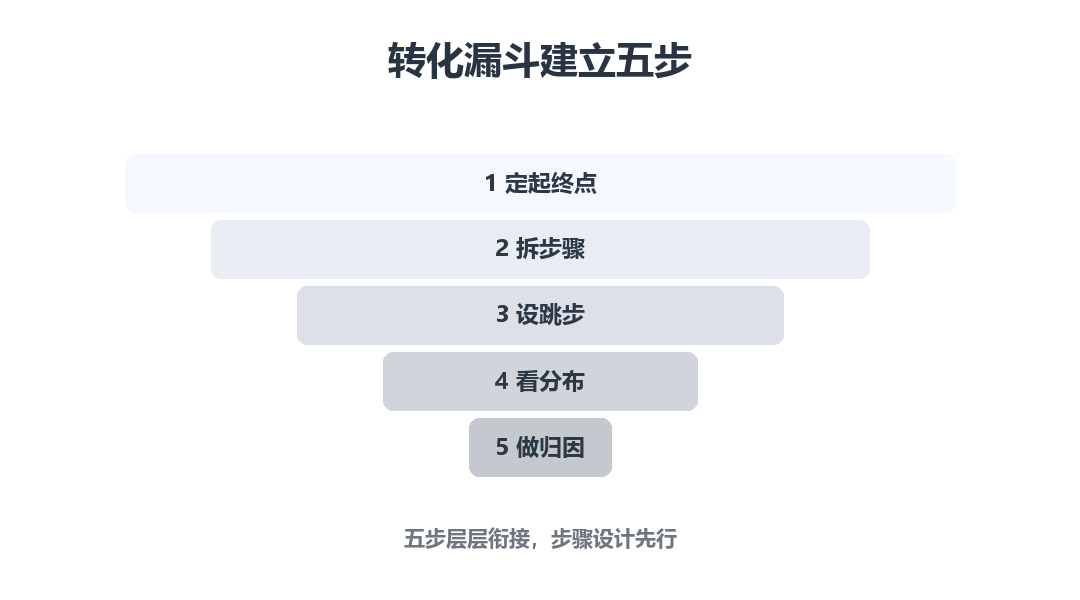 转化漏斗建立五步:定起终点、拆步骤、设跳步、看分布、做归因
1. 为什么步骤设计先行
因为步骤定义决定「谁算进入漏斗、谁算流失」,所以步骤设计先行,后续的转化率与流失归因才有意义。步骤定义不清的漏斗,优化动作无处着力。
2. 五步的产出物
每一步都有明确产出:起点终点定义漏斗边界,中间步骤定义转化路径,跳步规则定义流失口径,转化分布定位瓶颈,流失归因指导优化。因为五步层层衔接,所以建议按顺序完成,不跳过中间环节。
| 步骤 | 要回答的问题 | 产出物 |
|---|---|---|
| 定起点终点 | 漏斗从哪开始到哪结束 | 边界定义 |
| 拆中间步骤 | 转化路径有哪些关键环节 | 步骤清单 |
| 设跳步规则 | 哪些跳过不算流失 | 流失口径 |
| 看转化分布 | 瓶颈在哪一步 | 转化分布 |
| 做流失归因 | 流失的人是谁、为什么 | 归因结论 |
二、定起点终点,拆中间步骤
1. 起点与终点的定义
漏斗起点是用户进入转化流程的第一个行为,终点是转化完成的标志行为。因为起点决定分母,所以起点要选择意图明确的入口行为;因为终点决定「转化」的定义,所以终点要选择业务确认的完成标志,例如表单提交成功、订单支付成功。起点定义有个常见取舍:入口行为选「到达落地页」还是「首次点击转化相关按钮」。因为前者包含大量仅浏览的用户、后者只包含有行动意图的用户,所以按业务目标选择:做线索量分析选前者,做转化质量分析选后者。
2. 中间步骤按行为顺序拆分
中间步骤按用户真实行为顺序拆分:从起点到终点之间有哪些关键环节,每步对应一个可判断的行为事件。因为步骤过多会放大流失、步骤过少会掩盖瓶颈,所以中间步骤控制在三到五步,覆盖关键决策点即可。
3. 步骤设计的常见错误
常见错误有三类:起点过宽把无关流量计入、步骤顺序与真实行为不符、终点定义与业务口径不一致。因为三类错误都会扭曲流失率,所以建立漏斗后用真实路径数据核对步骤顺序,发现偏差及时修正。核对方法是随机抽样一批已转化用户,看他们的真实行为顺序是否与漏斗步骤一致。因为真实路径是最权威的参照,所以抽样的结果能直接暴露步骤顺序错误,比凭经验调整步骤可靠。
三、跳步规则:流失还是不算流失
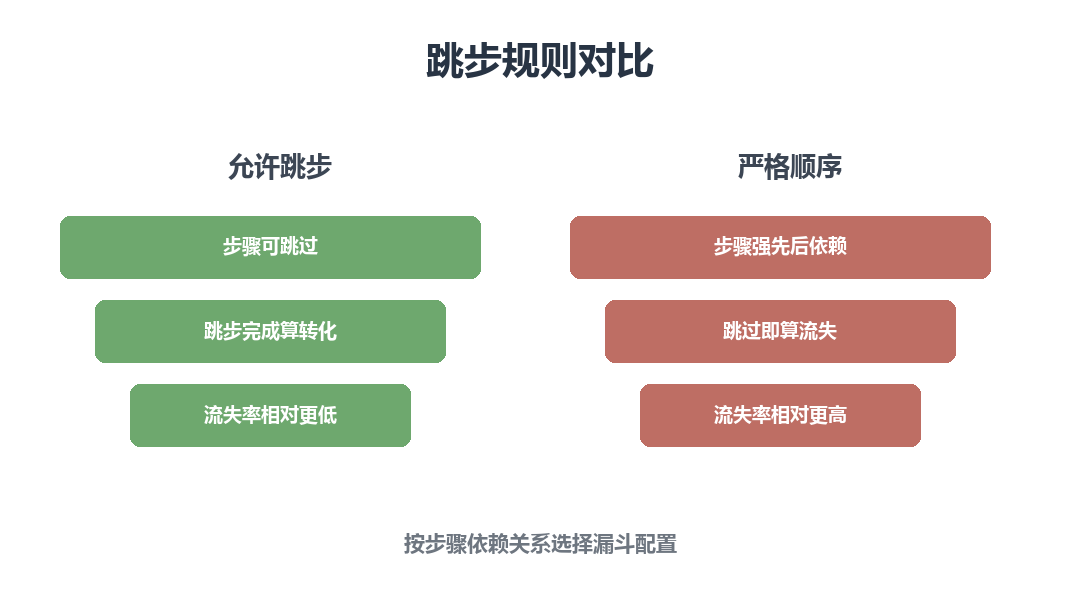 跳步规则对比:允许跳步与严格顺序漏斗
用户不一定严格按步骤顺序走完,因为跳步用户的处理方式直接影响流失率,所以跳步规则要显式定义。
1. 允许跳步的场景
当步骤之间存在可跳过的关系时,例如从落地页直接进入表单页而不看中间介绍页,允许跳步更贴近真实行为。因为跳步用户实际完成了转化,所以这类漏斗配置为允许跳步,避免把已转化用户误判为流失。
2. 严格顺序的场景
当步骤存在强先后依赖时,例如必须先注册才能下单,严格顺序更合理。因为步骤依赖关系决定了顺序约束,所以配置漏斗前先梳理步骤之间的依赖关系,再决定是否允许跳步。
3. 跳步规则的影响说明
跳步规则直接影响流失率数字:允许跳步的漏斗流失率通常更低,严格顺序的漏斗流失率更高。因为两种配置各有适用场景,所以报告转化率时注明漏斗配置,避免团队对数字口径产生误解。
四、看转化分布,定位瓶颈步骤
漏斗建好后,先看整体转化分布:从第一步到终点,每一步的转化率是多少,流失集中在哪一步。
1. 转化分布怎么看
因为漏斗各步转化率通常是逐级递减的,所以关注的重点不是绝对数值,而是相邻步骤之间的落差:某一步骤转化率明显低于前后步骤,该步骤就是瓶颈候选。看落差时建议同时看两个口径:单步转化率与整体转化率。因为单步转化率显示该步骤自身的承接能力、整体转化率显示从起点到该步骤的累计留存,所以两者结合能区分「这一步本身差」与「前面已经把人群筛没了」两种不同情况。
2. 瓶颈步骤的验证
定位瓶颈步骤后,先用路径数据验证:进入该步骤的用户从哪里来,离开后去了哪里。因为瓶颈可能源于前置步骤质量,也可能源于该步骤自身承接问题,所以验证后再决定优化动作。
五、流失归因:从哪一步到哪些人
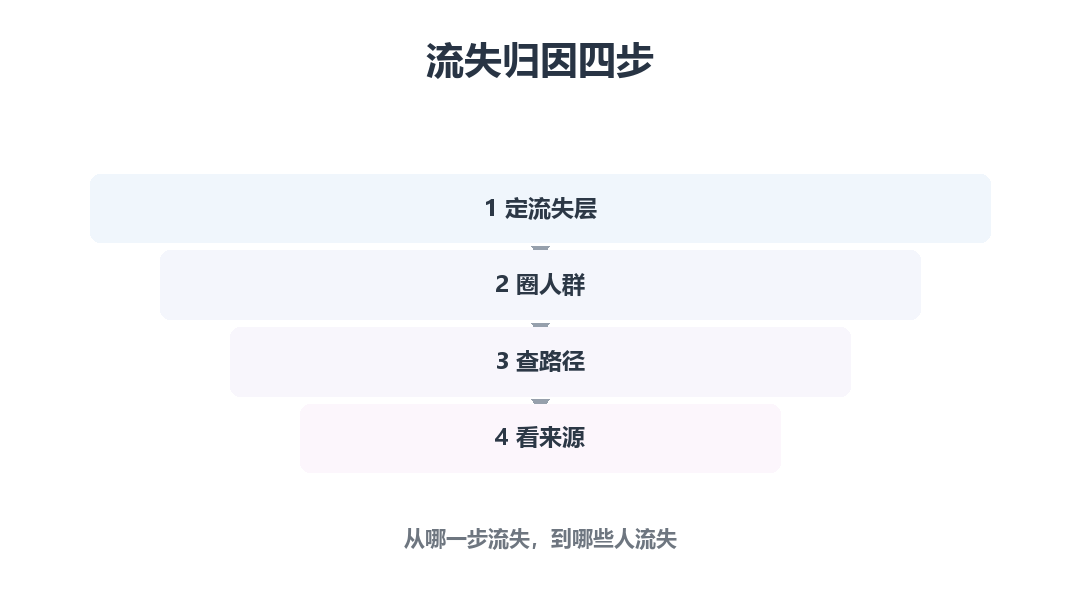 流失归因四步:定流失层、圈人群、查路径、看来源
漏斗只告诉「流失在哪一步」,流失归因要回答「流失的人是谁、为什么」,所以归因按四步推进。
1. 定流失层
先定义要分析的流失层:第几步到第几步之间算流失。因为不同流失层的用户意图不同,所以先圈定流失层,再分析该层用户。
2. 圈人群
用分群把流失层用户圈出来:来源、端类型、行为特征。因为流失用户可能由多个来源构成,所以按维度拆解人群,看流失是否集中在特定人群。
3. 查路径
查看流失用户进入漏斗前的路径:从哪个页面进来、停留多久、是否看过关键内容。因为路径能解释流失原因,所以路径证据优先于主观猜测。
4. 看来源
按来源对比流失率:哪些来源的用户流失率高。因为来源质量直接影响漏斗后续转化,所以来源层证据与路径层证据结合,归因结论更完整。归因时要注意流失用户的时间窗口:流失是进入漏斗后多久内没完成转化。因为窗口长短影响流失人群的圈定范围,所以窗口先按业务节奏定义(例如 24 小时内),再按需调整,避免把窗口外仍会转化的人误算进流失人群。
六、常见问题
问题1:漏斗步骤越多越好吗?
不是。因为步骤过多会放大流失、增加分析噪音,所以中间步骤控制在关键决策点即可,三到五步覆盖核心环节。
问题2:用户跳过了中间步骤,算流失吗?
取决于跳步规则。因为跳步用户可能实际完成了转化,所以配置漏斗时明确跳步规则,避免把已完成转化的用户误判为流失。
问题3:漏斗转化率下降了,一定是产品问题吗?
不一定。因为转化率受来源质量、活动节奏、外部环境多因素影响,所以先按来源与人群拆解,确认波动集中在哪一层,再判断原因。
问题4:流失归因需要哪些数据?
需要路径、来源与分群数据。因为归因要结合行为顺序与人群特征,所以先确认相关事件已埋,再开展归因分析。
七、小结与来源
建立转化漏斗,步骤设计比数字更重要:先定起点与终点定义漏斗边界,再按行为顺序拆分中间步骤,显式定义跳步规则,看转化分布定位瓶颈,最后做流失归因指导优化。因为步骤定义决定流失率含义,所以每一步都按产出物核对,漏斗才能真正指导优化动作,而不是停留在「转化率是多少」的展示层面。