首屏加载性能持续监控:456数据技术实践指南
首屏加载性能不是一次性测试,而需要以真实用户数据为基础、按 P75 分位数持续监控。本文由我们的工程团队整理,说明监控什么指标、用什么数据、怎么采集,以及如何搭建看板与告警。
首屏加载性能直接决定用户对网站的第一印象,也影响留存与转化。一次性的实验室测试只能给出某个时刻的切片,无法反映真实用户在不同网络、设备、地域下的持续体验。我们的前端性能监控实践,是以 RUM 真实用户数据为基础,盯住 LCP、INP、CLS 三大 Core Web Vitals 指标,并按 P75 分位数持续判断好坏。我们把这套采集与看板能力做成了开箱即用的产品,5 分钟即可接入。
一、为什么必须「持续」监控,而不是测一次
首屏性能不是一个静态值。它会随版本发布、第三方脚本、CDN 缓存、用户网络与设备分布、乃至当日热点流量持续波动。上线前在实验室环境里跑一次 Lighthouse,得到的是「受控条件下的基线」,并不等于线上真实用户的体验。
真正需要回答的问题是:
- 新版本发布后,LCP 是变好了还是退化了?
- 某款低端安卓机型在 4G 网络下,CLS 是否异常?
- 某次营销活动带来流量高峰时,接口超时是否拖累了首屏?
这些问题只有靠持续采集真实用户数据才能回答。一次性测试看不到趋势,也定位不到维度下的退化点。
二、监控对象:Core Web Vitals 与 P75 阈值
Google 提出的 Web Vitals 中,与首屏体验直接相关的是三个 Core Web Vitals 指标:
- LCP(Largest Contentful Paint,最大内容绘制):首屏视口内最大内容元素完成渲染的时间,对应「主要内容多久出来」。
- INP(Interaction to Next Paint,交互到下一次绘制):衡量用户从输入到浏览器完成绘制的延迟,反映交互流畅度。INP 于 2024 年 3 月正式取代 FID(首次输入延迟),成为 Core Web Vitals 的一员。
- CLS(Cumulative Layout Shift,累积布局偏移):统计加载过程中非预期的布局位移,例如文字被广告位顶开。
三者分别覆盖加载、交互、稳定性三个维度。按 web.dev 官方定义,「良好」阈值如下表(以 P75 分位数衡量):
| 指标 | 良好(Good) | 待改进(Ni) | 较差(Poor) |
|---|---|---|---|
| LCP | ≤ 2.5s | 2.5s – 4.0s | > 4.0s |
| INP | ≤ 200ms | 200ms – 500ms | > 500ms |
| CLS | ≤ 0.1 | 0.1 – 0.25 | > 0.25 |
三大指标的良好阈值与口径,如下图所示。
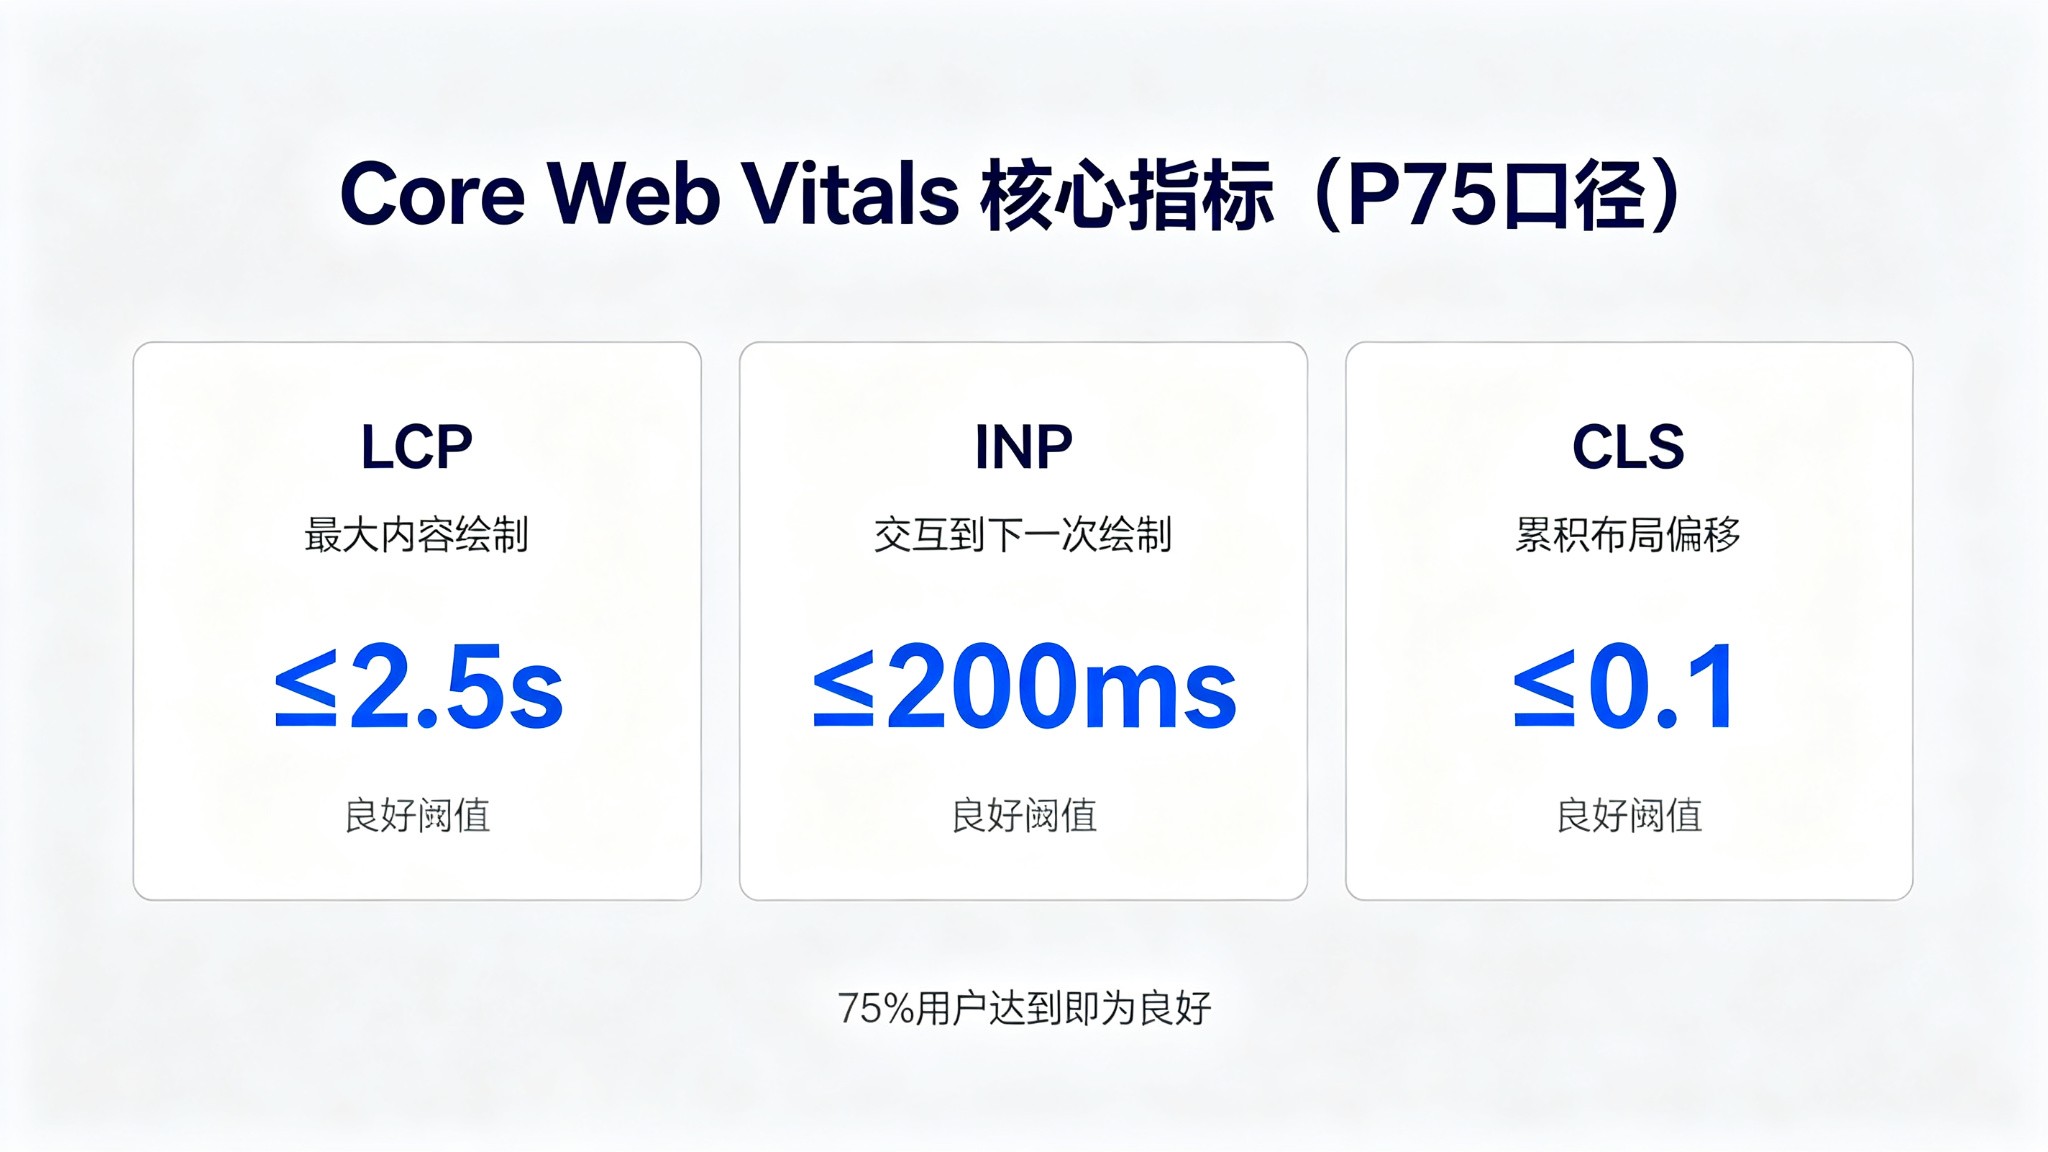 图 1:三大 Core Web Vitals 指标及其「良好」阈值(P75 口径)
三、RUM 与合成监控:分工与互补
持续监控通常由两类数据共同构成,二者回答的问题不同,不能互相替代。
RUM(Real User Monitoring,真实用户监控)
直接采集真实用户在生产环境中的访问数据,覆盖真实地区、设备、浏览器与网络。它告诉我们「用户实际体验到了什么」。局限是:数据依赖真实流量、属于事后观测,且需在隐私合规前提下采集。
合成监控(Synthetic / Lab 数据)
用脚本化探针在固定环境、固定地点定时模拟访问,适合做可用性巡检、上线前基线校验与主动告警。局限是:环境受控、只覆盖脚本定义的路径,无法代表长尾真实用户。
我们的实践是:合成监控负责「主动发现故障与基线漂移」,RUM 负责「刻画真实用户体验与分位数分布」。前者像定时体检,后者像持续监护,二者配合才能既不遗漏突发故障,又不被实验室数据误导。
四、采集实现:PerformanceObserver API 与 SDK
浏览器原生提供了 PerformanceObserver API 来监听性能条目。以 LCP 为例,标准采集写法如下:
new PerformanceObserver((list) => {
  const entries = list.getEntries();
  const last = entries[entries.length - 1];
  // last.startTime 即当前 LCP 候选时间
}).observe({ type: 'largest-contentful-paint', buffered: true });
几个工程细节值得注意:
- entry type 要对得上:LCP 用
largest-contentful-paint,CLS 用layout-shift,INP 用event并在内部聚合长任务与交互耗时。 buffered: true不能省:它会补回观察者注册前已经发生的条目,避免首屏早期数据丢失。- 上报时机:通常在页面
visibilitychange变为 hidden 时统一上报,兼顾数据完整性与传输开销。
Google 官方维护的开源 web-vitals 库对 LCP、INP、CLS 做了标准封装,是 RUM 采集侧广泛参考的实现口径;接入时通常直接复用其上报逻辑,避免自行计算带来的口径偏差。完整采集与处理链路,如下图所示。
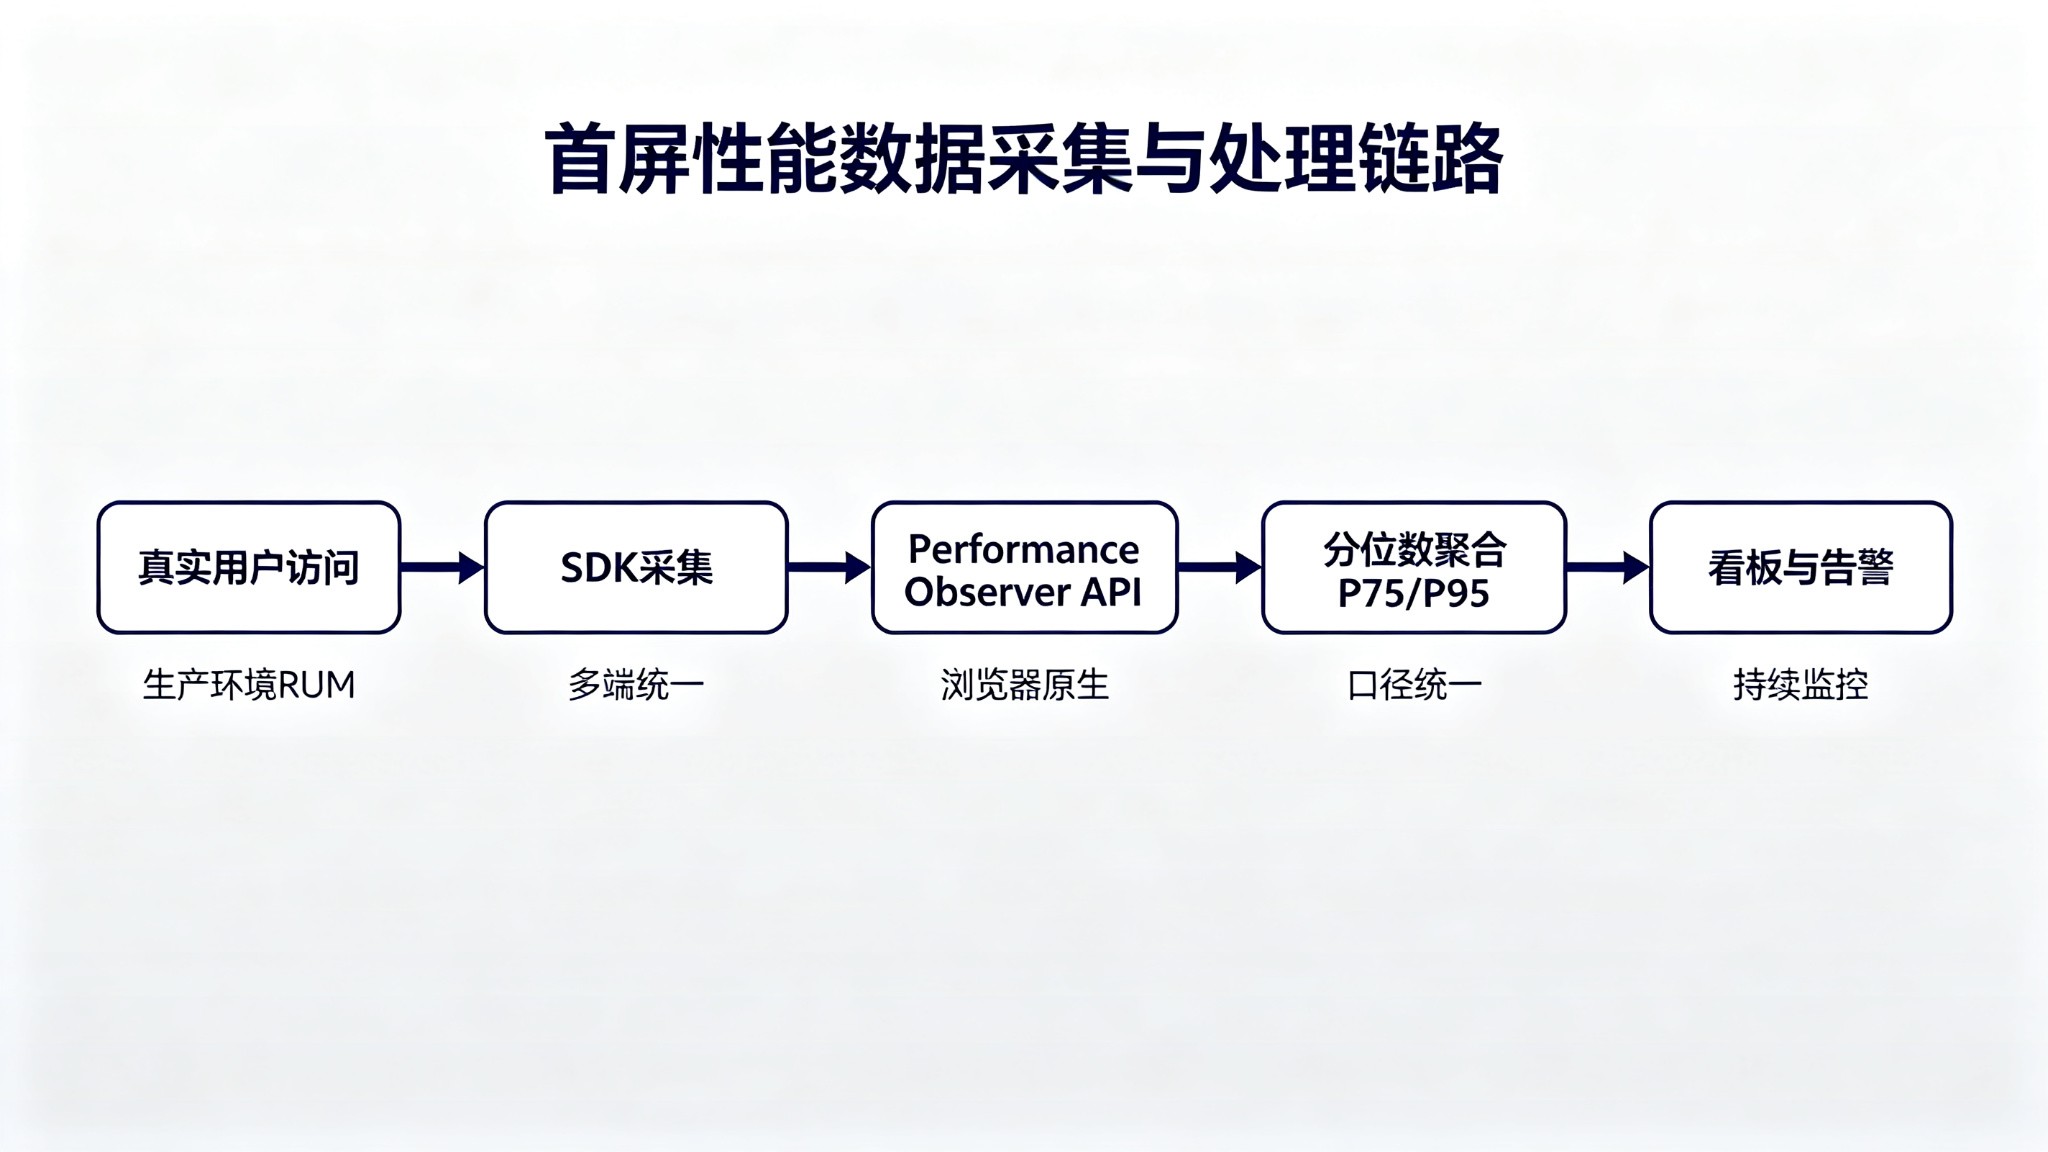 图 2:从真实用户到看板告警的采集与处理链路
多数团队不会从零手写这套采集与上报管道。我们将其封装为一套SDK,覆盖网站、App、小程序,业务数据与性能数据打通,前端性能监控可直接定位卡顿、报错与接口超时,5 分钟即可接入。
五、分位数口径:为什么用 P75,何时看 P95
平均值是持续监控里最常见的陷阱。假设 90% 的用户 LCP 为 1.5s,10% 的弱网用户为 10s,平均值看似正常,实则相当一部分用户体验已经很差。
- P75:Web Vitals 官方推荐的达标口径。把所有样本从小到大排序,取第 75 百分位,对应「大多数用户的真实感受」。
- P95:很多团队额外把 P95 作为内部 SLO,用来盯最差的 5% 用户。P75 达标但 P95 仍在恶化,说明长尾正在变差。
六、看板与告警的搭建思路
采集和聚合只是起点,真正让监控「持续有效」的是看板与告警。我们建议按三层搭建:
- 核心指标层:LCP、INP、CLS 的 P75/P95 卡片,以及错误率、接口超时率,一眼看健康度。
- 趋势与下钻层:近 7~30 天趋势,支持按地区、设备、浏览器、网络、页面版本下钻,定位退化集中在哪个维度。
- 告警闭环层:阈值告警(P75 越线)、环比异动(同比/环比突增)、发布回归(新版本 vs 上版本)。告警触发后结合卡顿、报错、接口超时数据定位根因,修复后再回看趋势是否回升。
持续监控大盘的典型形态,如下图所示。
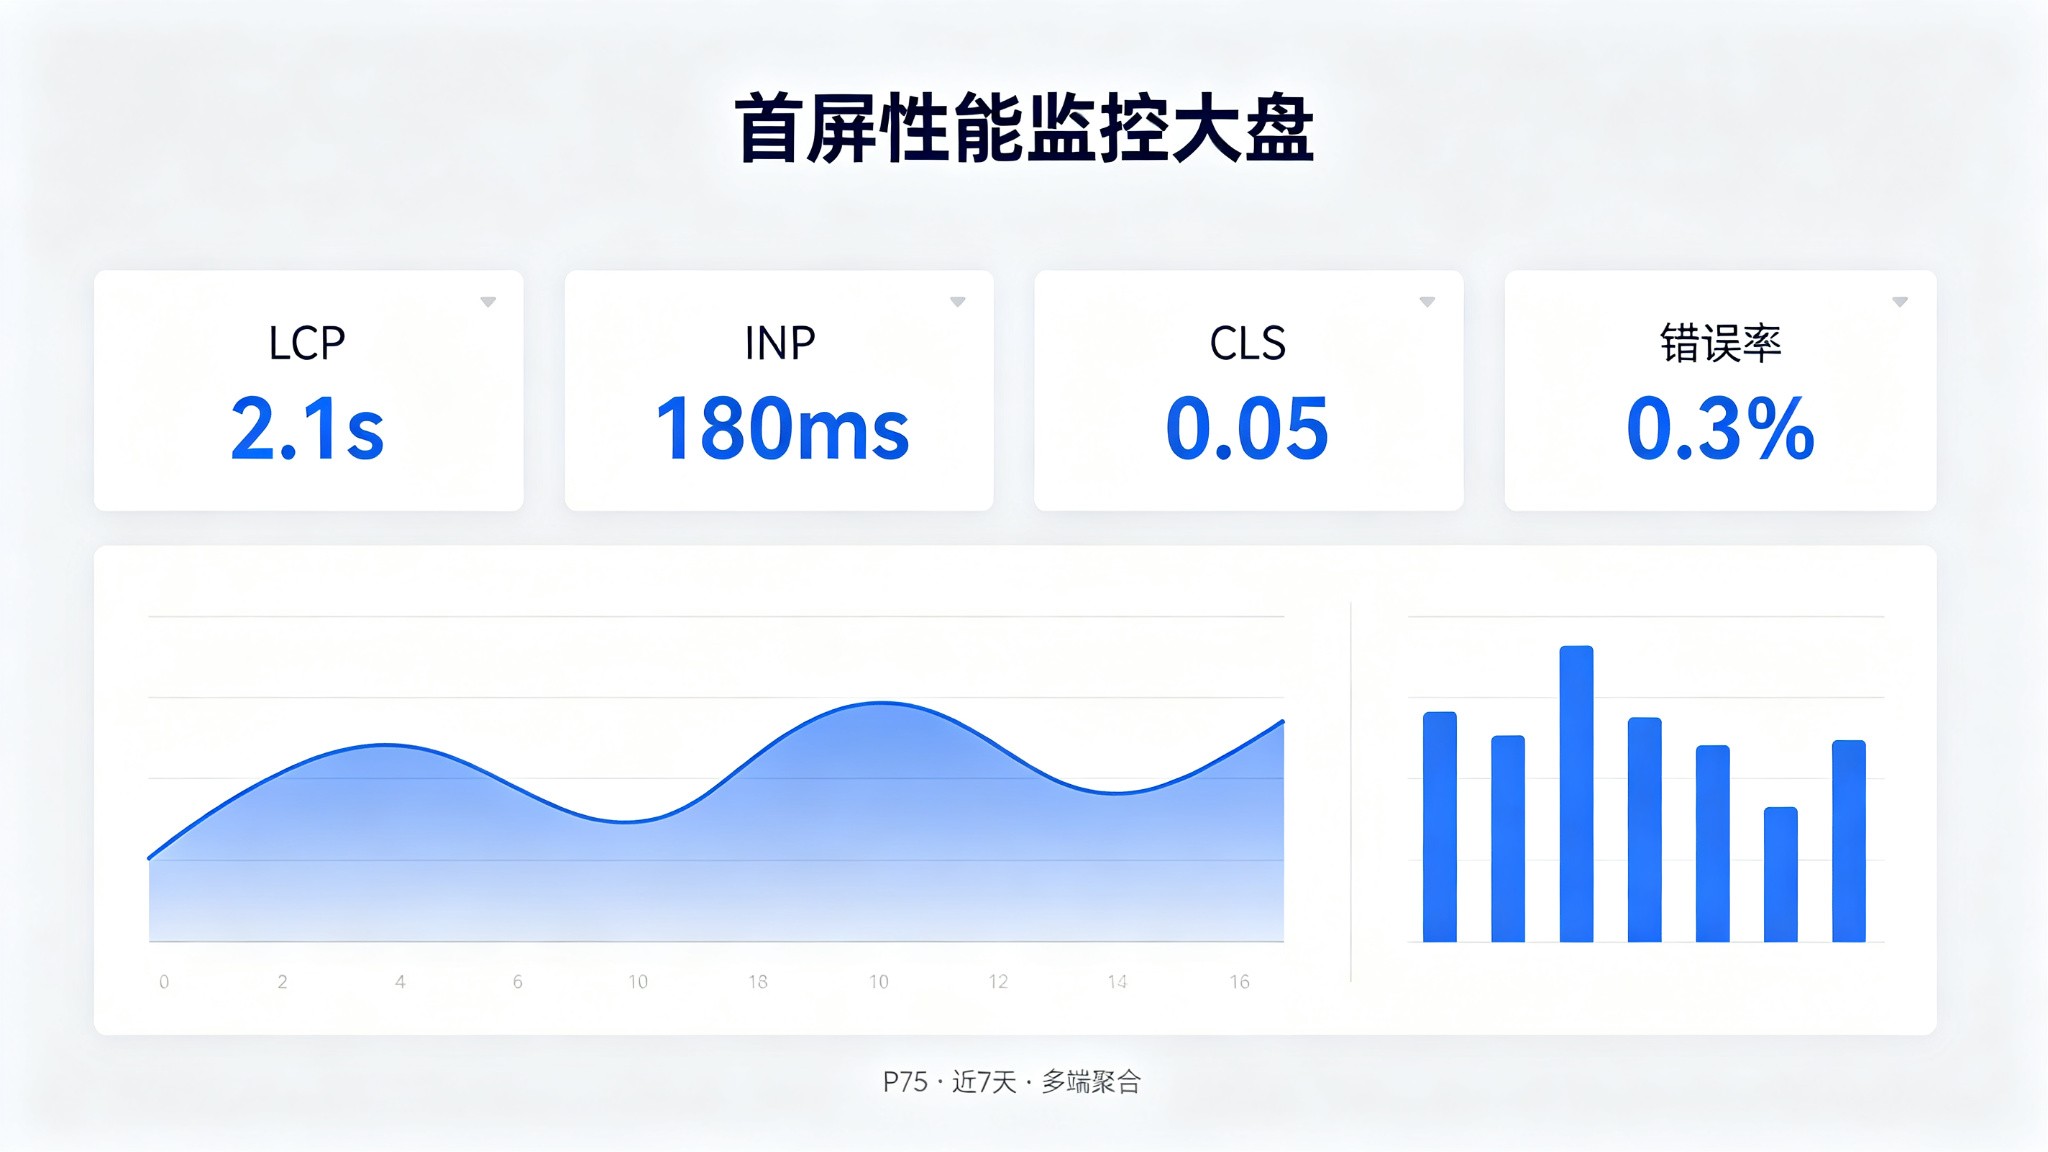 图 3:持续监控大盘示意(指标卡片 + 趋势 + 下钻)
另一个关键动作是把性能数据和业务数据放在一起看。如果 LCP 变差的页面恰好转化率也在下滑,性能劣化就不只是技术债,而是业务损失。这也是我们在产品里强调业务数据与性能数据打通的原因。
七、常见工程误区
误区一:只看平均值。平均值掩盖尾部用户,必须看 P75/P95。
误区二:用 lab 数据替代 field 数据。Lighthouse 适合做基线与优化方向,不能代表真实用户分布。
误区三:忽略采样对分位数的影响。小样本或混合采样会让 P75 失真,需要统一口径并按窗聚合。
误区四:达标即结束。阈值是底线不是目标,P75 刚过 2.5s 与稳定在 1.5s,用户感受差别明显。
八、我们在这件事上的能力
作为全端数据分析与性能监控平台,我们的定位是「网站、App、小程序,一站看懂」。围绕首屏性能持续监控,我们提供:
- 前端性能监控:定位卡顿、报错、接口超时;
- 一套SDK,覆盖网站、App、小程序,业务数据与性能数据打通;
- 可视化看板零门槛,P75/P95 指标开箱即看;
- 5 分钟快速接入,7×24 小时服务。
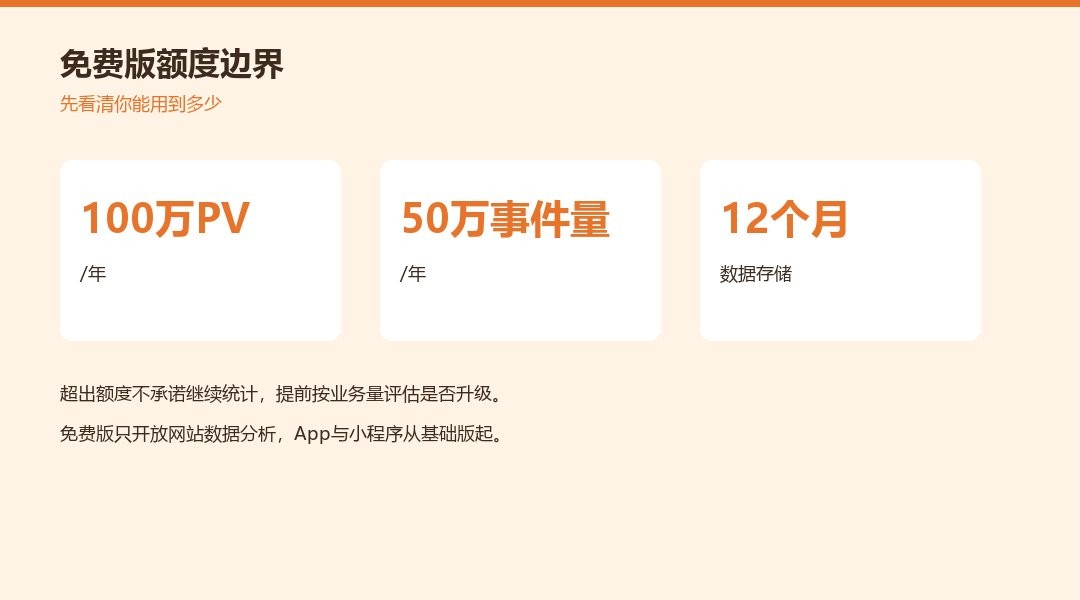
定价上,免费版覆盖 100 万 PV / 50 万事件量每年,适合中小站点先跑通;基础版 99 元/年,专业版与企业版面向更高流量与团队协作需求。我们服务个人站长、互联网产品团队、电商零售、数字化营销等行业用户。
总结
首屏加载性能的持续监控,本质是三件事:用 Core Web Vitals(LCP / INP / CLS)定义好坏,用 P75(必要时 P95)作为统一分位数口径,用 RUM 加合成监控的组合覆盖「真实体验」与「主动告警」。一次性测试只能看到一个切面,持续监控才能随版本、随用户分布发现退化。工具可以选我们这样的平台快速接入,但监控口径、分位数定义与告警闭环,仍需要团队先想清楚。