JS错误告警总刷屏怎么办?456数据降噪指南
很多站长和运营都遇到过这样的场景:一上线错误监控,群里就开始不停弹窗,结果大家慢慢就不看了;等到真正的大故障发生,那条通知反而沉在消息列表里,没人及时发现。我们在前端性能监控的实践中发现,问题往往不在于监控不够灵敏,而在于通知没有做筛选。下面用业务能听懂的方式,讲清楚告警怎么设才不吵又有用。
一、告警太多,等于没告警
按 Google SRE 的理念,每一次叫醒人的告警都应当有人立刻响应、并且能据此采取动作;如果通知多到大家开始随手划走,真正严重的那条也会一起被忽略。Google 自己的团队就曾因为告警量过大,花大量时间翻找通知,反而漏掉了真正影响用户的问题。
这就是常说的「告警疲劳」:不是监控没起作用,而是噪音太多,把信号盖住了。对业务来说,代价很直接——故障发现变慢、处理变晚、用户流失。
二、怎么分级:影响越大、越久,才越值得叫醒人
合理的分级只看三件事,不用记复杂参数:
- 影响多少用户:同一个报错只影响一两个访客,和影响成千上万访客,完全不是一回事。
- 错误有多严重:是页面打不开、下单付不了款这类关键问题,还是某个边缘小功能报错。
- 持续了多久:报错闪一下就自己恢复,和持续刷屏,处理优先级也不同。
原则很朴素:偶发、只影响个别用户的,记录在看板里就好,不必打扰人;影响面大、错误率高、又持续存在的,才升级为紧急通知,叫人立刻处理。下面这张决策图把判断路径画了出来,如下图所示。
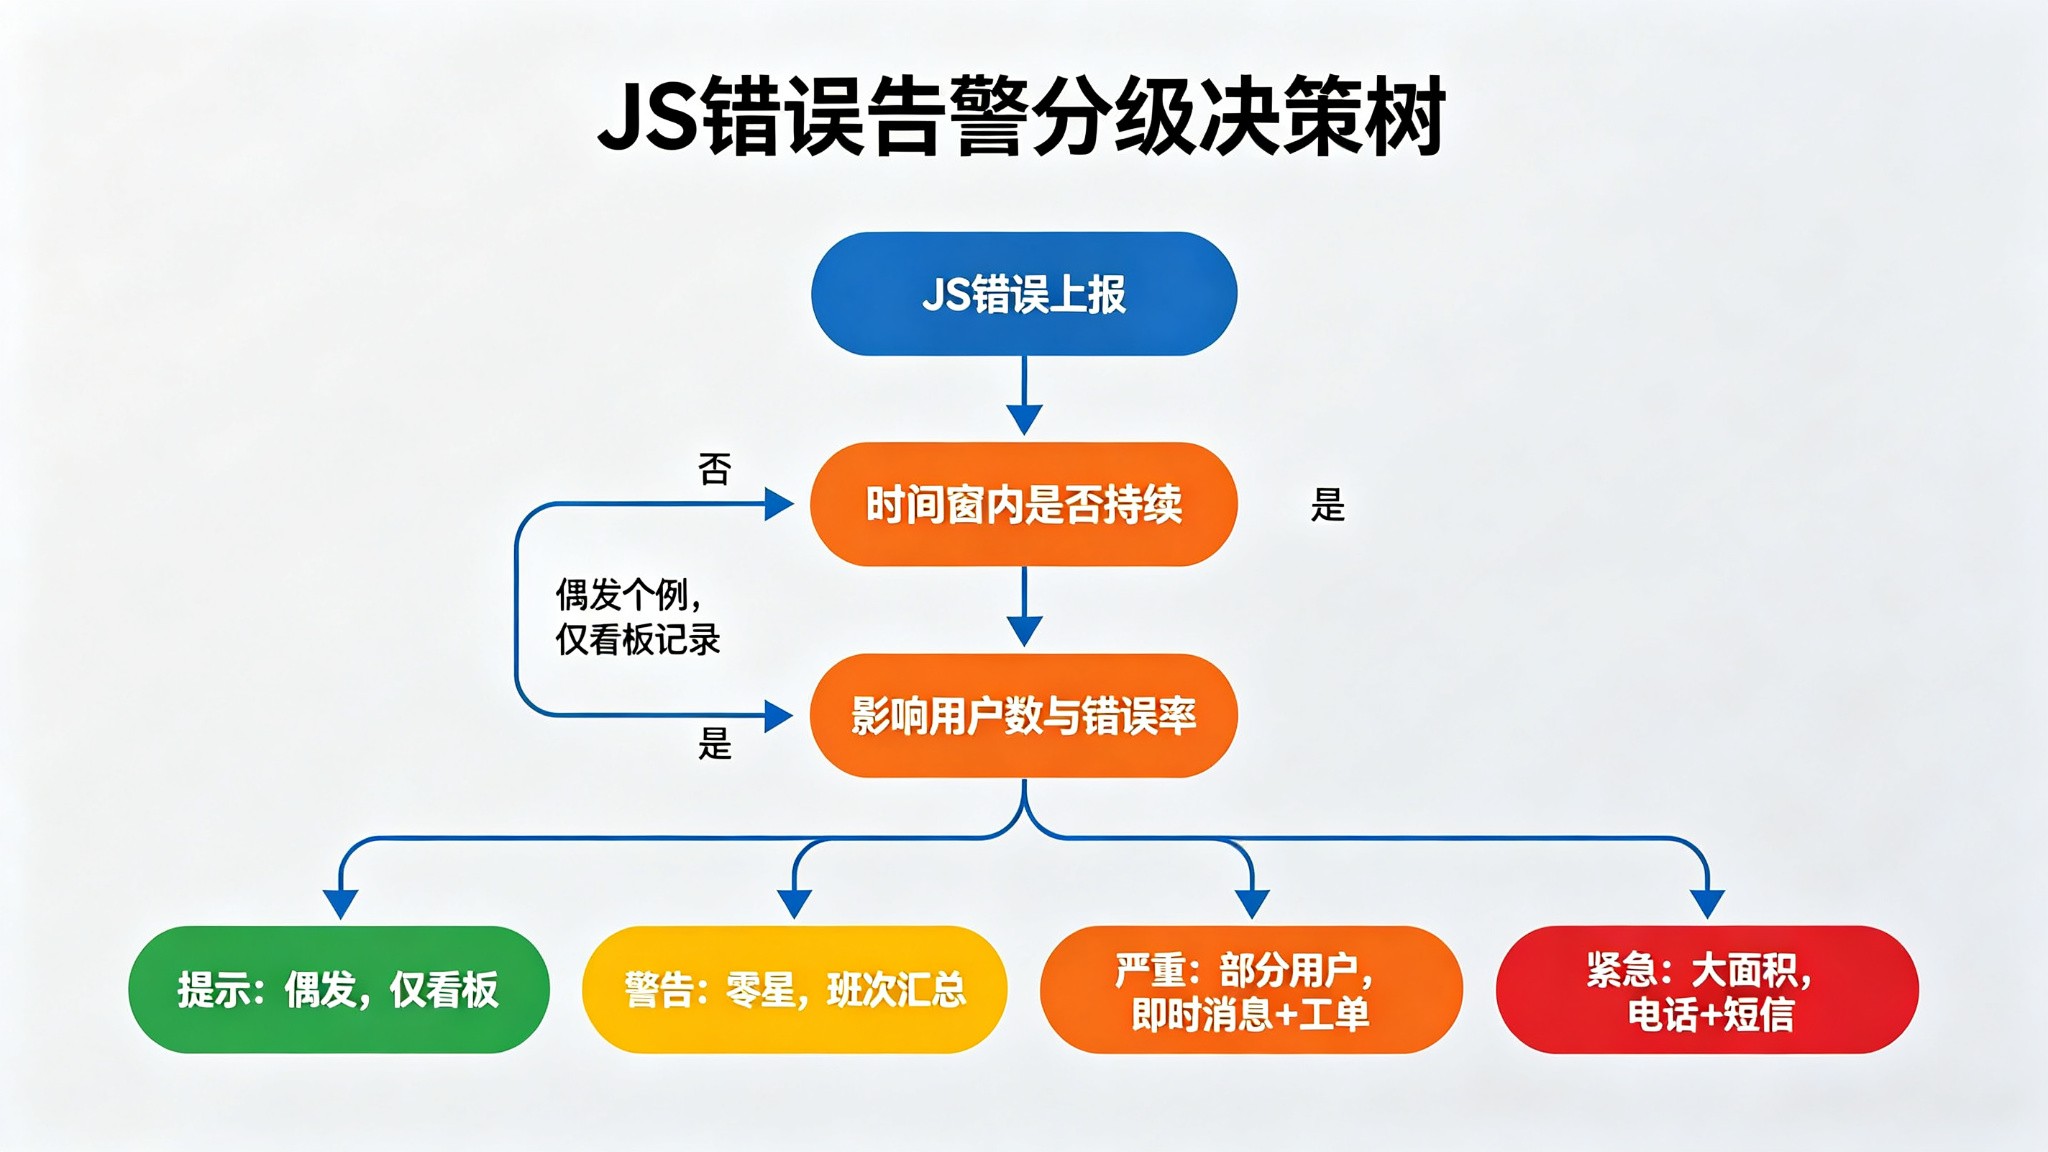 图1:按「是否持续 + 影响多大」分流的告警分级决策
三、降噪三招:让通知变少,但更准
分级之外,还有三件事能把通知量降下来,同时不漏掉真问题:
- 合并同类报错:同一个原因引起的成百上千条报错,合并成一条通知,而不是每弹一条都叫人。
- 阈值跟着业务基线走:不要拍脑袋定死一个数字,而是和自己平时的错误水平比,明显超出平时才提醒。这样业务淡旺季、活动流量变化都不会误报。
- 已知噪音先屏蔽:计划内的发布维护、已经知道在修的问题,暂时屏蔽通知,别让它们每次都刷屏。
这三步连起来,就是一条从「满屏报错」到「只通知真问题」的收敛过程,如下图所示。
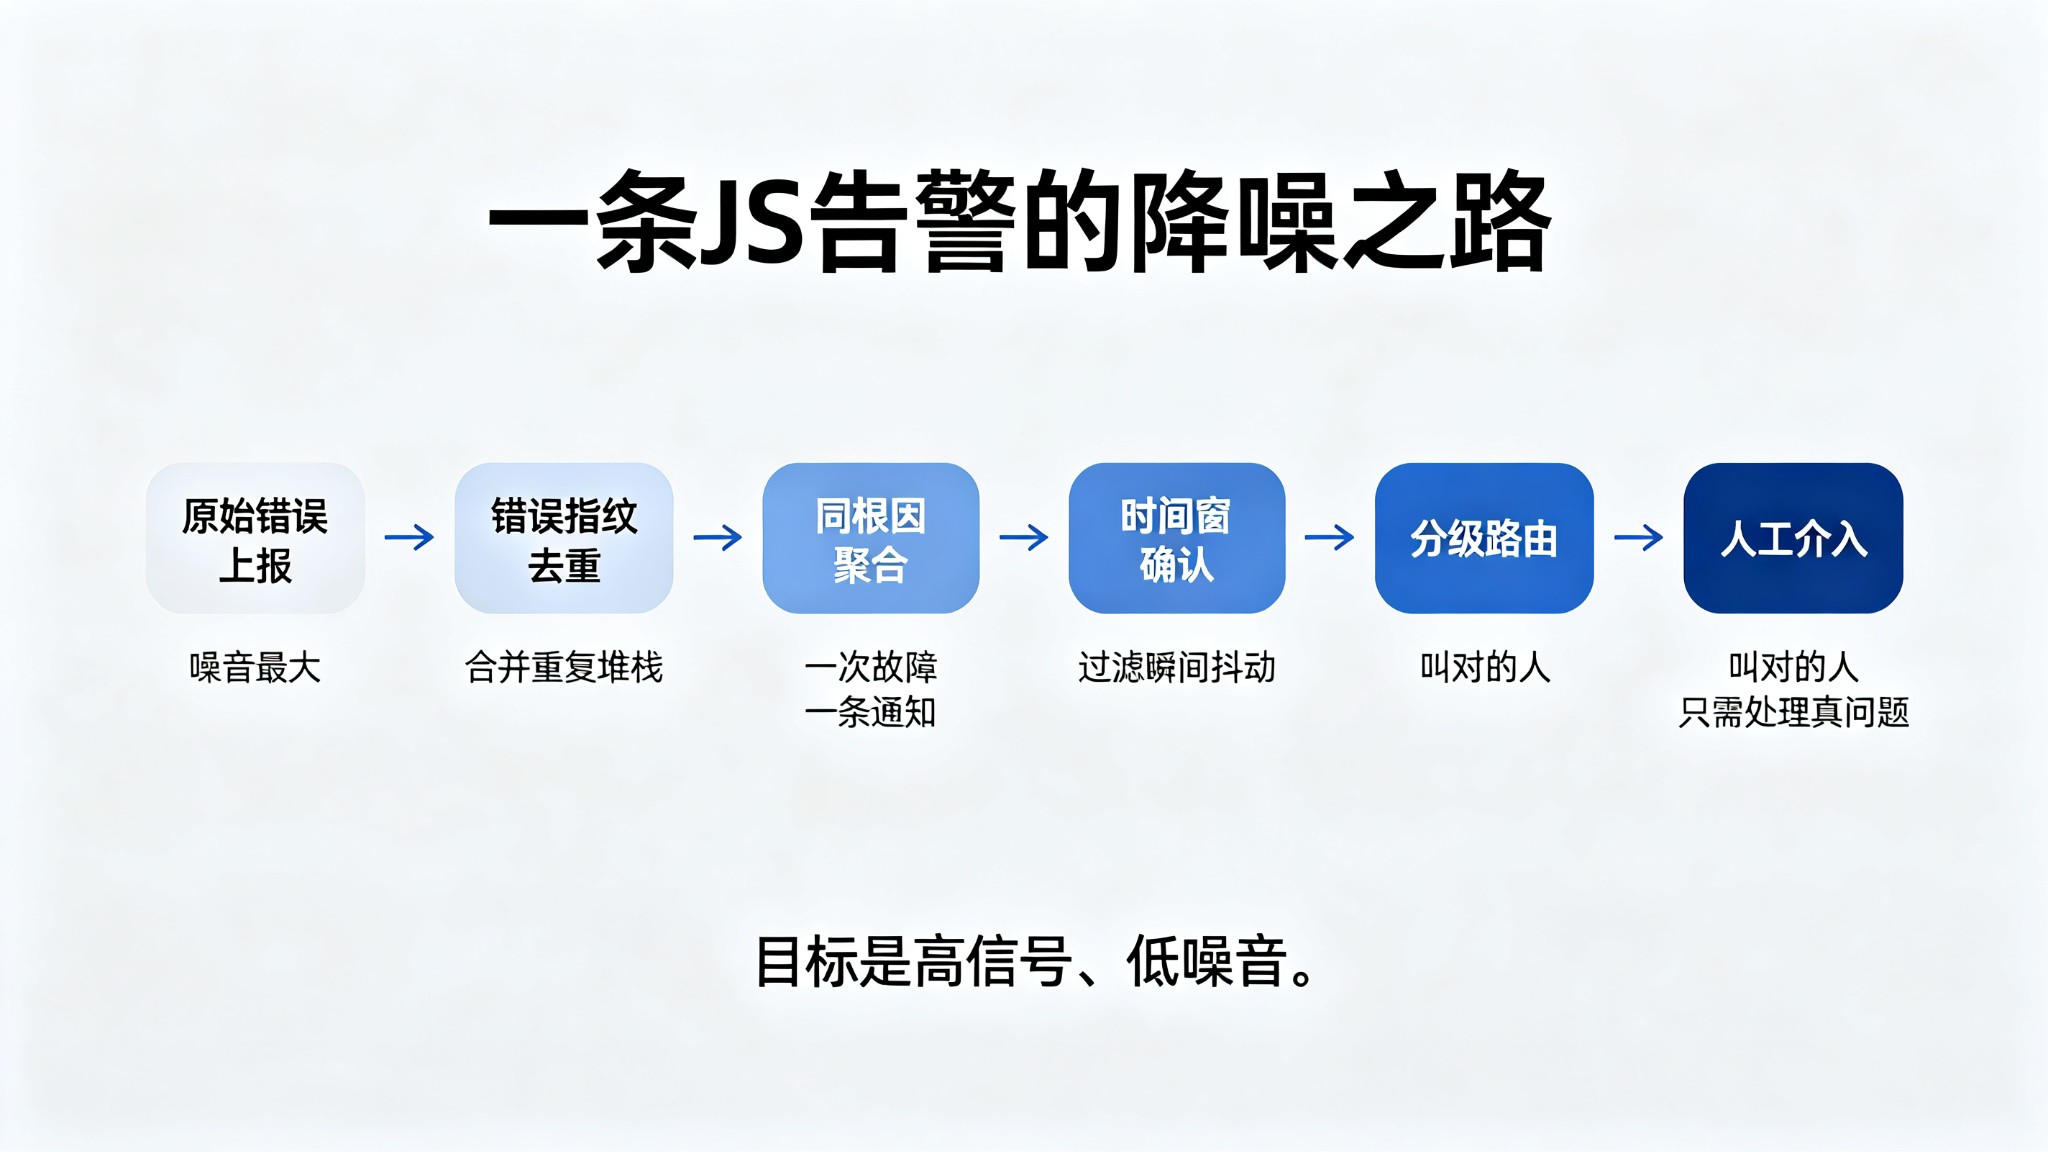 图2:一条告警从报错上报到通知人的降噪过程
四、拿不准阈值怎么办:先跑一两周再调
很多团队一上来就想把数字定得死死的,结果不是误报太多就是漏报。我们更建议的做法是:先不急于设硬性数字,让系统按自己业务的历史基线跑一两周,看看平时错误率大概什么水平、什么波动算正常,再据此微调分级。
告警策略不是一次设好就不动的,它应该跟着业务一起长大——流量涨了、改版了、上了新功能,都可以回来重新看一眼基线。
五、一张表看懂:什么情况通知谁
把上面的思路落成一张业务能直接用的表,参考如下(具体程度按自己业务调):
| 等级 | 什么情况 | 通知谁、怎么通知 |
|---|---|---|
| 提示 | 偶发、只影响个别用户,不影响主流程 | 只在看板记录,不打扰人 |
| 警告 | 错误缓慢上升,还能等一等 | 群消息 + 每天汇总一次 |
| 严重 | 明显影响一部分用户 | 即时消息 + 建单,当天处理 |
| 紧急 | 大面积报错、页面打不开或核心功能不可用 | 电话/短信,立即响应 |
四级的直观对照如下图所示。
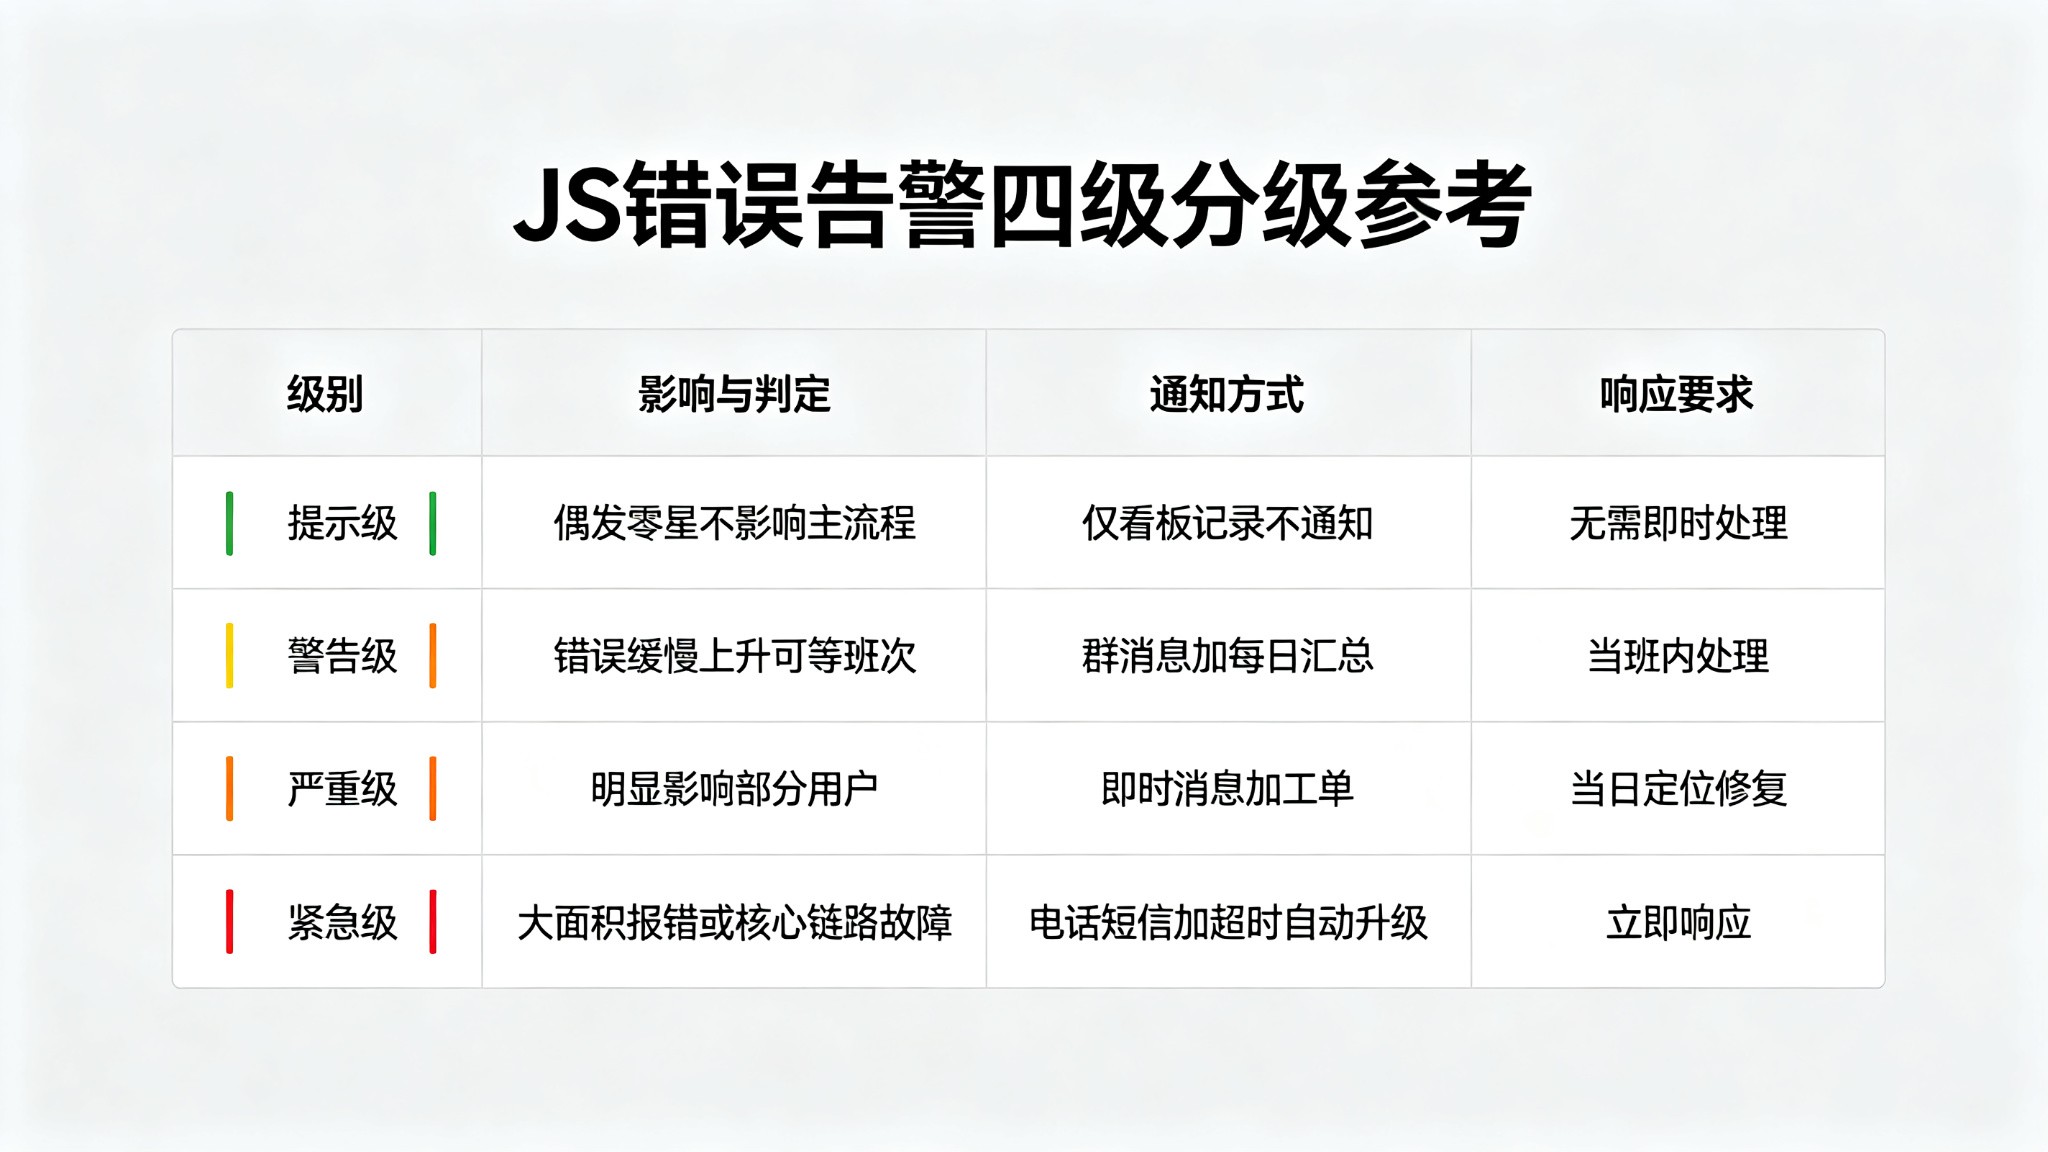 图3:四级告警的参考分级
六、我们能帮你做什么
456数据是全端数据分析与性能监控平台,定位为「网站、App、小程序,一站看懂」。在前端性能监控方面,我们帮助团队定位页面卡顿、报错和接口超时,并把业务数据和性能数据放在同一块可视化看板上,不用在多个系统之间来回切换。
接入上我们强调一套SDK,覆盖网站、App、小程序,5分钟快速接入,看板零门槛,并提供数据合规安全保障与7×24小时服务。定价上有0元/月的免费版起步,需要更大流量再按规模升级。服务对象上,我们服务个人站长、互联网产品团队、电商零售、数字化营销等行业用户。
总结
告警要有用,关键不是报得多,而是报得准:影响面大、持续、严重的才叫醒人;同类报错先合并,阈值跟着业务基线走,已知噪音暂时屏蔽。先让通知变少、变准,团队才不会在刷屏里麻木,真正的故障才能被及时发现和处理。