统计数据为何总对不上?456数据官方拆解6类口径差异
同一时间窗口、同一批访问,A工具和B工具报出的PV、UV、Session数却不一致——这是我们在对接客户过程中最高频的咨询问题。本文从官方视角,把导致统计数据对不上的六类口径差异逐条拆解,并给出可直接落地的排查路径。
核心结论:不同统计工具之间的数字差异,绝大多数不是「谁算错了」,而是「各自按各自的口径在算」。会话怎么切、机器人怎么滤、大流量采不采样、用户同意怎么处理、时区和归因窗口怎么设、跨端怎么去重——任何一条规则不同,最终报表都会出现可观测的偏差。下面我们按影响面从大到小展开。
整体上,导致数据对不上的来源可以归纳为六大类,如下图所示。
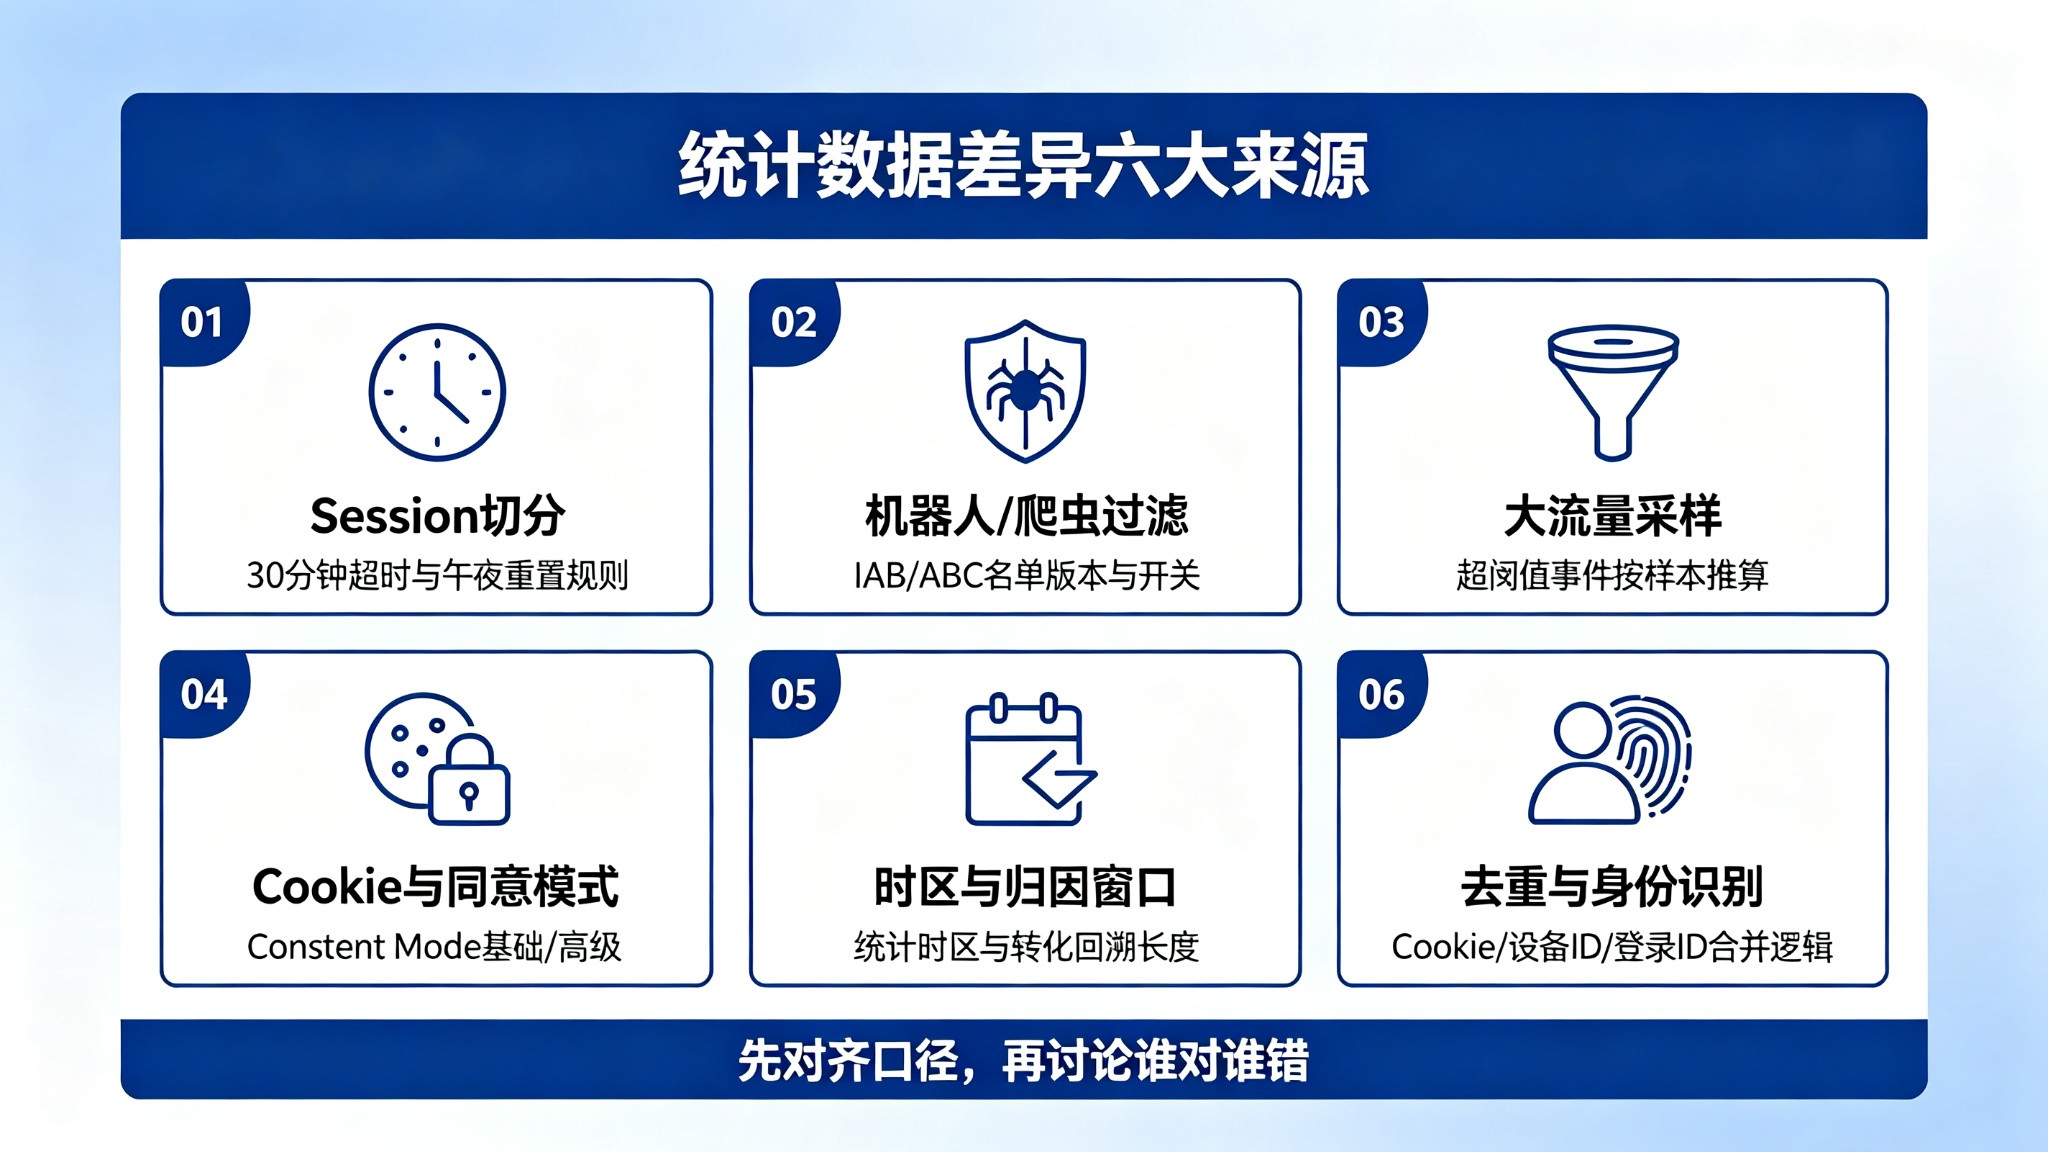 图1:统计数据对不上的六大来源总览
一、Session:30分钟超时与午夜重置
Session(会话)是绝大多数前端统计工具的基础聚合单位。按Google Analytics官方帮助文档《About Analytics sessions》的定义,一次Session是用户与网站/应用发生交互的一段连续时间,默认在用户无活动30分钟后超时结束;Google Developers在《Measure sessions and engagement》中进一步说明:Session统计的是某条页面路径至少被加载一次的独立时段,而Pageview(PV)统计的是该路径被加载的累计次数。
两个工具的Session数对不上,常见来源有三:
- 无活动超时阈值不同。主流工具默认30分钟,但可被运营配置为15分钟、60分钟。同一用户中途离开25分钟再回来,在A工具算同一次Session,在B工具可能拆成两次。
- 午夜是否重置。Google历史版本Universal Analytics会在属性所在时区的午夜切断Session;按GA4官方与多家技术博客的对比,GA4默认不再在午夜重置Session,也不在中途切换广告参数时新开一次Session。这意味着从UA迁到GA4,历史Session数对不齐是预期行为。
- 前后端上报事件顺序。页面跳转过快、网络抖动导致
session_start事件晚于首个Pageview到达,部分工具会把这次访问归到上一次Session里,造成归属错位。
// 典型Session切分逻辑(伪代码)
if (now - lastEventAt > 30min) {
    startNewSession();
}
// GA4 默认:不在午夜自动截断
// 旧版UA默认:午夜截断一次
二、UV与去重:Cookie、设备ID、登录ID
UV(独立访客)是最容易「同名不同义」的指标。两个工具都报UV,但底层去重依据可能完全不同:
- 仅第一方Cookie:清一次缓存、换一个浏览器,就会被重新计为新访客。
- 设备ID为主:App端常见,同一台手机上不同浏览器仍算同一个人,但换手机就断开。
- 登录ID打通:用户登录后把匿名ID与账号ID合并,跨端访问能归到同一个人;未登录访问仍是匿名。
因此,UV对不上时,先不要怀疑埋点漏报,先确认两边「凭什么判定这是同一个人」。一家工具只靠Cookie,另一家接入了登录态,后者的UV通常显著更低——这是去重更严格,而不是统计不全。
三、机器人与爬虫过滤:IAB/ABC Bots List
这是我们在后台帮客户排查时第二高频的原因。
GA4默认启用「排除已知漫游器和机器人」(Exclude known bots and spiders),其底层依赖由IAB Tech Lab维护的IAB/ABC International Spiders and Bots List。该名单通过User-Agent等特征识别自动访问,IAB Tech Lab官网显示最近一次更新为2025年4月24日。
需要明确边界:
- 这份名单只能过滤「自报家门」的已知机器人——搜索引擎爬虫、监控探针、官方验证工具;伪装成正常Chrome的无头浏览器、数据中心IP段的自动化脚本,仍会落到Session里。
- 不同工具接入的名单版本、更新频率、开关默认值不同;服务器日志、CDN控制台、第三方统计面板往往把爬虫请求全部计入「请求数」,而前端JS工具会过滤掉一部分,两边数字天然不在一个口径上。
四、采样:什么时候报表已经不是全量
流量一大,很多工具不会把每一条事件都算进报表,而是抽样推算。按Google Analytics Data API官方文档,当一次查询覆盖的事件量超过阈值时,GA4会对结果做采样,报表上会出现黄色采样提示,并标注本次使用了多大比例的事件样本;GA4 360版本通过 samplingLevel 字段支持更高的采样上限。多家第三方技术资料普遍指出,GA4标准属性在Exploration(探索)查询覆盖超过1000万事件时会启用采样。
采样带来的直接影响:
- 同一时间窗口,缩短日期范围和拉长日期范围,算出来的比率可能不一致。
- 分母大、分子小的细分指标(例如某个冷门渠道的转化率),抽样误差会被放大。
- A工具全量计算、B工具抽样推算,数字对不上属于预期,不是bug。
五、Cookie与Consent Mode
这一类差异在面向欧洲用户、做跨境业务的站点上尤其明显。按Google官方对同意模式(Consent Mode)的说明:
- 基础实现(Basic):用户未同意前,Google标签完全不加载,后台从该用户身上收不到任何数据。
- 高级实现(Advanced):标签始终加载,根据用户同意状态调整上报行为,并用建模数据补齐未观测到的部分。
对统计工具对比的影响:一个工具走基础同意模式、另一个走高级模式,未同意用户的覆盖比例完全不同;未接入CMP(同意管理平台)的站点,在GDPR适用地区本身就会系统性低估流量。此外,浏览器对第三方Cookie的限制(如ITP类策略)会让跨站识别失败,老访客被重新算成新用户,UV被抬高。
六、时区与归因窗口
这是最容易让「今天的数据对不上」的一类。Google搜索中心官方文档在解释Search Console与GA数据差异时明确写到:Search Console使用太平洋时间(PT)且无法自定义时区,而GA属性可设置为站点面向的时区。如果站点面向中国大陆用户,GA设为UTC+8,而Search Console仍是PT,那么「今天」在两个工具里根本不是同一段时间。
归因窗口同理。按多家营销技术博客的公开说明,Google Ads默认使用最长30天的点击归因窗口,Meta默认是7天点击+1天浏览。同一个转化,在A工具的回溯窗口内、在B工具的窗口外,两边转化数自然对不上。
把上述六类差异落到一张对照表上,如下图所示。
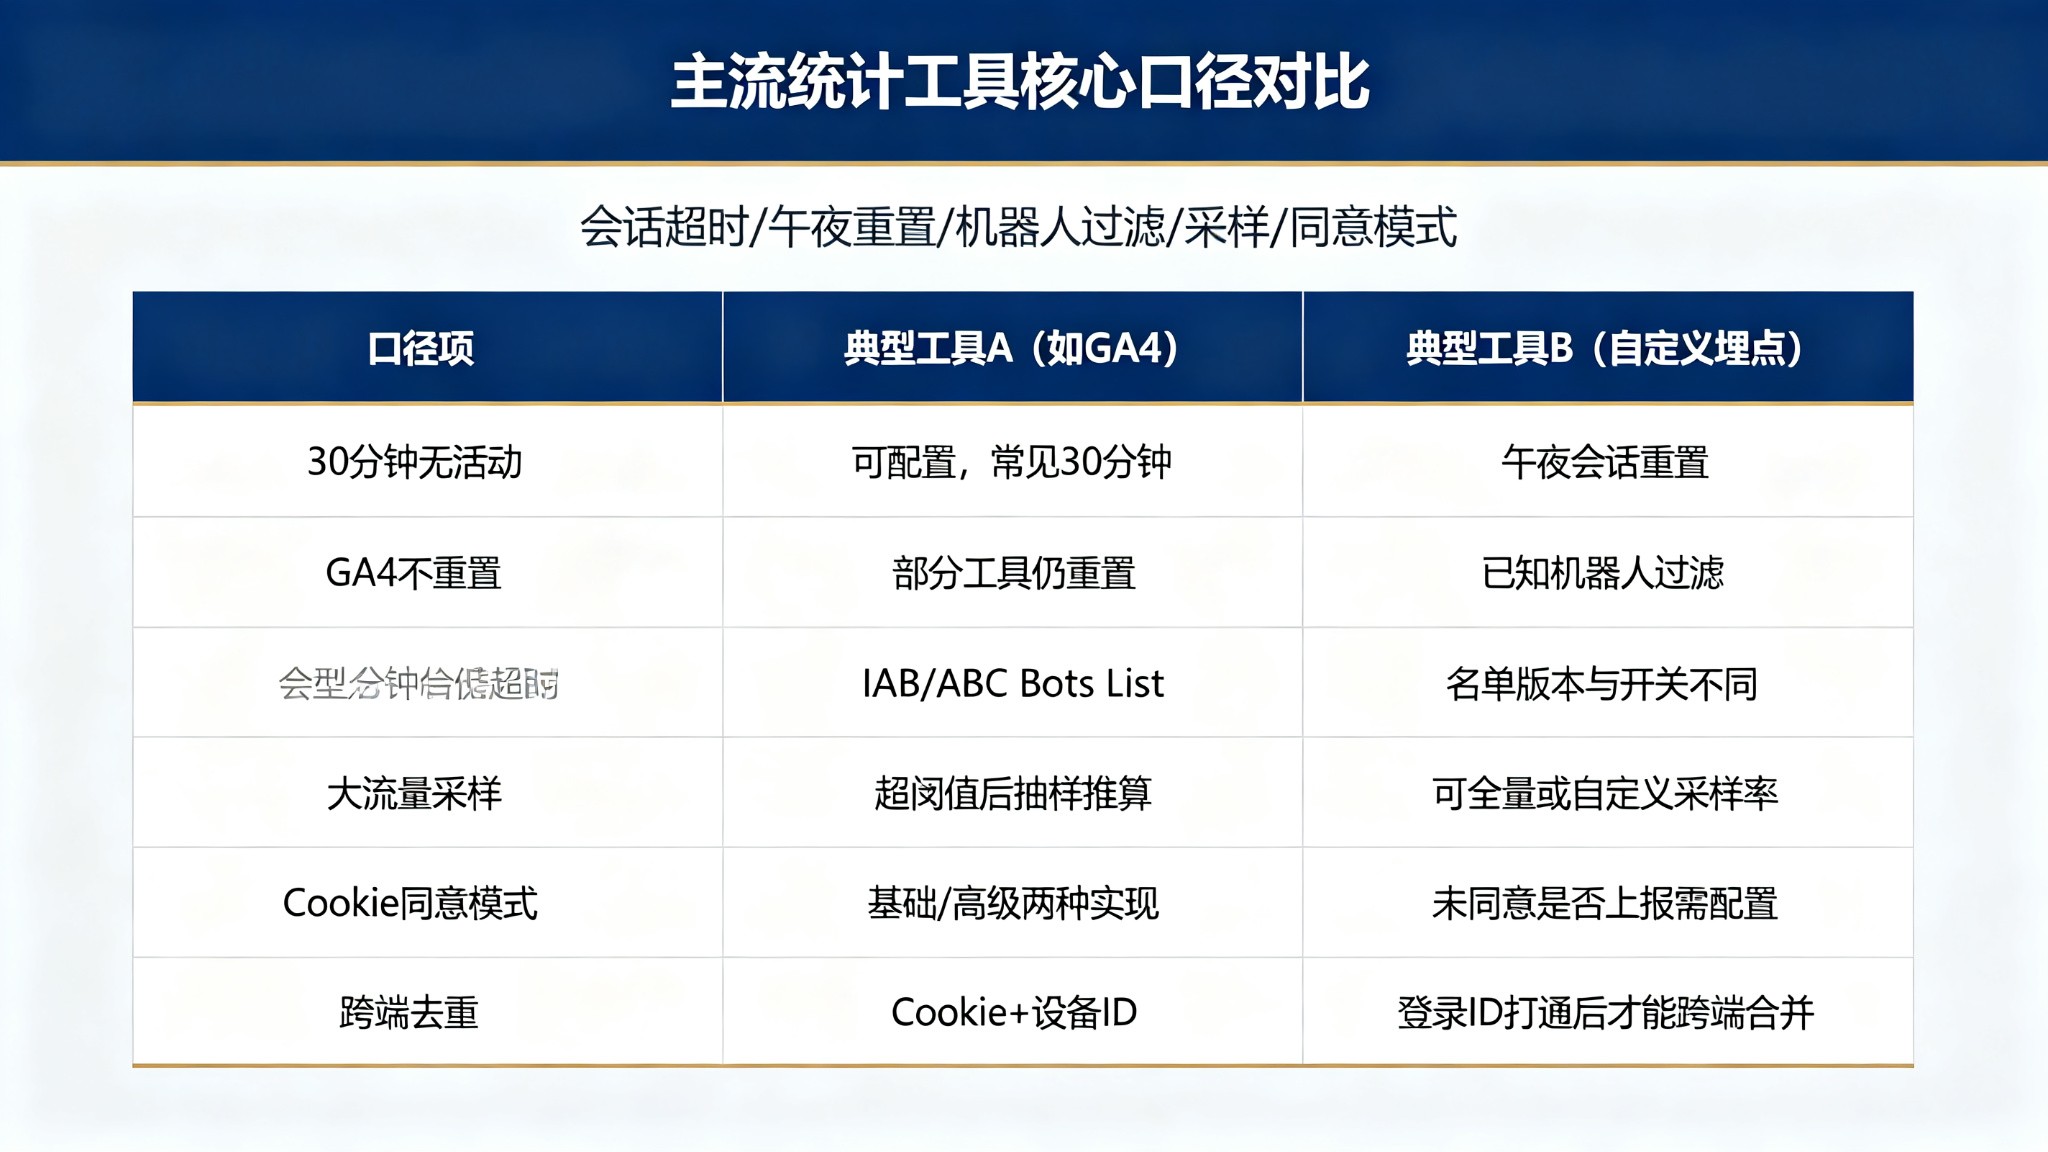 图2:主流统计工具在六个关键口径上的差异对照
七、主流工具口径对照
下表把上面六类差异整理成可直接对照的维度。表中「典型工具」指公开可查的主流做法,具体数值以各工具官方文档为准。
| 口径维度 | 典型做法 A(如 GA4) | 典型做法 B(自定义埋点/自建) |
|---|---|---|
| Session 无活动超时 | 默认 30 分钟 | 可配置,常见 15~60 分钟 |
| 午夜是否重置 Session | GA4 默认不重置 | 部分工具仍按属性时区午夜截断 |
| 已知机器人过滤 | 自动接入 IAB/ABC Bots List | 名单版本与开关需自行维护 |
| 大流量采样 | 超阈值后抽样推算,报表带采样提示 | 可全量计算或自定义采样率 |
| Cookie 同意模式 | 基础 / 高级两种实现 | 未同意是否上报需在采集层配置 |
| 跨端去重 | Cookie + 设备 ID | 接入登录 ID 后才能跨端合并 |
| 统计时区 | 属性级可配置 | 需在采集与展示层分别配置 |
| 广告归因窗口 | 常见 30 天点击 | 各广告平台窗口不同(如 7 天点击+1 天浏览) |
八、数据对不上,按这五步排查
我们把日常对接客户时的排查动作整理成一条固定路径,建议按顺序执行,而不是一上来就翻代码。路径如下图所示。
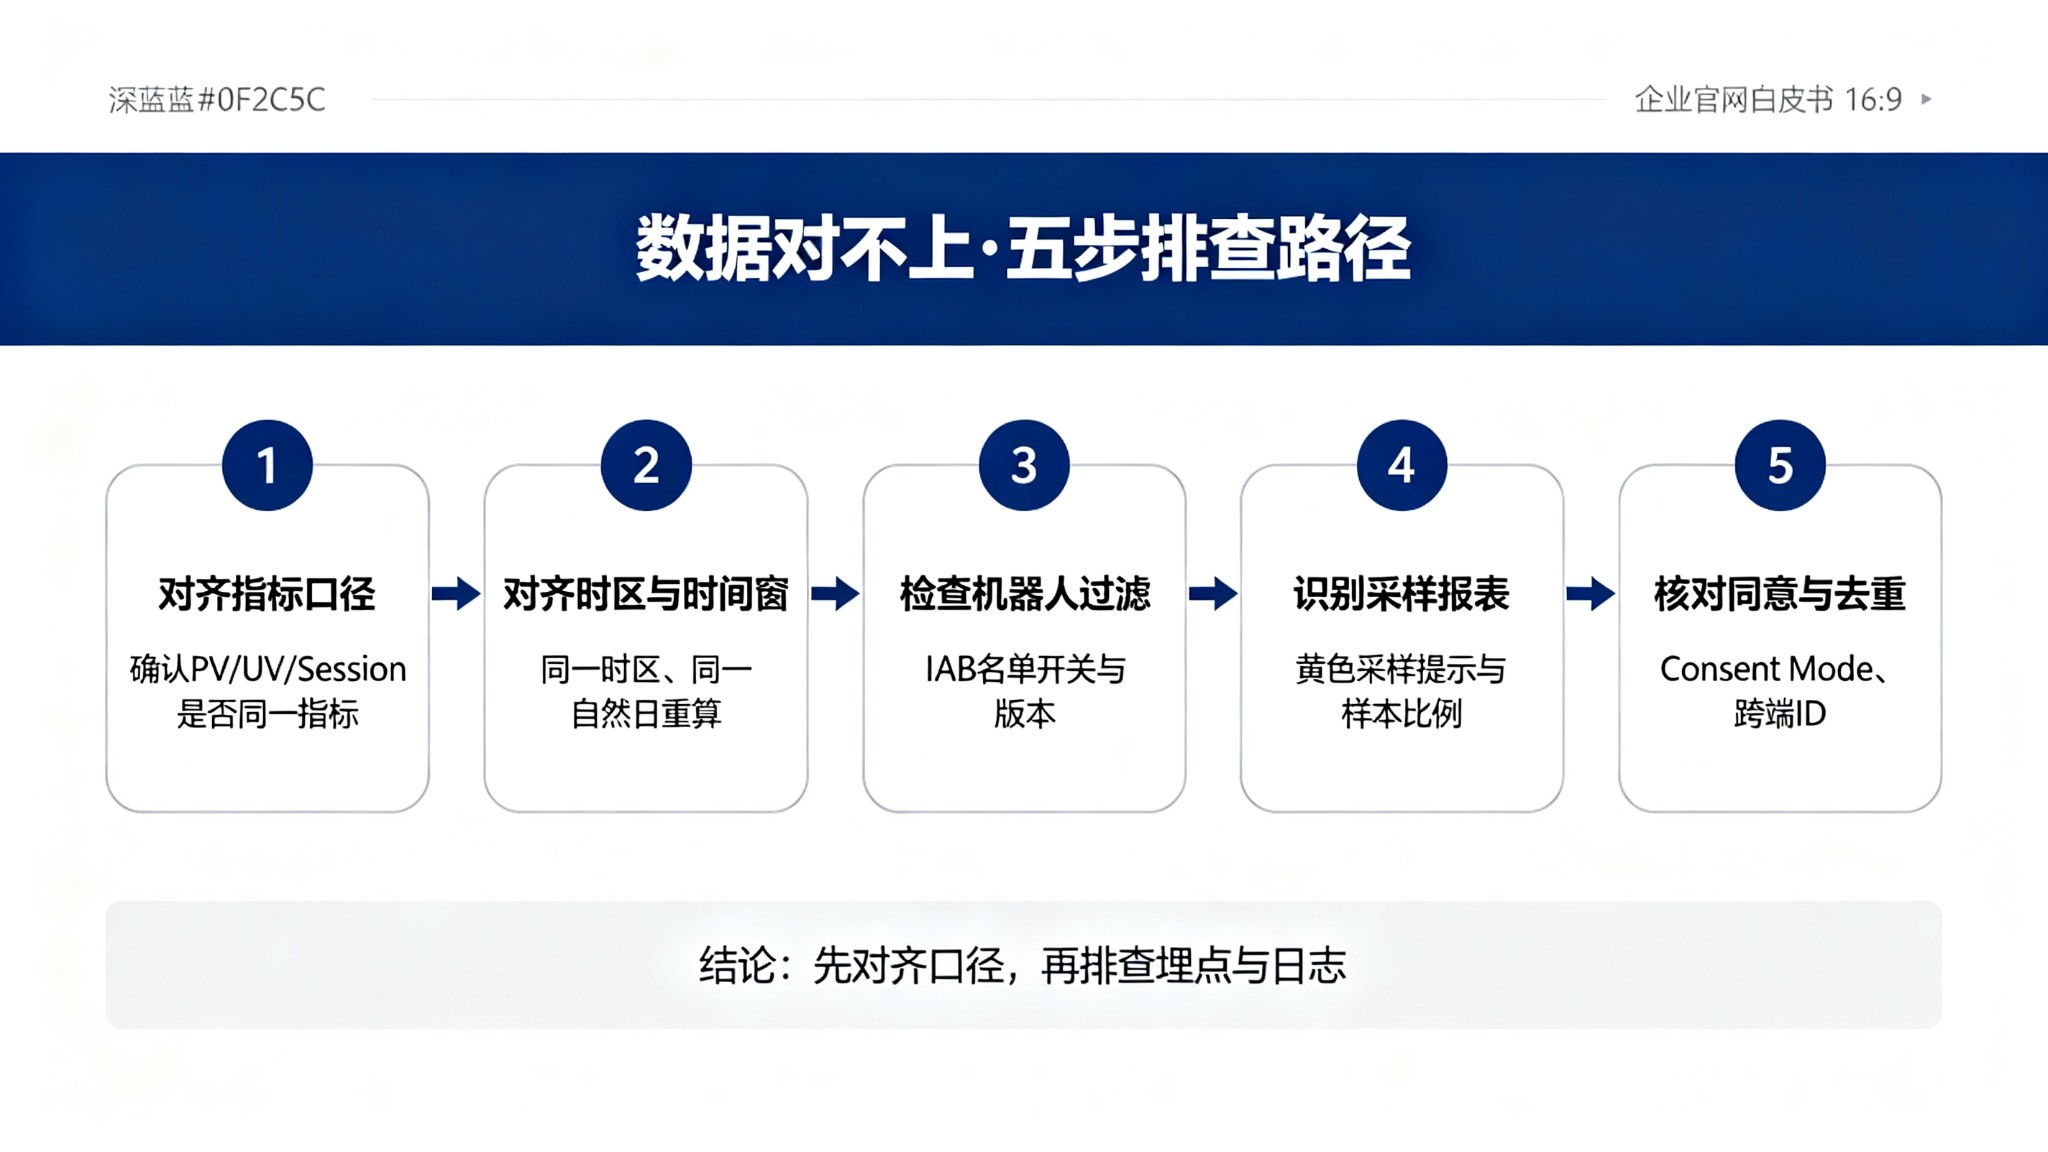 图3:两个统计工具数据对不上时的五步排查路径
- 对齐指标口径。先确认两边看的是不是同一个指标:PV 还是 UV?是 Session 还是 Active User?是转化数还是转化用户数?
- 对齐时区与时间窗。把两个属性都切到同一时区,取同一自然日,再比一次。
- 检查机器人过滤。确认两边是否都开启了已知机器人排除,名单版本是否接近。
- 识别采样报表。报表上是否有黄色采样提示?如有,缩短日期范围或换全量表再看。
- 核对同意与去重。Consent Mode 是基础还是高级?跨端去重是否启用?登录 ID 是否上报?
九、四个最容易踩的坑
| 常见误解 | 实际情况 |
|---|---|
| 「两个工具数字不一样,肯定有一个埋点错了。」 | 多数情况下两边都在正常工作,只是口径不同。先对齐口径再判断谁漏报。 |
| 「PV 高的那个工具更准。」 | PV 高往往意味着机器人、重复请求被计入,而不是更准。 |
| 「UV 低就是统计不全。」 | UV 低可能是去重更严格、跨端合并更彻底,反而更接近真实人数。 |
| 「采样报表可以直接拿去汇报。」 | 采样结果是推算值,小分母细分场景误差会被放大,重要结论建议用全量数据复核。 |
十、我们在口径治理上的做法
作为全端数据分析与性能监控平台,这套口径梳理正是我们面向运营与数据团队沉淀的方法论之一。我们服务个人站长、互联网产品团队、电商零售、数字化营销等行业用户,在统计口径治理上,把以下能力做成后台可查看、可配置的项,目的是让运营同学在做多工具对比时,知道差异从哪儿来,而不是对着两张报表互相怀疑:
- 一套SDK覆盖网站、App、小程序,业务数据与前端性能数据(卡顿、报错、接口超时)打通;
- Session 超时、机器人过滤、采样策略、同意模式下的上报行为,均可在后台查看当前配置;
- 可视化看板零门槛,5 分钟完成接入;数据合规安全,提供 7×24 小时服务。
公开定价上,免费版 ¥0/月(100万PV/50万事件量/年)、基础版 ¥99/年起(1000万PV/500万事件量/年)、专业版 ¥999/年(1亿PV/5000万事件量/年)、企业版 ¥9999/年(10亿PV/5亿事件量/年),具体以官网为准。
写在最后
统计工具之间对不上数字,本质是工程口径问题,不是信任问题。先对齐口径,再讨论谁对谁错。把 Session、机器人、采样、同意、时区、去重这六件事逐项核对完,绝大多数差异都能解释清楚;剩下的少数情况,再去查埋点与服务端日志也不迟。