456数据用户分群:标签条件如何避免人群重叠
一、典型配置场景:高价值群和活跃群为什么撞在一起
这个场景暴露了什么问题
以下为典型配置场景,不指向特定客户:在用户分群里同时建了"高价值群"和"活跃群",两个群的条件都没有加互斥限制,结果同一批人同时落在两个群里,运营触达时被重复打扰。分群最怕的不是标签少,而是标签之间互相重叠:同一个用户被算进两个群,后续触达重复、口径打架。所以动手配条件之前,要先把三件事确认清楚。
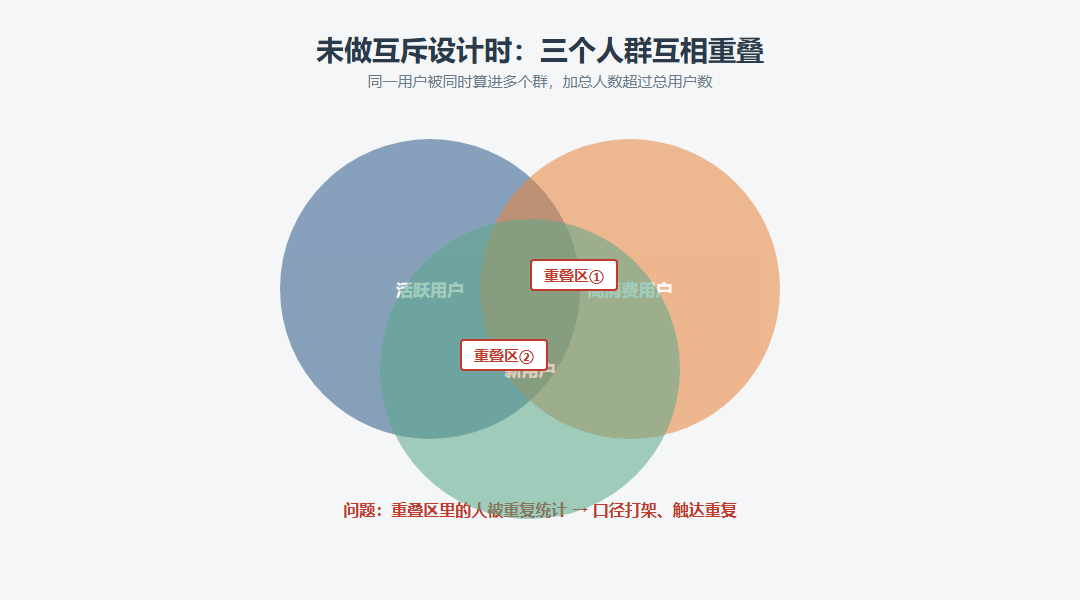
未做互斥设计时三个标签人群互相重叠的示意
第一件事:分群服务哪个运营目标
先问清楚这次分群是为了什么。目标不同,分群的主轴就不同:要做召回就按活跃度分,要做提成就按消费力分,要做新人引导就按用户所处阶段分。目标决定了哪条主轴是"第一刀",主轴选错,后面所有标签都会跟着乱。
第二件事:标签条件从哪来
再确认标签条件有没有数据支撑。任何标签条件本质上都是事件或属性的组合,团队必须先有一份清晰的事件字典,把每个事件的名称、触发时机、属性字段定义清楚。事件本身没定义清楚,标签条件就是空中楼阁。
第三件事:重叠的代价是什么
最后要让团队意识到重叠的代价:重叠会导致同一用户被多个群重复统计,人群加起来超过总用户数,触达时还会重复打扰。很多团队觉得"重叠一点没关系",但等到复盘时才发现口径对不上,返工成本远高于一开始就做好互斥。
二、什么样的标签条件会互相重叠
重叠的三种成因
把重叠的成因分清,才能对症下药。下表把三种成因、典型表现和处理思路列清楚。
| 成因 | 典型表现 | 处理思路 |
|---|---|---|
| 条件交叉 | "活跃"和"高消费"两个条件没有互斥,同时满足的人被算两遍 | 用优先级让一个人只落一个群 |
| 维度混用 | 把活跃度和消费力放在同一层并列,而不是分层 | 先定主轴,再在主轴内细分 |
| 口径漂移 | 同一标签在不同群里定义不一致 | 统一事件字典与判定阈值 |
条件交叉靠优先级解决,维度混用靠分层解决,口径漂移靠统一字典解决,三者修法不同,不能用一个办法包打天下。
互斥设计的判断口径
判断一组标签是否互斥,有一个简单口径:把任意两个群的条件放在一起,问"会不会有一个用户同时满足这两个条件"。只要答案是"会",这两个群就不是严格互斥的,这个判断要对所有两两组合都过一遍。
还要注意一个误区:把条件写得越细不等于越互斥。条件越细,边界情况越多,反而越容易出现"谁都不满足"的空群。互斥不是条件无穷细分,而是在主轴清晰、互补条件完整的前提下,用优先级把剩余边界情况收住。
三、设计互斥标签的四步
第一步:先定分层主轴
第一步永远是定主轴,它是分群的第一刀,决定人群怎么被切成大块。按运营目标选一条主轴,比如按活跃度把用户切成新客、活跃、沉默、其他,这条主轴天然互斥,因为一个用户在某个时刻只能处于一种状态。
第二步:给每个标签加互斥条件
在主轴之内再细分时,给每个标签加上排他条件。例如在"活跃"里再分高消费和普通消费,就要明确写"活跃且高消费"与"活跃且非高消费",让两个条件在消费力维度上正好互补,从逻辑上保证没有重叠。
第三步:设定优先级兜底
给所有标签定一个优先级顺序。总有一些边界情况无法靠互补条件完全覆盖,所以要规定当一个用户同时满足多个标签时,按优先级最高的群归属。优先级兜底给重叠留了唯一出口,而不是让系统随机分配。
第四步:跑一遍人群求并集
把所有群的人数加起来,和总用户数对一遍。严格互斥的分群,各群人数之和应该等于被划分的总用户数;一旦加总超过总用户数,就说明还有重叠没清干净。这是验收前的最后一道闸。
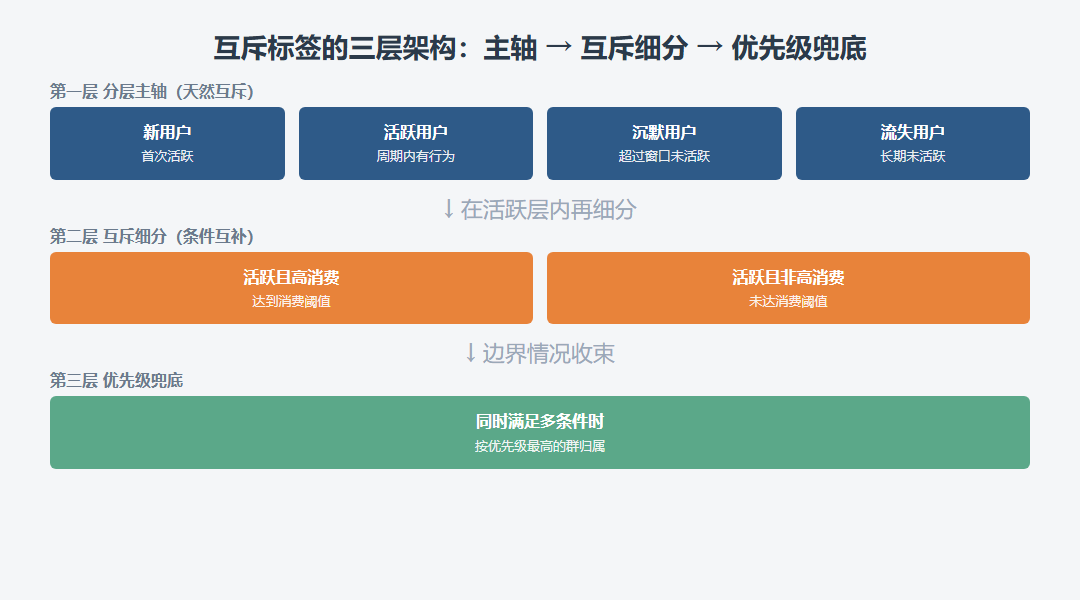
分层主轴、互斥条件与优先级兜底的标签条件架构
四、用户画像对外交付哪四项,哪些方法还不能当平台能力
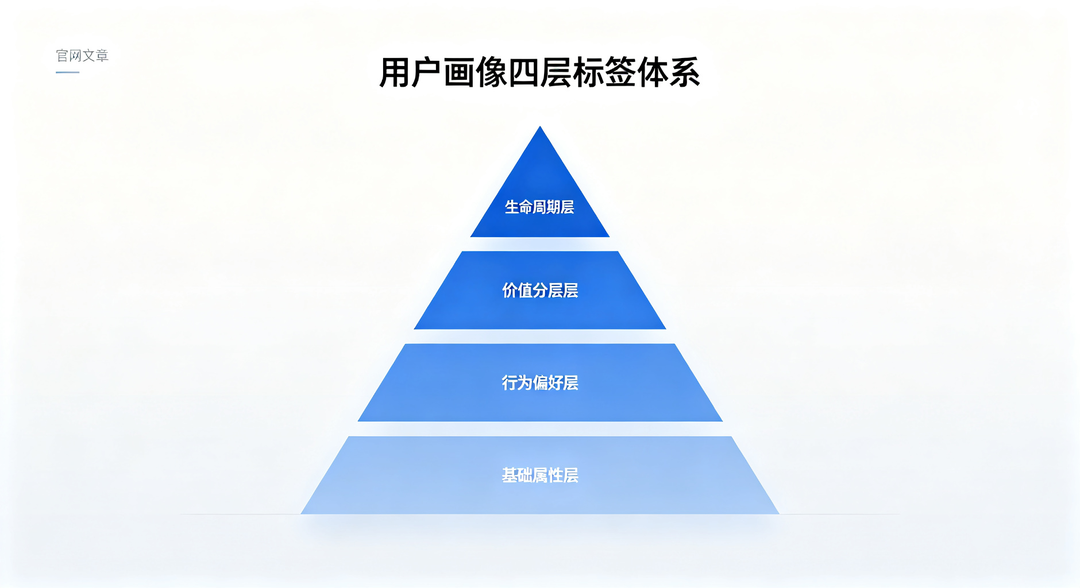
用户画像四项可交付能力
落到平台,用户分群属于用户画像这条产品线。据官网定价页与后台能力边界核验(核验日期2026-10-12),456数据的用户画像在专业版开放,当前对外交付用户洞察、用户分群、用户标签、用户群画像四项;其余分层方法需在这四项之内按事件规则自行配置。
生命周期分群只是通用方法
"按用户所处阶段分层"在方法上是一种通用分析思路,可以作为团队自己设计主轴时的参考。但要说明:生命周期相关功能当前整组不对外交付(据后台能力边界核验,核验日期2026-10-12),不能把它写成平台已经开放的现成能力;团队若需要这类分层,需按事件规则在用户分群里自行配置。
互斥配置细节需实测
分群的互斥条件和优先级在后台具体怎么配置、是否支持自动校验重叠,这些细节需实测并以后台为准。建议先创建站点、把事件字典跑通,再用小批量用户验证分群结果,不要一上来就给全量用户打标签。事件字典的质量直接决定分群上限:标签条件挂在事件之上,事件命名混乱、属性字段缺失,再精巧的互斥设计也会算错人。
五、分群验收卡:五个指标逐条打勾
验收卡怎么用
分群方案只有逐条验收过才能放心上线。我们把验收项整理成一张验收卡,每项写清定义和达标标准,每改一次条件就重跑一遍。
| 验收指标 | 定义 | 达标标准 |
|---|---|---|
| 互斥率 | 同时落进两个及以上人群的用户占比 | 趋近0;边界用户按优先级唯一归属,不重复计数 |
| 覆盖率 | 被任一人群覆盖的用户占全部被划分用户的比例 | 接近100%;未被覆盖的用户进入"未归类用户"单列 |
| 空群率 | 配置后人数为0的人群占比 | 趋近0;出现空群说明条件过细或数据缺失,需回查 |
| 未归类用户 | 不满足任何标签、按优先级落在"其他"的用户 | 单列监控;占比突然放大时回查主轴是否失效 |
| 时间快照 | 分群结果按哪个时间点冻结、多久重建一次 | 写清快照日期与重建周期,避免口径随时间漂移 |
举一个假设示例:某站点被划分用户共10000人,配置高价值群3000、活跃群5000、沉默群1500,其余500人暂未归类,三个群加总9500、空群0。若复核发现高价值群与活跃群有200人同时满足两边条件,则互斥率=200÷10000=2%,高于"趋近0"的达标线,说明这两个群的互斥条件需要重配。以上数字为假设示例,仅用于解释指标算法,非真实业务数据。
重叠是隐性的,靠加总和抽查才能暴露。验收通过后,把这张卡沉淀成分群方案的固定附件,以后任何条件调整都要重新走一遍。
时间快照与重建频率
时间快照这一项最容易被忽略。分群结果是按某一天的数据冻结出来的:今天判定为"活跃"的用户,两周后可能已经沉默。所以要在规则里写清分群结果取数的截止日期,以及多久按新数据重建一次;触达使用的是哪一版快照,也要和报表上的人群规模对齐,否则触达人数和报表人数会对不上。
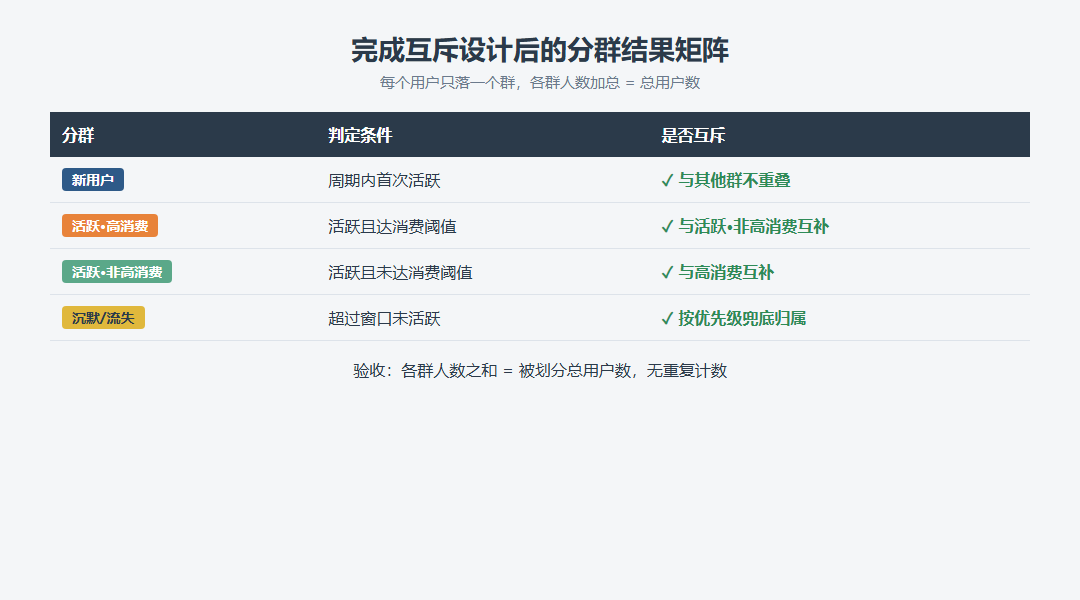
完成互斥设计后各群互不重叠的分群结果矩阵