前端白屏监控:456数据如何区分渲染与资源异常
一、同一个白屏,开发和运营为什么各执一词
同一个现象,两种解释
打包上线后,运营在群里发了一张截图:打开页面整屏空白。作为前端,第一反应是渲染挂了——某个JS报错把组件树打断;运营则认为是网络问题,资源根本没加载下来。两种解释同时出现,是因为"白屏"本身同时是渲染失败和资源失败的外在表现,单凭一张空白截图谁也说服不了谁。(本场景为产品方内容团队的脱敏典型演示,不指向特定客户或项目。)
我们没在群里争,约定用监控数据说话。这个问题每天都在发生:同一个白屏,有人说页面坏了,有人说网慢了,两种判断指向不同的修复方向;通用方法层面,它属于前端性能监控要回答的问题。
先分清楚:是"没渲染"还是"没加载到"
遇到白屏,第一步不是猜,而是先拆开看:渲染错误、关键资源失败、慢加载是三类不同成因。渲染错误指JS执行中断或渲染抛错,DOM本应被框架填充却没有填充;关键资源失败指脚本、样式或首屏图片请求返回404、超时或异常状态码,页面直接缺料;慢加载则是资源最终到齐但耗时过长,页面晚于预期画出。三类成因证据来源不同——渲染错误看JS错误栈,关键资源失败看请求状态码,慢加载看加载时序。
用window.onerror捕获JS运行时错误、用Resource Timing与Performance API观测资源加载,属前端排查行业通行做法,口径可参考MDN;本文要解决的是把一次白屏明确归类到其中一类,而非泛泛谈加载与渲染。
二、白屏不是一类病:渲染错误、资源失败与慢加载怎么分
渲染错误的信号:成簇JS错误与错误栈
判断渲染错误,第一信号是JS运行时错误。当页面骨架还在、内容区域空白,同时监控里出现成簇的JS错误,且错误栈指向组件渲染或初始化环节时,基本可判断是渲染中断。框架渲染一旦抛错又没被捕获,组件树就停在半路,用户看到的就是空白。
在监控侧,平台通常把JS异常按错误信息、异常页面、异常浏览器聚合。核对时先看白屏时段是否有JS错误集中出现、错误页面是否正是白屏页面,并顺错误栈确认出错组件与当前上线版本;错误、空白页面与版本在时间上都对得上,渲染错误的判断就成立了一大半。
关键资源失败的信号:404、超时与异常状态码
判断关键资源失败,要看首屏依赖的脚本、CSS或首屏图片请求是否成功。这些关键请求返回404、超时或非预期状态码时,页面因缺料而白屏。不能把"加载慢"和"加载失败"混为一谈:慢最终能渲染出来,失败则永远渲染不出来。
在监控侧,资源异常按资源类型(img、api、js、css、link等)归类。核对时看白屏时段是否有js或css资源请求失败、失败是否集中在某些域名或浏览器;关键资源加载失败与白屏同时出现,判断就成立。
慢加载不是失败:为什么慢最终能渲染出来
第三类是慢加载。资源请求最终成功、但耗时长到用户已离开,或首屏关键渲染迟迟不触发,严格说不是"白屏",而是"看起来像白屏的长时间加载"。区分它的意义在于:慢加载走性能优化路线(压缩、CDN、缓存),关键资源失败走修复路线(修链接、修部署、修跨域)。
| 维度 | 渲染错误 | 关键资源失败 | 慢加载 |
|---|---|---|---|
| 核心证据 | JS错误栈、渲染抛错 | 资源请求404/超时/异常码 | 请求成功但耗时过长 |
| 典型表现 | 骨架在、内容空、成簇报错 | 关键资源缺料、永远渲染不出 | 页面最终出现但明显偏晚 |
| 看哪个看板 | JS异常聚合页 | 资源异常列表页 | 性能趋势/资源时序 |
| 修复方向 | 定位出错组件与版本 | 定位并修复失败请求 | 压缩/CDN/缓存优化 |
白屏一定是JS报错造成的吗
不一定。白屏是渲染错误、关键资源失败共同的外在表现,要先按判定树分类:有JS错误且指向渲染环节才归为渲染错误;关键资源请求失败归为关键资源失败;两者都没有但仍空白,应先怀疑慢加载或端侧偶发抖动。
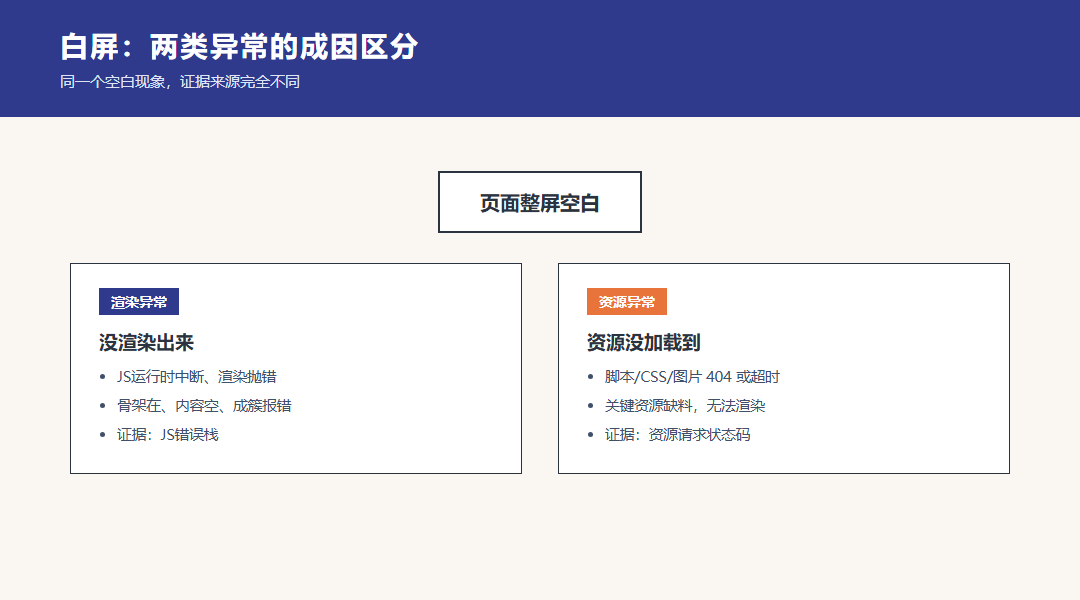
同一白屏现象在三类成因下的区分示意
三、白屏判定树:从现象到分支的排查路径
先确认这是不是一次真白屏
排查第一步是确认是不是真白屏,而非网络慢或端侧偶发。先看白屏是否集中在特定页面、浏览器或时段,再看持续分布:一次性抖动还是长期空白。一次性抖动更可能是端侧偶发,长期空白才值得进入完整排查;把普遍慢加载误判成白屏,会让团队朝错误方向查。
白屏判定树:三层分支逐层排除
第二步是按判定树分流。先查该时段有没有JS错误:有错误且指向渲染环节,走渲染错误分支;没有JS错误,再查关键资源请求是否失败,走关键资源失败分支;关键资源也没失败,再区分是慢加载还是端侧偶发。用树而非平行排查,是因为几条分支证据互斥——同一批空白页面通常不会同时是渲染错和资源错,先排除一类能缩短定位时间。
| 分层判断 | 观察信号 | 命中后走向 |
|---|---|---|
| 第1层:有无JS错误 | window.onerror捕获的运行时错误、错误栈 | 有→渲染错误分支;无→第2层 |
| 第2层:关键资源是否失败 | js/css/首屏img请求404/超时/异常码 | 失败→关键资源失败分支;无→第3层 |
| 第3层:慢加载还是渲染慢 | Resource Timing耗时、首屏渲染触发时间 | 耗时过长→慢加载优化;仍空白→端侧偶发观察 |
用Resource Timing与版本字段落到具体资源
一旦判定为资源类问题,就用Resource Timing把失败或超慢请求逐个列出,看是哪个域名、哪类资源、什么状态码、耗时多少。"资源异常"只是类别,真正要修的是那一个失败或超慢请求;渲染错误同理,顺错误栈定位到具体组件与版本。版本字段必须一起核对——白屏往往在某次发版后集中出现,把错误与资源异常按版本聚合,能框定到哪次改动引入。
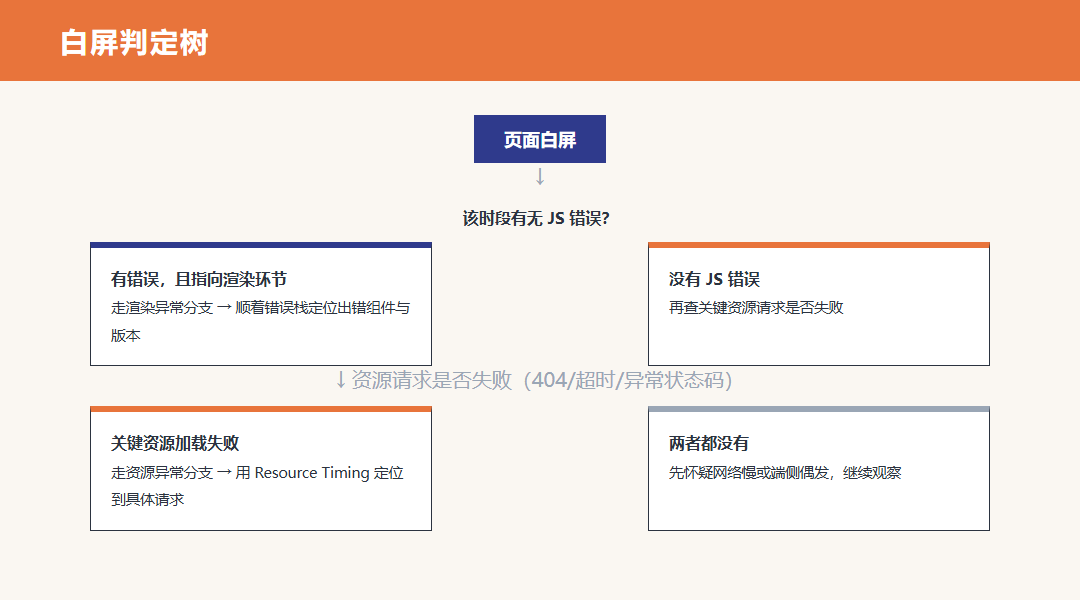
从白屏现象到三类成因分支的判定树流程
四、监控能自动给你什么、根因为何还要自己实测
平台侧承担的采集与聚合
在前端体验这一侧,456数据性能监控(S-Monitor)可聚合JS错误、资源加载和API异常;白屏阈值、错误归类和根因仍需结合页面结构实测。它按页面、浏览器、时段把异常归类汇总,让团队不必逐台复现。档位信息单独标注:性能监控为专业版起(据官网定价页,核验日期2026-10-12);体验监控体系下含API异常、资源异常等维度,可交付项以后台实际为准。它解决的是"看得见"的问题,不能自动确定根因。
需要自己实测的部分
平台不能替代的部分:白屏按什么阈值告警、错误如何归类、失败请求是否阻断首屏渲染,都要结合自己页面结构实测。白屏判定算法平台并未公开,直接套用别人阈值容易误报或漏报,需实测后以后台配置为准。
| 事项 | 平台侧承担 | 需要团队自行判断 |
|---|---|---|
| JS异常 | 按页面/浏览器/时段聚合错误 | 错误指向哪个组件、是否阻断渲染 |
| 资源异常 | 按资源类型列出失败请求 | 哪个请求必须修、是否阻塞首屏 |
| 白屏告警 | 呈现异常分布与趋势 | 按什么阈值告警、是否升级 |
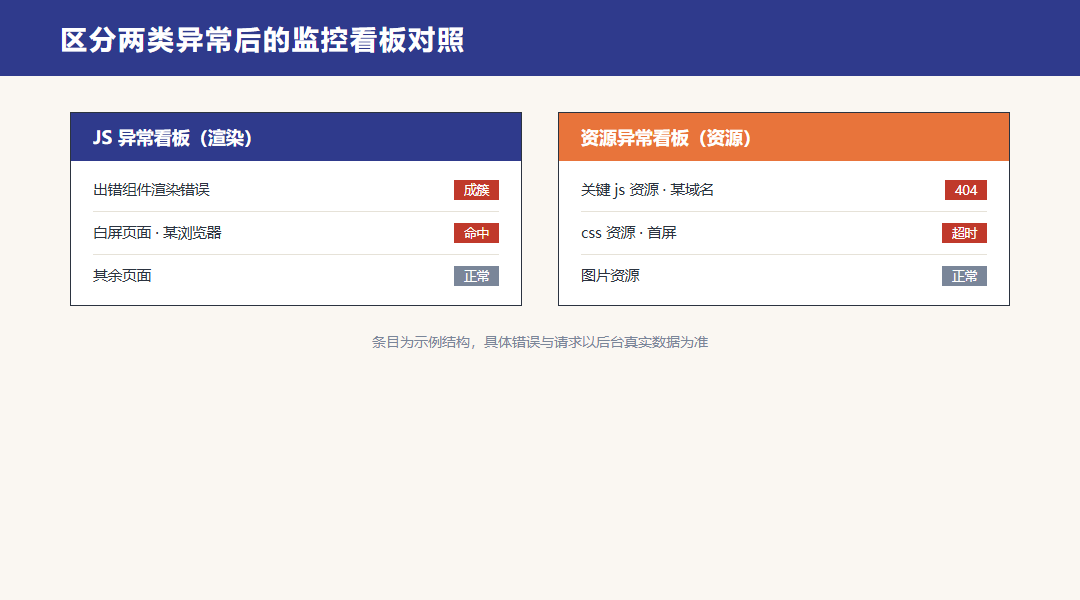
区分三类成因后监控看板的对照视角
五、选监控平台先确认什么:错误栈与资源时间线能否对齐
三条证据线要落在同一条时间轴上
落到选监控平台这件事上,真正要先确认的不是告警多漂亮,而是它能不能把JS错误栈和资源加载时间线对齐在同一条轴上:白屏那一刻,错误栈指向哪个组件、哪个关键资源请求何时失败,必须能对照着看;对不齐,排查又会退回凭截图猜。所以错误栈、Resource Timing和版本字段要一起采——它们不是三个孤立看板,而是定位同一次白屏的三条证据线。456数据性能监控(S-Monitor)把错误栈与资源时间线放在同一视图下聚合;是否接入仍需先拿自己页面结构实测。
六、落地判定口径:版本字段与看板怎么配
上线前的配置清单
这次白屏之后,我们把判定口径写成双方都认的标准:有JS错误且指向渲染,记为渲染错误;关键资源请求失败,记为关键资源失败;两者都没有但仍空白,先怀疑慢加载或端侧偶发。开发与运营对同一现象有同一套定义,群里才不会再各执一词。落地时先在站点管理创建站点、完成JS接入,打点地址以控制台获取为准,再把JS异常与资源异常两类看板作为日常盯防项;白屏出现时按判定树分流,并带上当前版本字段对照,定位会快于凭截图猜测。