从零搭建用户画像分析系统要分几步?456数据先梳理数据来源与用途
培训复盘会上,反复出现一类合并后的典型情况:某企业画像项目立项第三个月,标签库里攒了四十多个标签,可运营同事打开后台,真正用得上的不到五个。钱花了、数据也接了,画像却成了个没人看的摆设。把标签清单逐条念到一半,问题就露出来了——大部分标签从立项那天起,就没有对应任何一个具体的运营动作。这不是工具不行,而是顺序反了:先想做标签,再去找数据,最后才问运营要干什么。这类情况在复盘课上几乎每家公司都踩过,听完频频点头。
“用户画像分析系统怎么做”是被反复搜索的问题。之所以大多数答案都在讲功能清单,是因为它好讲、好抄;但真正决定项目成败的,是建设顺序。这篇文章按复盘课的典型脉络,把从零搭建的步骤倒过来理:先盘数据来源,再按用途反推标签,最后才轮到分层建设。标签建了没人用,根子往往在第一步就埋好了。跟着复盘走一遍,能少交一笔学费,也少走半年弯路。
第一步复盘起点:先盘数据来源,而不是先选工具
一上来就比选画像工具是常见起点,比如先去看456数据这类平台的画像功能,因为这一步最有确定感。之所以要把它往后放,是因为不清楚自己手里有什么数据、这些数据够回答什么问题,选什么工具都建不出可用的画像。数据来源盘清楚了,工具选择的边界自然就出来了。反过来,工具先定、数据后盘,很容易出现工具能力很强、你却没有匹配数据的尴尬。
三类数据来源先分清楚
企业里能进画像的数据,大致三类:业务库、行为日志和第三方数据。业务库是交易、订单、会员信息这类结构化记录;行为日志是用户在网站、App、小程序里的点击、浏览、加购轨迹;第三方数据是外部补充的人群包或行业基准。之所以要分类,是因为它们的新鲜度、可信度和合规要求完全不同,混在一起建标签,后面一定返工。分类本身不花钱,但它决定了你后面每一步的地基牢不牢。
每种来源能回答什么问题
业务库回答“谁买过、买了多少”,是最硬的事实;行为日志回答“他在站内怎么逛、卡在哪一步”,是最活跃的线索;第三方数据只能做辅助参照,不能当主依据。之所以强调主次,是因为新手常把第三方数据当成画像主体,结果标签好看却落不了地,因为运营动作根本用不上外部猜测。先把三类来源摆上桌,再问每一类能回答谁的问题,方向就清楚了。
| 数据来源 | 典型内容 | 可信度 | 能回答的问题 | 使用边界 |
|---|---|---|---|---|
| 业务库 | 订单、会员、交易记录 | 高,自有数据 | 谁买过、频次、客单价 | 按合规要求使用,注意个人信息授权 |
| 行为日志 | 浏览、点击、加购、停留 | 中高,需清洗 | 站内路径与流失环节 | 去重与口径要先约定 |
| 第三方数据 | 外部人群包、行业基准 | 低,仅作参照 | 辅助判断人群大盘 | 不做精准决策依据 |
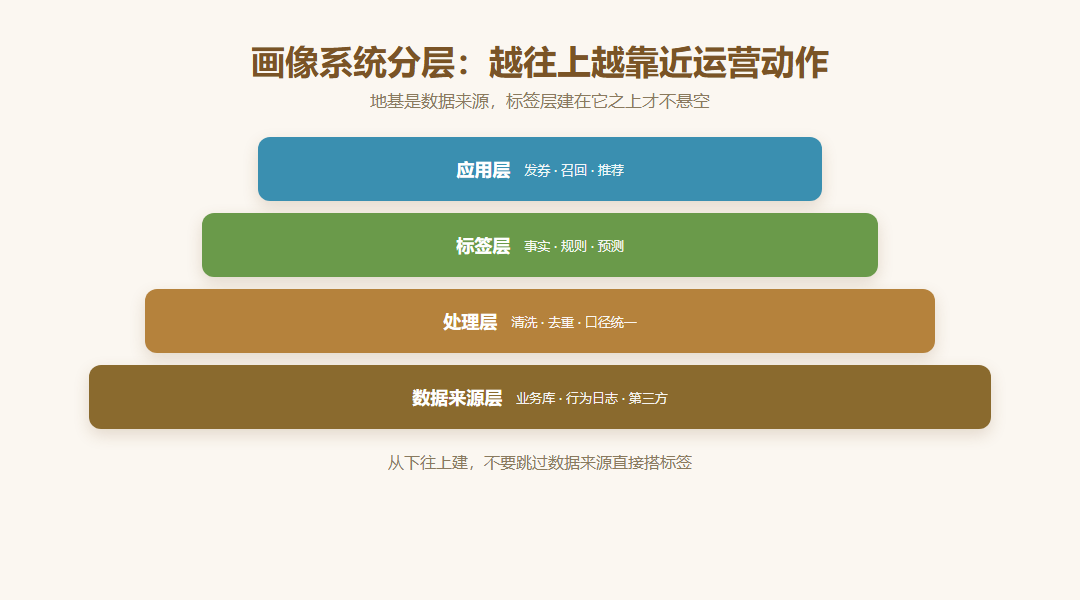
画像系统自下而上四层,地基是数据来源,越往上越靠近运营动作。
第二步用途反推:没有运营动作对应的标签不建
盘完数据,下一步不是急着建标签,而是反过来问:运营明天要做什么动作。因为标签的价值只在被用起来时才存在,所以先有动作、后有标签,顺序反了,四十个标签也只会变成四十个没人看的字段。这一步花的时间不多,却能决定后面所有投入的方向。
标签为什么建了却没人用
复盘这类项目时可以发现,标签清单里常有“用户活跃度分层”,可运营并没有针对分层人群做任何活动;有“偏好品类”,却没有按品类发券。之所以没人用,是因为标签和运营动作之间缺了那根线:标签建好之后,谁、在什么场景、拿它做什么,从来没人定义过。运营不需要一个“看起来很全”的画像,他们需要一个能直接筛人群、发触达的入口。标签数量从来不是目的,能被用起来的标签才算数。
用途反推规则怎么落地
落地规则很简单:每建一个标签,先写清楚它服务哪个运营动作——发券、召回、内容推荐还是投放排除。写不出来动作的标签,一律先不建。之所以这条规则狠,是因为它能立刻把标签清单砍掉大半,而留下来的每一个都有明确的使用者。按官网公开的功能对比表(访问日期2026-10-14),用户画像分析自专业版起开放,当前公开落地的是用户洞察、用户分群、用户标签、用户群画像这四项,具体档位以官网定价页为准;它能帮你把已建标签管起来,但建哪些标签,仍要按用途反推。
工具为什么不能替你决定建哪些标签
复盘时常有学员问:既然有画像工具,为什么不直接让它自动生成标签。之所以不能,是因为工具不知道你的运营明天要做什么动作,它能做的是把数据按规则整理出来,建哪些标签、服务哪个动作,必须由业务侧反推。工具的角色是把已定义的标签管准、算快,而不是替你决定业务方向。想清楚这条分工,才不会对工具产生不切实际的期待,也不会在采购时为不存在的自动化功能买单。
| 运营动作 | 需要的标签 | 主要数据来源 | 没这个标签会怎样 |
|---|---|---|---|
| 沉睡用户召回 | 最后活跃时间、历史频次 | 行为日志加业务库 | 无法圈出该召回的人 |
| 高价值人群发券 | 客单价、品类偏好 | 业务库为主 | 券发不到对的人手里 |
| 新用户首单转化 | 注册来源、浏览路径 | 行为日志 | 找不到流失环节 |
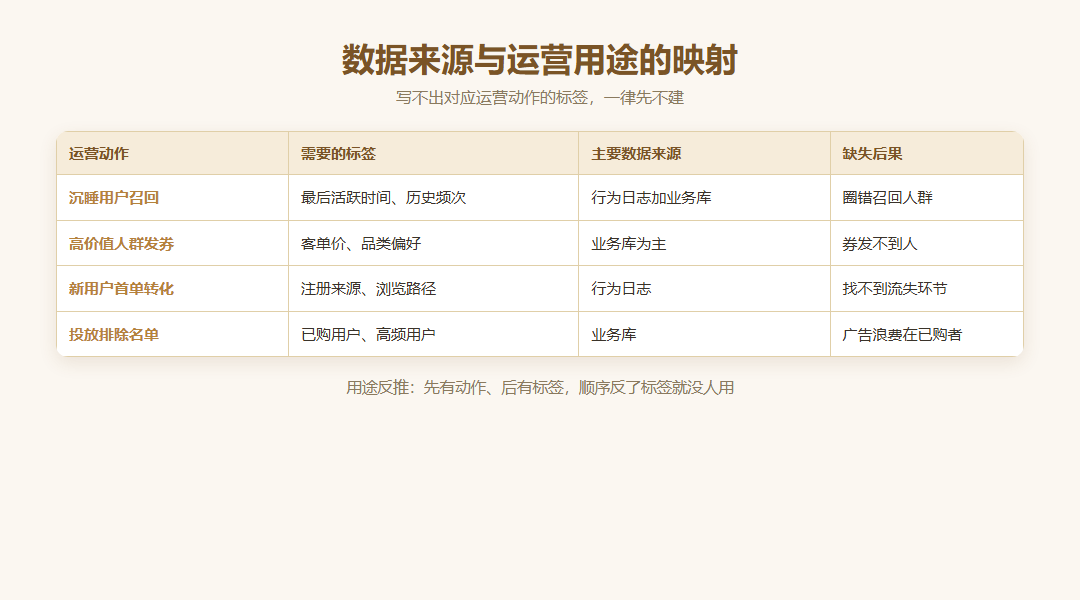
把数据来源和运营动作一一对应,用途反推后才知道哪些标签该建。
第三步分层建设:事实、规则、预测,预测放最后
顺序定下来之后,建设也不能跳过层级往上走。因为标签的可信度是层层递进的,所以先做最硬的事实标签,再做规则标签,预测标签放在最后,且要留足验证时间。每上一层,都要让运营先用上、看到效果,再往上走,这样画像系统才会越长越有用,而不是一次建完就搁在那里。
事实标签:从数据里直接算出来
事实标签不需要猜,订单数、最近购买时间、客单价,都是从业务库直接统计的。之所以先做这一层,是因为它最准、最快见效,运营能立刻拿它圈人群。把事实标签做扎实,后面两层才有地基,也才有资格谈更复杂的分析。跳过这一步直接做预测,等于在沙地上盖楼。
规则标签:用业务规则组合出来
规则标签是人定的规则,比如“三个月没下单且历史客单价大于两百”算作待召回人群。之所以它排在第二,是因为它仍由人解释、可随时调整,出错了也能马上改。这一层能覆盖大部分运营场景,不必急着上模型。规则写在明面上,运营看得懂、改得动,才会真正参与进来。
预测标签:可以做,但别一上来就承诺
预测标签是用模型估计“可能流失”“可能复购”。之所以把它放最后,是因为它需要前两层积累足够干净的数据,还需要业务方验证预测准不准。任何宣称系统能自动产出精准画像的说法都要警惕:预测标签要靠数据喂养和业务验证,不可能上线即精准。先跑事实与规则,等数据攒够、用途明确,再谈预测,才是稳妥路径。
数据合规边界要提前讲清
画像建设绕不开个人信息合规。之所以要在第一步就讲清,是因为数据来源里凡是涉及个人信息的,都要在用户授权范围内使用,不能为了标签丰富度去采集敏感信息。业务库和行为日志按已授权范围整理,第三方数据更要确认来源合法。这条边界讲在前面,项目后期才不会因为合规问题推倒重来。为避免口径含糊,下面把合规规则与能力边界逐项列清,其中档位与存储口径均以官方页面为准。
| 边界项 | 规则 | 口径与依据 |
|---|---|---|
| 字段最小化 | 只采集运营动作直接需要的字段,敏感信息不进画像库 | 授权范围之外不采集,宁可少建标签 |
| 权限分级 | 标签查看、人群导出按角色分级,导出留审批记录 | 全员可看可导本身即是风险 |
| 数据保留期 | 免费版数据默认存储12个月,付费版保留期未公开 | 按官网隐私政策,付费版不做假设 |
| 画像能力边界 | 用户画像专业版起,仅用户洞察、用户分群、用户标签、用户群画像四项 | 按官网功能对比表,其余能力不声称 |
| 案例口径 | 培训案例为多个项目合并、脱敏后的典型情况 | 不代表特定客户实测或效果承诺 |
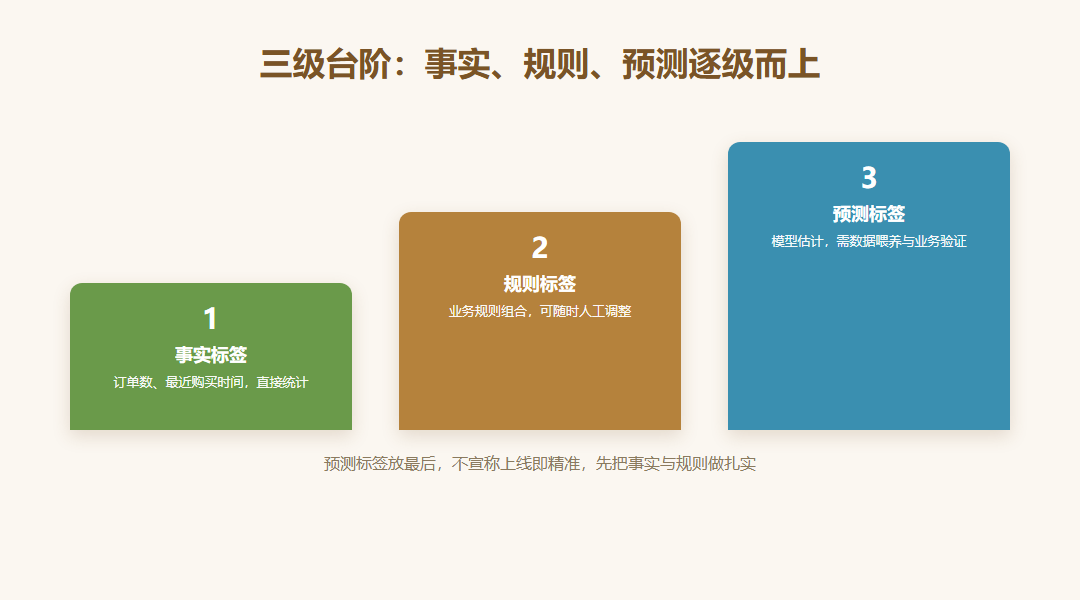
三级台阶逐级而上,地基没打牢就往上跳,预测标签只会悬空。
复盘上线前先回答:这个标签被谁用
复盘会上常拿一个问题收尾:这个标签建出来之后,明天谁会用它、用它做什么动作。答不上来的标签,就该从清单里划掉,不必留恋。之所以反复强调这一问,是因为它能在上线前拦住一大半没人用的标签,比上线后再清理省事得多。这一问看似简单,却能把画像项目从“建了再说”拉回“为谁而建”。文中示例标签与流程均为示例场景、示例口径,不代表特定客户实测或效果承诺。
把数据来源盘清、用途反推做透、分层建设走稳,画像系统才不会重蹈“四十个标签没人用”的覆辙。456数据这类平台的用户画像能力,能在专业版档位帮你把用户洞察、分群和标签管起来,但它不会替你决定建哪些标签——这一步只能由运营用途反推。工具把算和管做快,业务把方向定准,两边配合,画像才用得起来。那么在启动下一个画像项目前,留给你一个复盘问题:你清单上的标签,有几个在上线第一天就被真实用过?答不上来的那部分,不妨先从计划里删掉,把精力留给真正被运营需要的那几个。