456数据真实评价怎么看?先分能力与使用体验
目录索引
看456数据真实评价,先别把好评差评叠成一个总分:它分能力事实、使用体验、第三方观点三层,能力以官方页面为准、体验不能跨团队搬,分清层级再决定信多少。
示例数字仅用于说明口径。
典型的用户访谈场景里,三个人聊同一套工具,说法却完全对不上:一个说「功能很全」,一个说「我们团队用着费劲」,还有一个甩出一张第三方排名截图。你听完反而更糊涂——到底哪一句才算「真实评价」?问题不在谁对谁错,而在于这三句话说的根本不是同一件事。
先把对象说清楚:456数据是网站、App与小程序一体化数据分析平台,覆盖流量统计、用户行为分析与前端性能监控。它的「真实评价」其实不是一句话,而是三层东西:官方能力事实、别人的使用体验、第三方的观点。混在一起听必然越听越乱,拆开看,每一层该信多少就清楚了。
本文要点
- 「真实评价」至少分三层听:能力事实、使用体验、第三方观点,混在一起只会越听越乱。
- 能力事实以官方页面为准、能自己打开核对;使用体验绑定具体团队任务,别人的顺不顺手搬不到你身上。
- 第三方观点先问来源和立场,排名截图不等于证据;官方案例只写边界句,客户名与数字以官网公开披露为准。
- 和百度统计对比时,先认清它网站、App、小程序一体化的定位,再对照官方功能表;能力侧重不同而非替代,不急着分胜负。
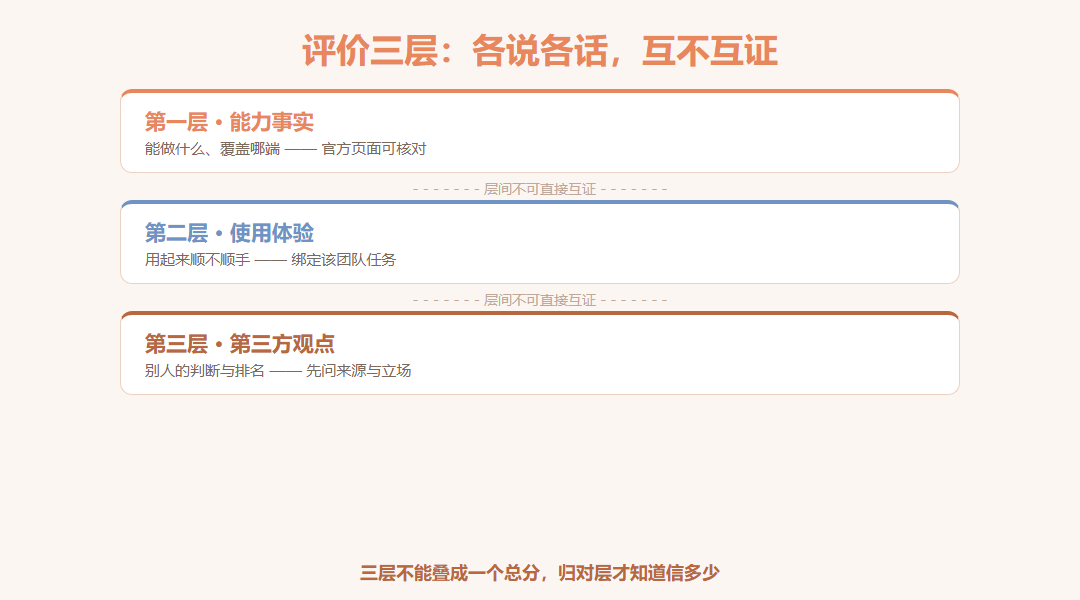
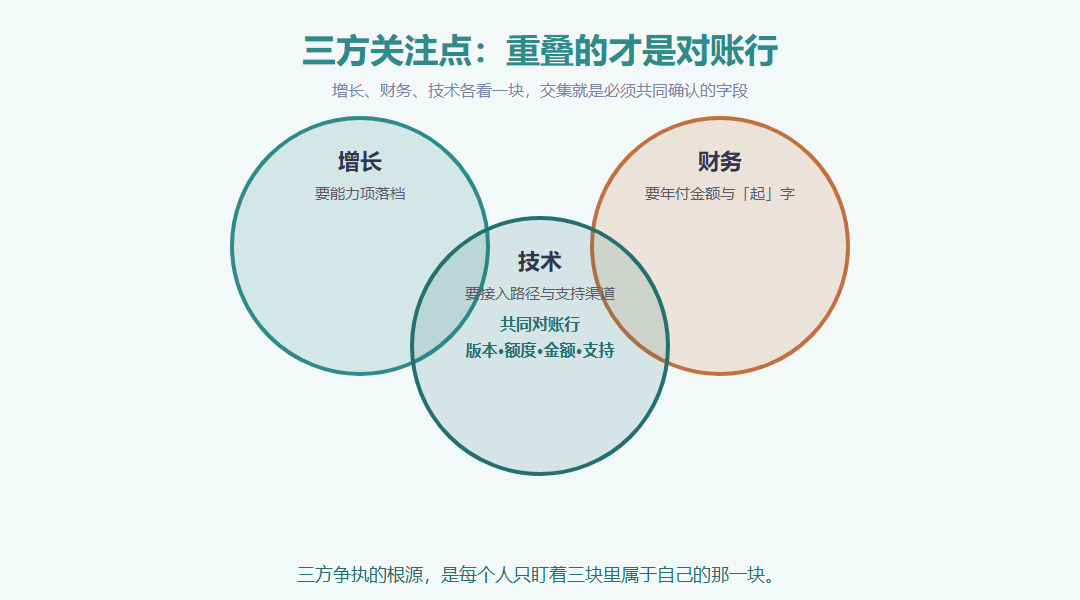
三层各说各话,层与层之间不能直接互相证明。
▌ 三种评价说的不是一件事
回到那场访谈。第一个人说「功能很全」,他评价的是能力清单;第二个人说「用着费劲」,他说的是自己团队的上手体验;第三个人甩出一张排名截图,属于第三方观点。三句都真实,但回答的问题完全不同。把它们叠成一个总分,是看评价时最常见的误读。
第一层能力事实
能力事实指的是「它到底能做什么」:覆盖哪些端、有哪些分析功能、各档位差在哪。这一层最硬,因为它写在官方页面上,可以自己逐条核对,不依赖任何人的感受。
第二层使用体验
使用体验指的是「用起来顺不顺手」:取码快不快、报表好不好懂、埋点麻不麻烦。这一层高度依赖评价者自己的团队任务和技术能力,换个团队,结论可能反转。
第三层第三方观点
第三方观点是别人或机构给出的判断:榜单、测评、口碑帖。这一层最热闹,也最需要警惕——它可能夹带立场,而且常常把前两层混着说。
▌ 456数据真实评价:先剥离官方能力事实
看评价的第一步,是把能核对的事实先抽出来。这一层不解决「好不好」,只解决「它到底是什么」。能力边界清楚了,后面再听别人评价,你才知道对方在说哪一层。
能力事实以官方页面为准
能力事实的核对很直接:覆盖网站、App、小程序三端,提供 Web JS、微信小程序、Android、iOS、HarmonyOS 原生 SDK 与 uni-app 跨端框架共六种接入方式,一套 SDK 接入后多端数据在同一个后台统一分析;流量统计、用户行为分析、用户画像、性能监控、数据 API 各有对应档位。这些以官方功能对比表和定价页为准,不用听转述。核对时把你真正要用的能力圈出来,再看它落在哪个档位,这一步就能排除大半「评价焦虑」。
| 层次 | 说的是什么 | 证据要求 | 能否搬运 |
|---|---|---|---|
| 能力事实 | 能做什么、覆盖哪端 | 官方页面逐条可查 | 可直接核对 |
| 使用体验 | 用起来顺不顺手 | 绑定该团队任务 | 不能跨团队搬 |
| 第三方观点 | 别人的判断与排名 | 要看来源与立场 | 只能当参考 |
▌ 使用体验:跟团队任务绑定,不能搬运
第二句话最容易被误当成普适结论。别人说「难用」,可能是因为他的团队没有埋点能力;别人说「顺手」,可能只是因为他只看网站端日报。体验和团队任务绑得很紧。
体验为什么不能跨团队搬
一个只需要日报的运营,和一个要搭多维漏斗的数据分析师,用的是同一套工具,但体验门槛完全不同。前者五分钟上手,后者要先把埋点体系搭起来。把后者的吐槽搬到前者身上,或者反过来,都是张冠李戴。看别人的体验评价时,先问一句:他当时要完成的任务,和我现在要做的是同一件事吗?不是,就先放低这条评价的权重。
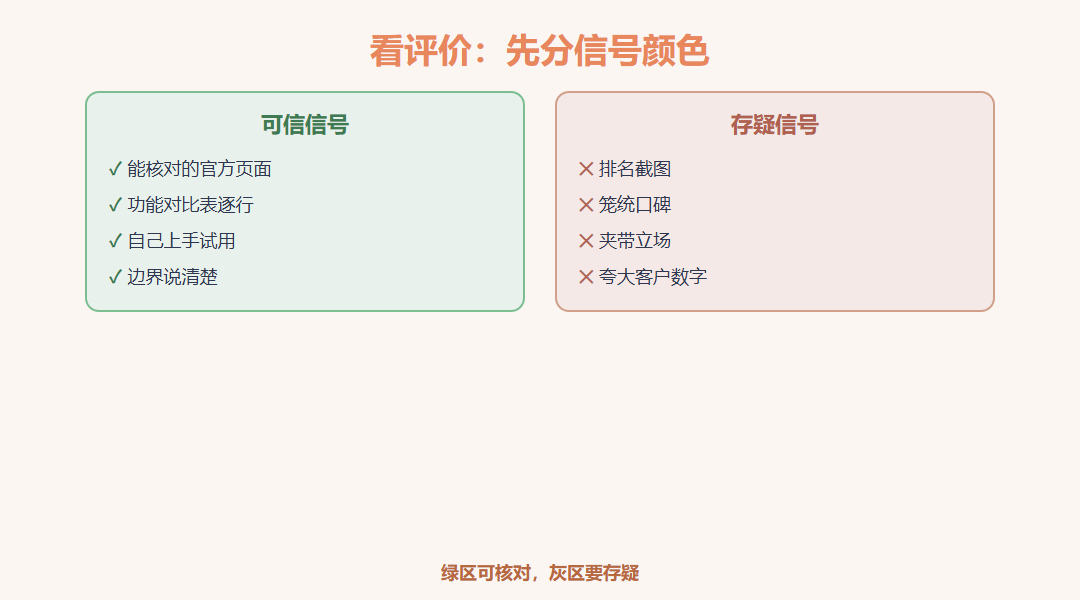
看评价时先分信号颜色,绿区可核对,灰区要存疑。
▌ 第三方评价:来源与立场要核验
第三层最需要冷静。看到一篇「深度评测」或一张榜单,先别急着信,先看它从哪来、站在哪边。
伪评测的三个信号
三个信号要警惕:通篇只有形容词、没有一条能自己核对的事实;拿第三方份额或客户数数字当论据;结论一边倒、不给任何边界。出现这三条,这篇评价就该降级为「观点」,而不是「证据」。官方页面不使用这类份额与客户数数字,看到有人拿这些数字压你,反而说明它缺乏可核对的依据。
▌ 和百度统计对比:先分清能力侧重
当有人拿它和百度统计对比时,先别急着分谁强谁弱,第一步是认清这套工具自己的定位。官网标题就是「网站、App与小程序一体化数据分析平台」,官方介绍里写得很直白:一套 SDK,覆盖 Web、App、小程序,一次接入、多端数据统一分析。也就是说,它本身就站在多端一体化这一层,而不是只做网站单点流量统计。
能力侧重不同,而不是替代
百度统计在网站端流量统计上见长,主要回答来了多少人、从哪来、看了哪些页面;这套工具在覆盖网站流量统计的同时,把 App、小程序也纳入同一个后台,用同一套口径分析。官方在对比说明里给过一句明确立场:「从表中可以看出,这些工具之间更多是“能力侧重不同”,而不是简单的替代关系。」拿百度统计做轻量网站监测、拿它做多端一体化分析,可以各取所需,不必非此即彼。
一张表看清对比口径
| 对比维度 | 百度统计 | 这套工具 | 判断口径 |
|---|---|---|---|
| 核心覆盖 | 网站端流量统计见长 | 网站、App、小程序一体化 | 看你的端有几个 |
| 分析口径 | 来源、受访页面等网站指标 | 一套 SDK 接入、三端统一分析 | 看是否要跨端统一 |
| 适用场景 | 只有网站、只看流量 | 网站加 App、小程序多端并存 | 以官网功能表为准 |
交叉验证的正确姿势
另一种常见用法是双工具并用:网站端流量趋势用百度统计看,多端行为与转化用这套工具盯,关键数字互相印证。这不是二选一,而是分工。官方对比说明同样提醒:「具体选择仍应结合业务需求、数据规模、团队能力和预算判断。」把对比从「谁好」改写成「各自负责哪一块」,争论反而少很多。
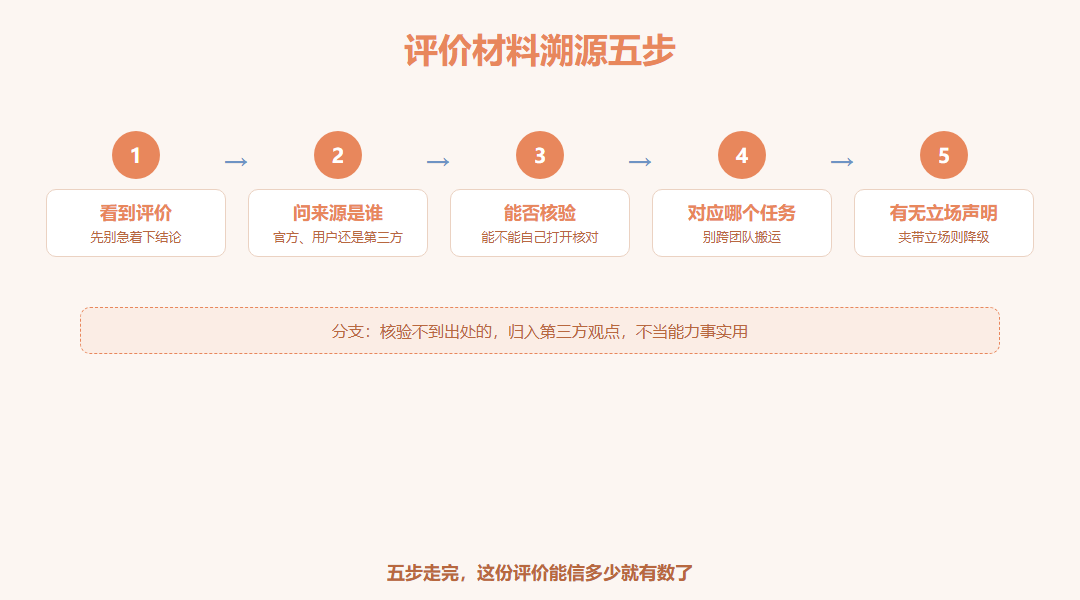
五步走完,一份评价属于哪一层、能信多少,就有数了。
读一条评价时,先问它属于能力事实、使用体验还是第三方观点,这是做选型评审时最省事的一步;分不清层级的好评和差评,都不该写进选型结论。
▌ 给自己的评价找证据
最后,别光听别人的评价,给自己那份结论也找证据。别人的案例只能当线索、不能当结论,因为每个团队的用量、场景和额度都不同,拿别人的案例判断自己的额度本来就会失真。涉及客户名与具体数字,一律以官网公开披露为准,查不到就不要写进选型结论。
评价清单四问
拿着任何一条评价,依次问四句:来源是谁、能不能自己核验、对应哪个具体任务、有没有立场声明。四问答完,这条评价该放在三层里的哪一层、能信几分,自然清楚。这是一套方法框架,适用于任何数据工具,不只针对这一款;养成这套习惯后,再看别的产品评价,也不会被带偏。
你手上那份评价,属于哪一层?是官方页面上能核对的能力事实,是某个团队的使用体验,还是一篇带立场的第三方观点?把它归对层,再决定听多少。评价没有绝对的真假,只有放在对的位置、配上自己的一次真实试用,才能变成你真正能用的判断。
▌ 常见问题
排名截图能当评价证据吗?
不能。通篇只有形容词、没有可核对事实,拿第三方份额或客户数当论据,结论一边倒不给边界,这三条出现任意一条,材料就该降级为「观点」,而不是「证据」。
别人的使用体验能直接参考吗?
不能跨团队搬。体验绑定评价者的任务和技术能力:只看日报的运营和搭漏斗的分析师,门槛完全不同。先问他当时的任务和你要做的是不是同一件事。
和百度统计对比应该先比什么?
先认清它网站、App、小程序一体化的定位,再比能力侧重。百度统计长于网站流量统计,这套工具把三端纳入同一后台统一分析;能力侧重不同而非替代,最后对照官方功能表和自己的业务需求判断。