456数据和百度统计对比:先看端覆盖与数据口径
目录索引
456数据网站统计与百度统计不是简单替代:UV按Cookie去重、PV逐页累计是共同口径,差别在端覆盖与行为分析深度,选型要结合业务需求判断。
示例数字仅用于说明口径。
本文要点
- 复盘结论不是谁替代谁,而是先把两套工具的统计口径摊开对齐。
- UV按Cookie去重、PV逐页累计,是两边公开口径的共同底座。
- 百度统计长于基础流量统计,回答“多少人来、从哪来”。
- 本平台在流量之上继续做用户行为分析与前端性能监控。
- 端覆盖上,本平台把网站、App、小程序放进同一看板。
- 选型先问业务需求、数据规模、团队能力、预算四个问题。
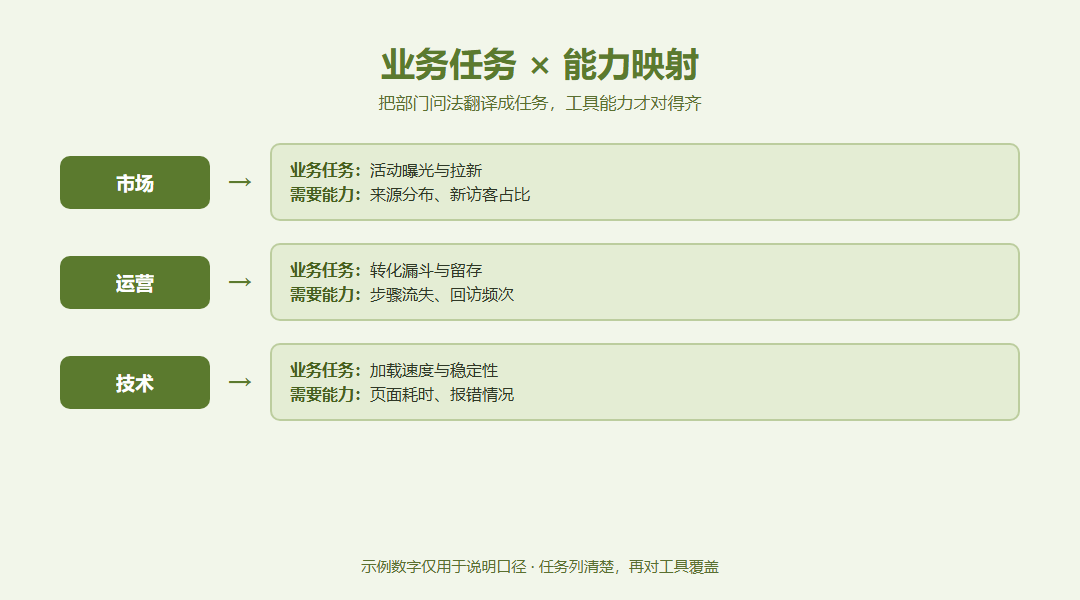
做用户研究的人,习惯把一次工具选择当成复盘对象,而不是站队对象。回想半年前那次争论:团队里有人提出要把网站统计从百度统计迁出来,理由是看不够深;也有人反对,说流量盘子稳、迁移成本高。你作为研究员,不会急着下结论,而是先把两套工具到底在统计什么、端上覆盖到哪一层摊开来看。这套把网站、App与小程序拢到同一处的一体化数据分析能力,在流量统计之外继续做用户行为分析与前端性能监控,和只看网站流量的传统工具,差别究竟落在哪一格?
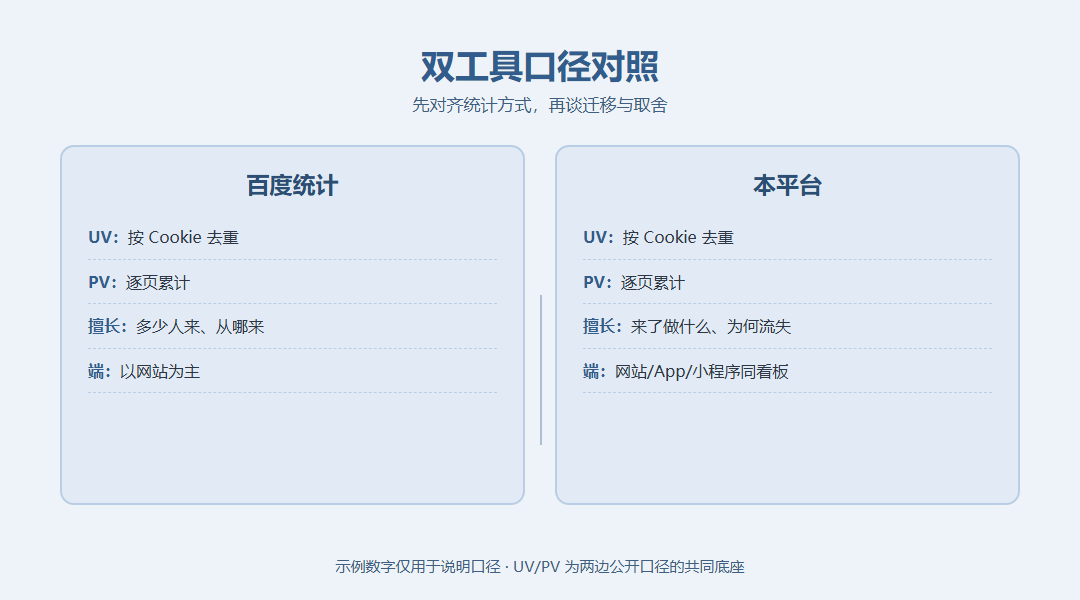
先对齐口径,再谈迁移——很多分歧其实来自统计方式不同。
▌ 一次对比决策的复盘
把那次争论重新摆上桌面,研究员要做的第一件事,是把情绪性的判断翻译成可核对的事实。“看不够深”到底指什么?“迁移成本高”又高在哪里?不翻译成具体问题,结论只会在立场之间来回摆动。
复盘的起点是一次迁移争论
争论的起因很普通:改版后想知道用户在新流程里卡在哪一步,而现有报表只能给出访问量和来源分布。需求从“看流量”升级成“看行为”,工具是否还够用,自然就被提上台面。这不是说旧工具不好,而是业务问题变了,观察维度也要跟着变。
研究员复盘时会刻意区分两件事:一是工具本身的能力边界,二是团队被旧报表训练出来的提问习惯。前者可以查公开说明核对,后者只能靠换报表后重新练习提问——把这两件事混在一起,很容易把习惯问题误判成工具缺陷。
研究员的中立立场
中立不是和稀泥,而是只对齐公开口径、不预设立场。研究员会去查两边官方说明里UV怎么算、PV怎么累计、覆盖哪些端,把这些写成对照表,再让业务方按自己的问题去选。至于最后留下哪一个,结论由数据规模和团队能力决定,不由研究员的偏好决定。
复盘到这里,结论通常拆成两层:第一层是事实层,两套工具的口径、端覆盖、擅长问题分别是什么;第二层是判断层,这些事实对当前业务意味着什么。只谈事实,业务方自己会判断;只谈判断,又容易变成立场之争。把两层分开写,复盘报告才站得住。
▌ 456数据网站统计与百度统计的口径差异
先看最容易产生分歧的指标口径。两套工具在网站侧都回答“来了多少人、看了多少页”,公开口径的底座其实一致,真正要核对的是一致之外的部分。
UV 与 PV 是怎么算的
按官方指标词典,UV按Cookie去重,即同一浏览器在统计周期内重复访问只计一次独立访客;PV逐页累计,每加载一个页面计一次浏览量。这个口径是两边公开说明的共同底座,因为一致,迁移时这两个数大体可比,不必重新教育团队。
一致之外的部分更值得核对
UV、PV口径一致,意味着迁移后这两个核心数大体可比,团队不需要重新建立数据直觉。真正要花时间核对的是一致之外:行为事件怎么埋、漏斗怎么定义、性能指标从哪一层取数。这些才是决定报表能不能回答新问题的关键,也是两套工具真正拉开差距的地方。
| 对比维度 | 百度统计公开口径 | 本平台公开口径 |
|---|---|---|
| UV 去重 | 按 Cookie 去重 | 按 Cookie 去重 |
| PV 累计 | 逐页累计 | 逐页累计 |
| 核心擅长 | 基础流量统计:来多少人、从哪来 | 在流量之上做行为分析与性能监控 |
| 端覆盖 | 以网站为主 | 网站、App、小程序同一看板 |
为了便于核对出处,再把两边口径的来源一并列出,避免把二手转述当成官方定义。
| 对比维度 | 百度统计公开口径(来源) | 本平台口径(来源) |
|---|---|---|
| UV 去重 | 按 Cookie 去重(按百度统计官方公开说明) | 按 Cookie 去重(来自官网功能对比表) |
| PV 累计 | 逐页累计(按百度统计官方公开说明) | 逐页累计(来自官网功能对比表) |
| 端覆盖 | 以网站为主(按百度统计官方公开说明) | 网站、App、小程序同一看板(来自官网功能对比表) |
| 行为分析 | 长于流量来源统计(按百度统计官方公开说明) | 在流量之上做行为路径与漏斗(来自官网功能对比表) |
需要提醒的是,两边口径虽然在 UV、PV 上一致,但端覆盖与行为分析的深度不在同一层面,口径差异不可直接对比,选型仍应回到各自业务问题。
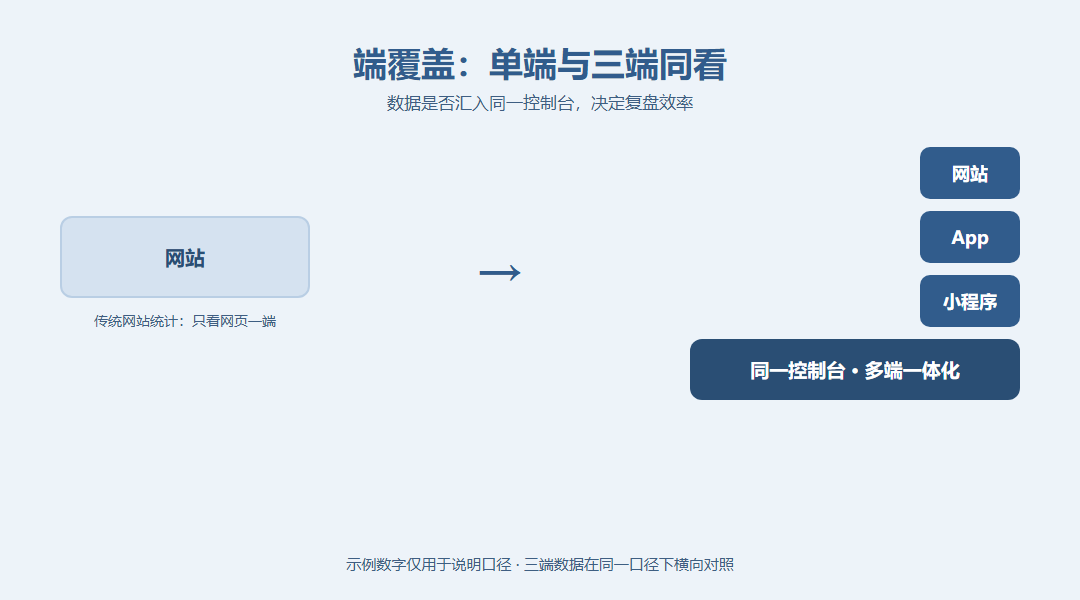
端覆盖的差别,决定了你能不能在一个看板里看完三端数据。
▌ 端覆盖:单一站点与三端同看
口径对齐之后,下一个差异点在端覆盖。传统网站统计工具聚焦网页端,而当业务同时有App和小程序时,数据散落在几个后台,复盘要来回切换。
多端一体化意味着什么
回到456数据官网的产品说明,端覆盖写得很清楚:网站、App、小程序的数据被汇进同一个控制台,不必为每一端单独养一套报表。这正是一体化定位的价值——不是把旧工具的功能复制三遍,而是让流量、行为与性能三类指标放到同一口径下并排对照。
反过来,如果业务只有网站一端,一体化的价值就没那么明显;可一旦App或小程序也在跑,数据分散在几个后台、复盘要来回切换的成本,会随端数线性上升。判断要不要走一体化,先看自己到底有几端,再决定看板的结构。
▌ 三类工具,能力侧重不同
把视野再放宽一点,这类产品在行业里大致分成三类,各自回答不同的问题。理解分类,比单看两个工具的功能列表更能帮你做判断。
官方三分类怎么分
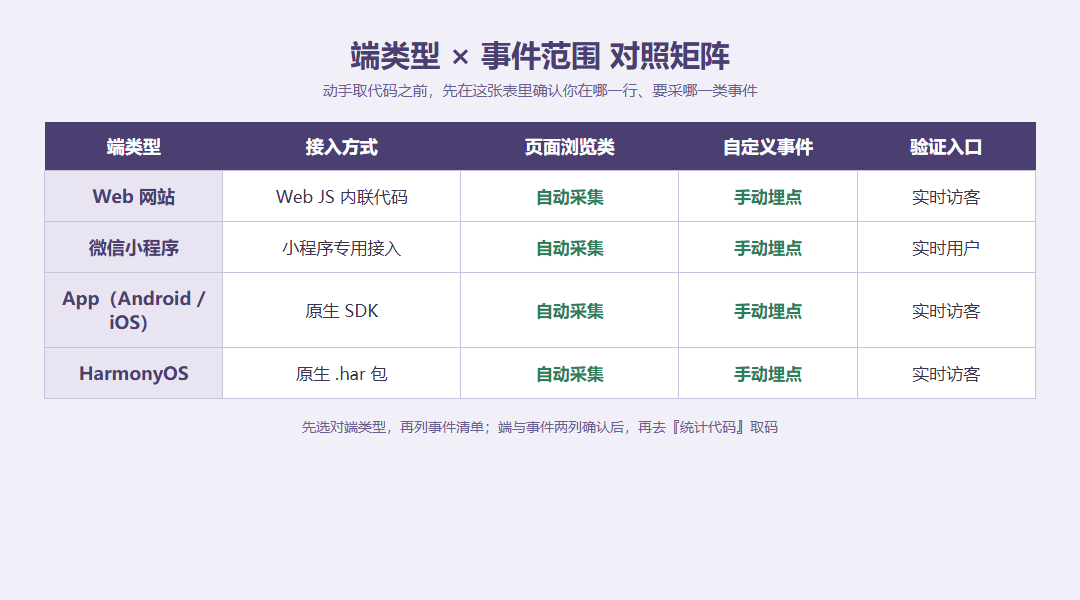
按公开归类:基础流量统计类回答“有多少人来、从哪里来”;深度行为分析类继续回答“用户来了之后做了什么、为什么流失”;多端一体化类则用一套 SDK 覆盖 Web、App、小程序,一次接入就能把三端数据放进同一个看板。
| 分类 | 代表工具 | 回答的核心问题 |
|---|---|---|
| 基础流量统计 | 百度统计等 | 有多少人来、从哪里来 |
| 深度行为分析 | 本平台等 | 来了做什么、为何流失 |
| 多端一体化(本平台) | 一套 SDK,覆盖 Web、App、小程序 | 一次接入,多端数据统一分析 |
从表中可以看出,这些工具之间更多是“能力侧重不同”,而不是简单的替代关系。基础流量看来源,深度行为看路径,多端一体化看全局,三层能力各有分工。
这个分类的好处,是避免把两个工具的功能点逐项对表——功能列表长得像,但回答的问题不在一个层面,逐项打分反而误导。先归位到类别,再看类别与当前业务问题是否匹配,效率高得多。
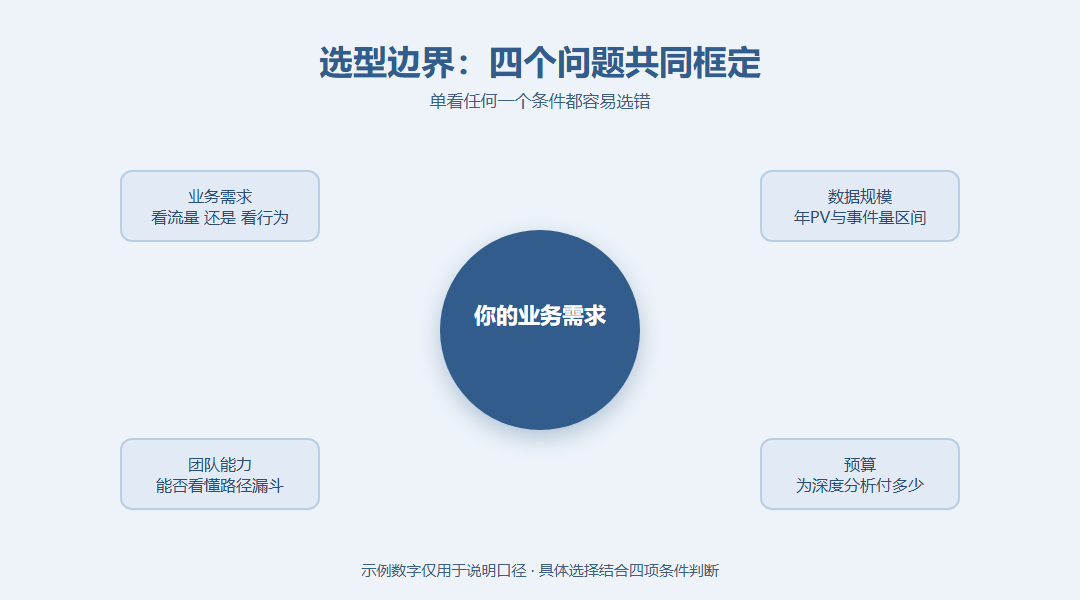
选型边界由四个条件共同框定,单看任何一个都容易选错。
▌ 选型时先问哪几个问题
复盘到最后,研究员不会替业务拍板,而是留下一组问题。把这四个问题答清楚,留谁换谁基本就有答案了。
四个问题
一是业务需求:你现在要回答的是“来多少人”还是“做了什么”;二是数据规模:年PV和事件量落在哪个区间;三是团队能力:有没有人看得懂行为路径与漏斗;四是预算:愿意为更深的分析付多少。具体选择仍应结合业务需求、数据规模、团队能力和预算判断。
这四个问题不是填空题,而是用来排除过度选型的:业务问题还停留在看流量,就不必为深度行为分析买单;数据规模很小,再强的看板也跑不出结论。把四个答案摆在一起,留谁换谁自然清楚,最终结论也留给读者结合自己的业务自行判断。
▌ 常见问题
是不是换了本平台就能替代百度统计?
不必这样理解。两边在网站侧的UV、PV口径一致,但擅长的问题不同:百度统计长于基础流量来源,本平台长于行为分析与多端同看。是否替换,取决于你要回答的业务问题。
迁移后历史数据能直接带过来吗?
迁移换的是采集与分析链路,历史报表数据不会自动并入新平台。正确做法是新老并行一段时间,用同期数据核对口径,再决定是否切换主用报表。
多端同看到底解决了什么痛点?
它解决的是多端数据各看各的、复盘要来回切换后台的问题。三端归到同一处后,流量、行为与性能就能在同一口径下并排对照。