大模型评估:456数据怎样设置任务指标
本文要点
- 先定维度再谈指标:准确性、完整性、相关性、流畅性、安全性是起步配置。
- 测试集规模有参考口径:100-200条起步,500条以上做精细对比。
- 榜单分数涨了,不代表你的业务问题它答得对。
- 模型每次更新都要回归重测,别跳过。
一、五个评测维度
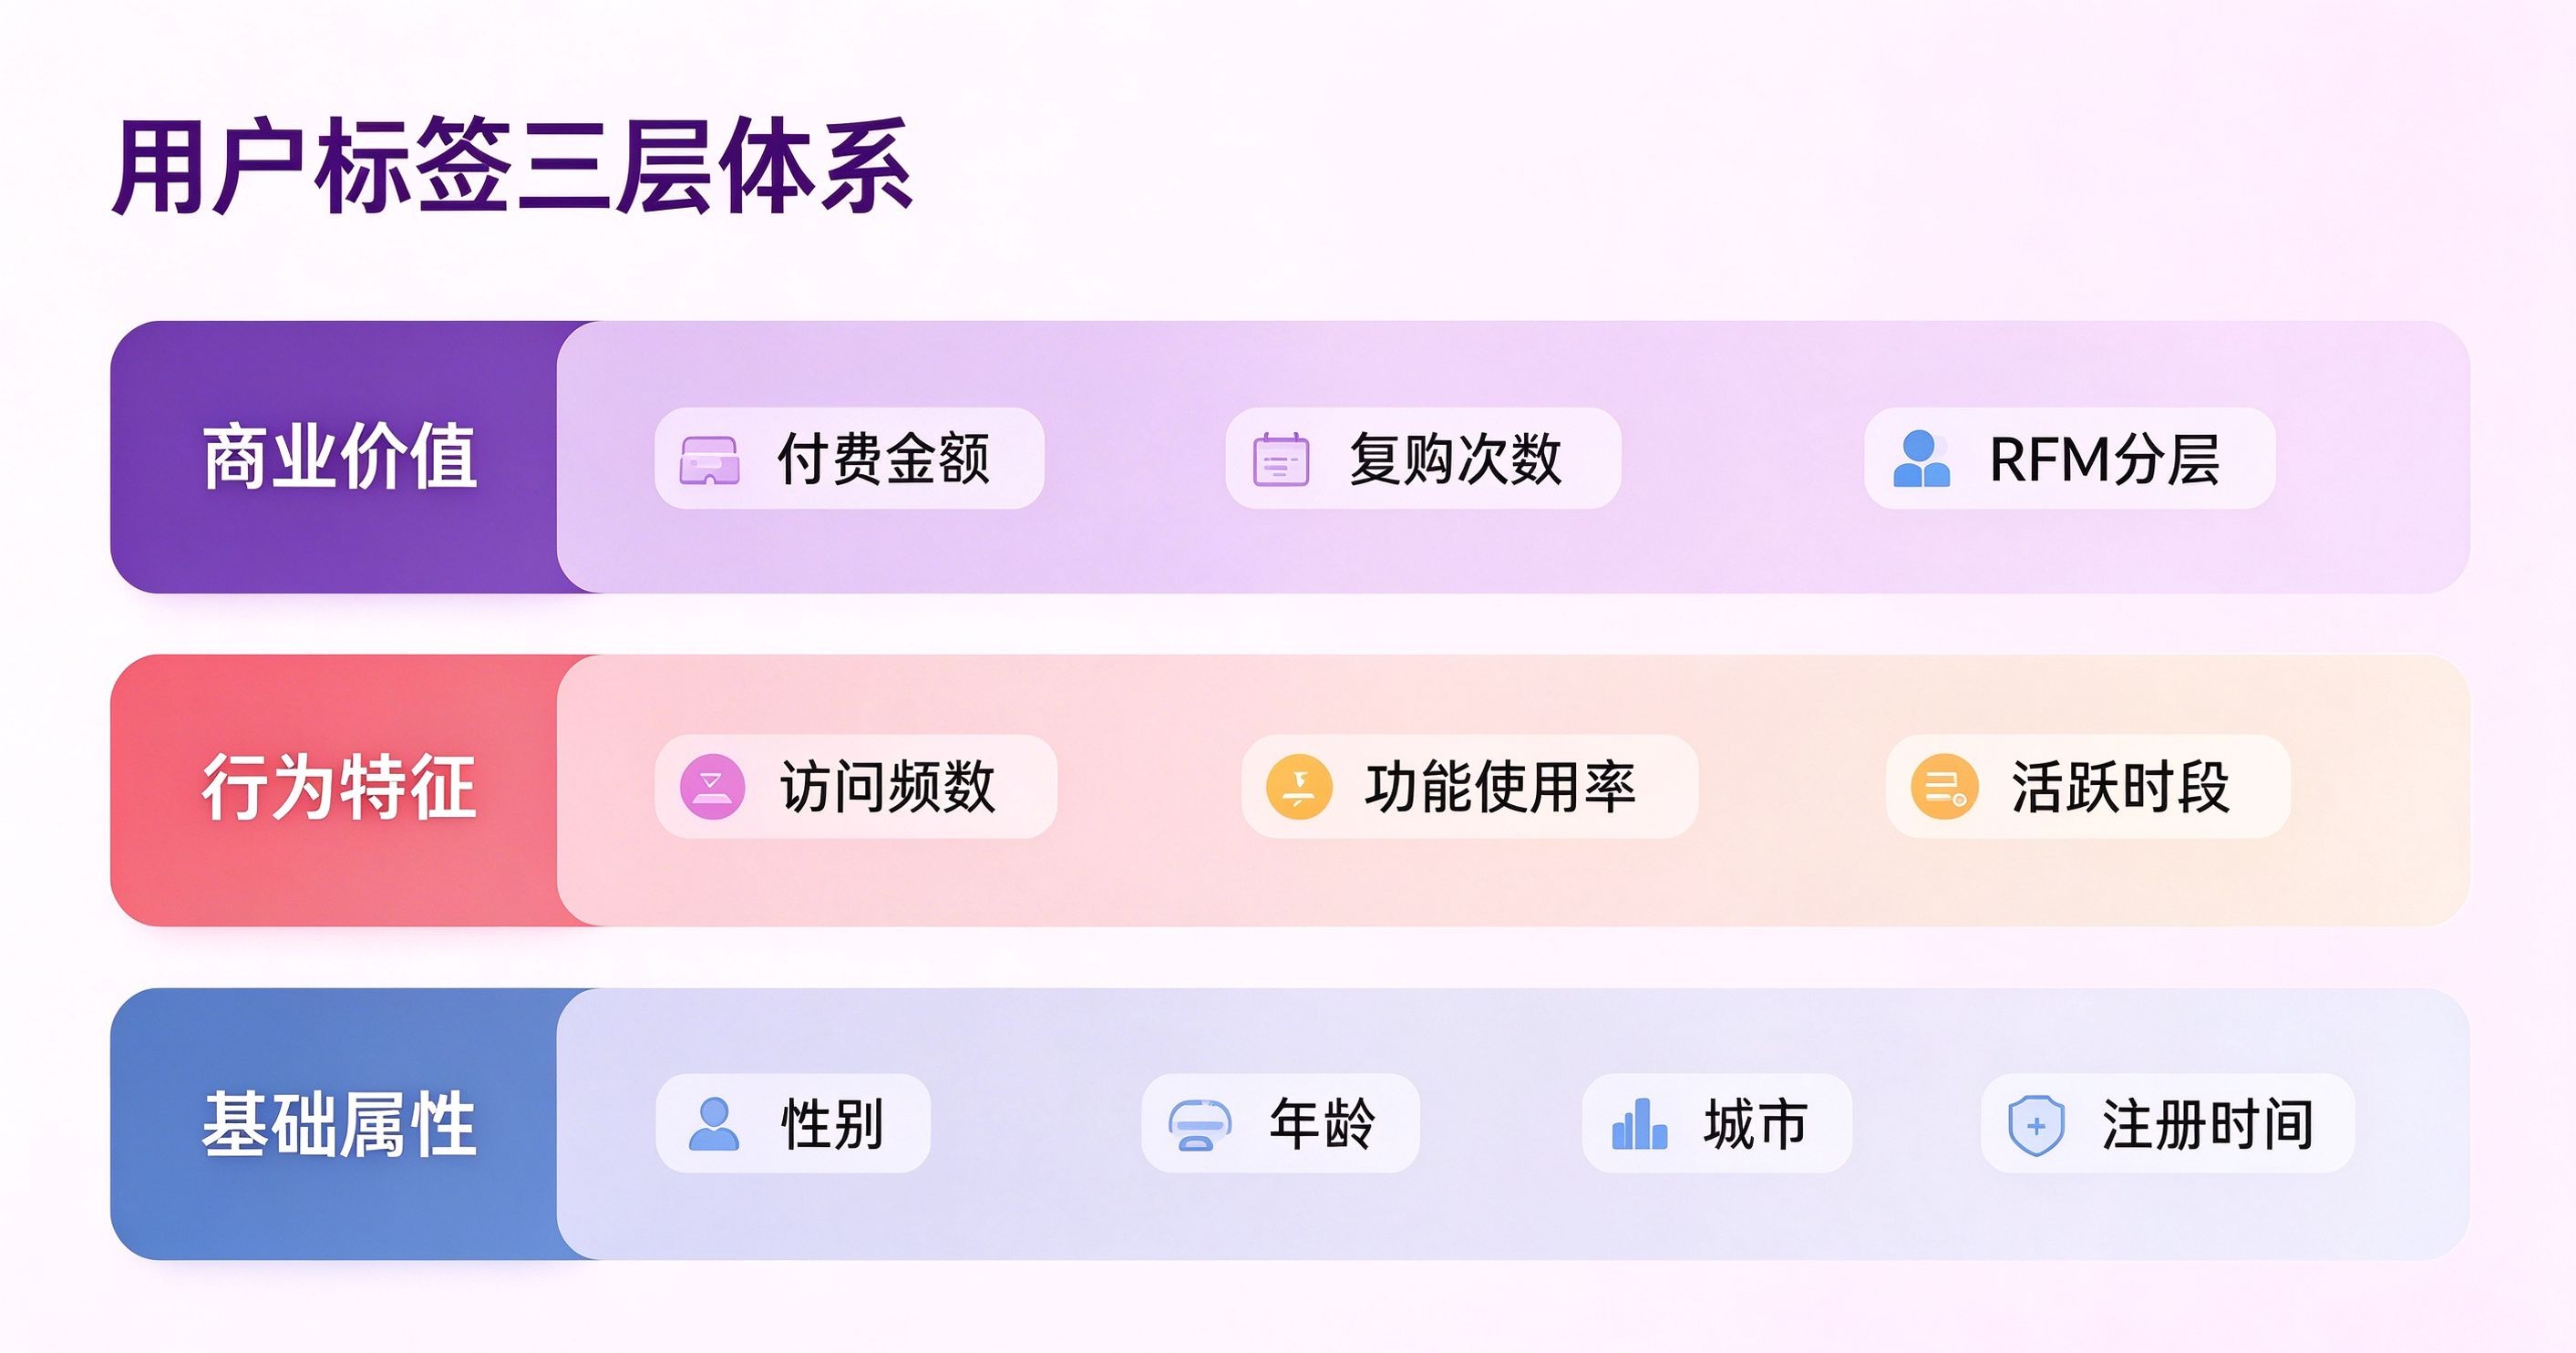
大模型评测的难点通常不在"测不准",而在"没想清楚要测什么"。我们的做法是先定维度,再谈指标。五个维度是起步配置,回答下面这张表里的问题:
| 维度 | 回答什么问题 | 评分方式 |
|---|---|---|
| 准确性 | 回答的事实对不对 | 和标准答案对比 |
| 完整性 | 有没有遗漏关键信息 | 检查是否覆盖所有要点 |
| 相关性 | 答的是不是用户问的 | 检查是否跑题 |
| 流畅性 | 语言表达是否通顺 | 语法、逻辑、可读性 |
| 安全性 | 有没有生成有害内容 | 检查是否触发安全红线 |
维度定了,还得给每个维度一个能落地的打分口径,不然评到一半又回到感觉。以准确性为例,光说"要准确"没法打分,得先定义什么叫错:我们做信息类问题,会预先写好标准答案和可接受口径,回答里数字对不上、主体张冠李戴,都直接算错,不给分。安全性最简单,命中红线词库直接判不通过,不参与后续评分。如果业务对输出格式有硬要求(比如必须返回 JSON),就在这五个维度之外再加一项"格式合规",按格式校验结果单独计分。
五维评测体系——从感觉变成可量化指标
二、怎么建立测试集
测试集规模没有统一标准,但有几个可以参照的口径。社区普遍认为,100-200条经过人工核验的样本是最小可行量,足够看出两个模型大约10个百分点的差距;要做更细粒度的对比,500条以上更稳。我们实际跑下来,单条业务场景(比如"埋点配置问答")先铺300条,按 6:2:2 分配——六成常见问题,两成边界情况,两成故意刁难的输入。每条样本固定包含三样东西:输入问题、标准答案、这个维度占多少权重。
别直接拿网上的通用测试集交差。MMLU 是业内常用的通用知识榜单,GPT-4 在 2023 年是 86.4%,现在头部模型已经摸到 90% 上下,榜单分数涨得很快——但榜单测的是模型上限,不是你的业务表现。你的用户不会问 MMLU 上的题,只会问你自己产品里的问题。通用测试集适合横向看模型能力,业务选型还得用自己的题库。
三、工具落地
落地我们分两步走。第一步攒题库:把用户真实问过的问题、运营整理的高频问题混在一起,人工写好标准答案,分批录进评测表格。第二步定期回归:模型一更新,整批重跑一遍,对比分数有没有掉。这个环节我们踩过坑——之前换过一次模型版本,流畅性看着涨了,准确率却掉了4个百分点,当时没跑回归直接上了线,后面靠线上反馈才发现的。现在评测集已经成了发版前的固定环节,跑完没问题才允许上。
如果你想量化"内容到底有没有效",可以接上456数据的渠道行为数据,把评测分数和用户转化放一起看:答得好的问题,是不是真的带来了更多停留和点击。评测分数说明模型答得对不对,行为数据说明用户买不买账,两个口径互补着看,比单看哪一边都靠谱。
大模型好不好用,别靠感觉。建测试集、设指标、定期回归,跑起来才有数。