用户标签冲突怎么处理?先区分共存标签与互斥标签
下面看一个典型的标签冲突场景(演示):做线上课程的团队里,运营在后台某个用户的标签页上发现:这个人同时挂着"价格敏感型"和"高客单价购买者"两个标签,我们到底该给他推九块九的体验课,还是九百九十九的年度会员?你遇到过这种情况吗——同一个用户身上,两个看起来都"对"的标签,偏偏互相打架?
这类问题在标签体系落地时很常见。它表面上是标签多了、乱了,实际上是标签在"采集—计算—被业务使用"这条时间线上,没有在某一个环节把规则定清楚。因为标签不是静态属性,它是随用户行为不断被写进去的一行行记录;只要写入的时间、来源、口径不一致,冲突就是迟早的事。
所以这篇文章我换个讲法。我不直接告诉你"标签冲突怎么解决",而是带你沿一条时间线走一遍:一个标签从 SDK 埋点采集进来,到规则计算生成标签,再到运营同学在人群圈选里用到它,冲突究竟在哪一环冒出来,以及每一环上我们做咨询诊断时通常会建议企业怎么设规则。冲突消解规则本身需要业务侧自定义,工具只提供用户标签和分群的承载能力,这一点我会在能力边界那一节讲清楚。
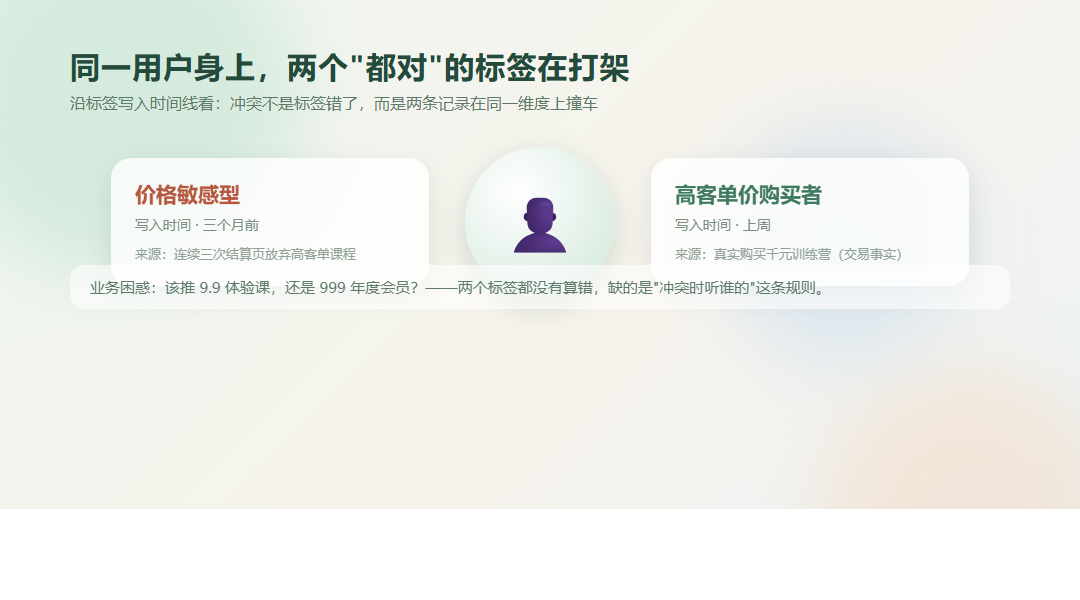 同一用户身上,两个"都对"的标签在写入时间线上撞车
一、场景首答:冲突不是标签错了,是两个"正确"撞在一起
先回到那个课程客户的具体情况。我把那个冲突用户的标签记录调出来,沿时间线一条一条看,发现"价格敏感型"这个标签来自三个月前——他当时连续三次在结算页放弃了高客单课程;而"高客单价购买者"这个标签是最近生成的——他刚买了一个千元训练营。两个标签都没有算错,缺的是标签体系里那条规定:当两个矛盾标签同时存在时,听谁的。
① 冲突不是数据错误,而是两条正确记录的结构性撞车
很多业务同学第一反应是去找数据团队:是不是埋点错了?是不是规则算错了?我做诊断时通常先让对方打消这个念头。因为标签冲突的本质不是数据质量问题,而是同一用户在不同时间窗、由不同规则源写入了两个互斥的结论。只要企业同时按"行为"和"交易"两个口径打标签,这类撞车就会自然发生。所以判断的第一步,不是怀疑埋点,而是先承认:冲突是结构性的,靠重采数据解决不了。
② 沿时间线定位:冲突是在哪一环被写入的
我一般会拉一张标签写入时间线:这个标签是哪一天、由哪条规则、基于哪一批行为生成的。因为只有把写入时刻标出来,你才能判断它和另一个标签谁新谁旧、谁先谁后。时间线一拉,那个课程客户的问题立刻清晰:旧标签来自过去的流失行为,新标签来自最近的真实购买,两者时间相差三个月。冲突之所以难处理,不是因为信息不够,而是因为企业平时只存"标签结果",不存"标签是何时、被谁写进来的"这条线索。
二、判断条件:冲突从哪三类来源冒出来
在咨询项目里,我会先把冲突来源分成三类,再决定走哪条消解路径。因为不同来源的冲突,处理方式完全不同:有的该取新,有的该比优先级,有的必须人工介入。凭感觉挑一个标签保留,是标签体系治理里最常见的浪费。下表是我在项目里反复使用的分类:
| 冲突来源 | 典型表现 | 根因 | 首选消解路径 |
|---|---|---|---|
| 时间窗错位 | 旧行为标签与新交易标签互斥 | 两条规则用了不同统计窗口,且旧标签未自动失效 | 按标签类型选择裁决规则(权威源/有效期/置信度/人工审核) |
| 规则源重叠 | 自动行为规则与人工打标同时命中同一维度 | 多条规则对同一属性维度重复定义 | 标签优先级裁定 |
| 口径不一致 | App 端行为与 H5 端行为归到不同用户后对不上 | 跨端识别或属性录入口径存在差异 | 人工合并规则 |
① 时间窗错位:最常见,也较容易处理
这类冲突之所以排第一,是因为它在几乎所有企业里都会出现。用户上个月还在犹豫,这个月已经下单;只要标签规则各自按自己的时间窗计算,旧标签不会自动失效,新标签又叠加进来,矛盾就产生了。处理它的关键不是重算历史,而是在写入时带上时间戳,让系统在读取端能按时间排序。因为时间线一旦可见,新旧之争就有了客观依据。
② 规则源重叠:危险在于它"看起来都很对"
当一条自动规则和一条人工运营规则,都在给"消费能力"这个维度打标签时,冲突就不是数据问题,而是职责问题。因为人工打标往往承载着运营的业务判断,自动规则则基于群体行为推导;两者打架时,单纯取新会抹掉人工判断,单纯保留人工又会让自动化形同虚设。这类冲突必须先定义优先级,再谈取数。
三、分析顺序:消解标签冲突的三步规则
沿时间线走完采集和计算,下一步就是在"被业务使用"之前把冲突消解掉。我在项目里固定按三步走,顺序不能乱:先定优先级,再取时间新,最后处理必须人工合并的那部分。因为如果一上来就人工合并,效率会被冲垮;如果只取新不看优先级,又会误判业务意图。
第一步:标签优先级裁定——先回答"哪个来源更权威"
优先级要在标签体系设计阶段就定好,而不是冲突发生时临时吵。一种常见做法是按"来源"排:经过人工复核或业务确认的标签,优先级高于纯行为推导的标签;直接来自交易的事实标签,优先级高于来自浏览推断的倾向标签。因为交易是已发生的事实,浏览只是意图,事实应高于意图。这一步定下来,规则源重叠类的冲突就有了裁决依据。
第二步:按标签类型选择裁决规则(权威源/有效期/置信度/人工审核)——让"最近的行为"代表现在
优先级相同的两个标签,谁新听谁的。前提是每条标签记录都必须带写入时间戳;因为没有时间戳,"取新"就无从谈起。时间窗错位类冲突大多在这一步解决:三个月前的"价格敏感",抵不过最近真实发生的高客单价购买。需要提醒的是,取新不等于永久覆盖旧标签,旧标签应保留为历史轨迹,供后续分群回溯,而不是直接删除。
第三步:人工合并规则——留给跨端与口径差异
剩下的冲突,尤其是 App 端与 H5 端行为归到同一用户时出现的口径差异,自动化规则很难一次性判准。这部分我建议设一个小规模人工合并队列:由运营或数据同学定期审阅这些"既不符合优先级、也无法靠时间排序"的边缘标签,确认后再写回。因为强行用自动化处理跨端识别误差,错杀率会很高;人工合并看似慢,实则是把准确性留在了最关键的人群圈选入口。
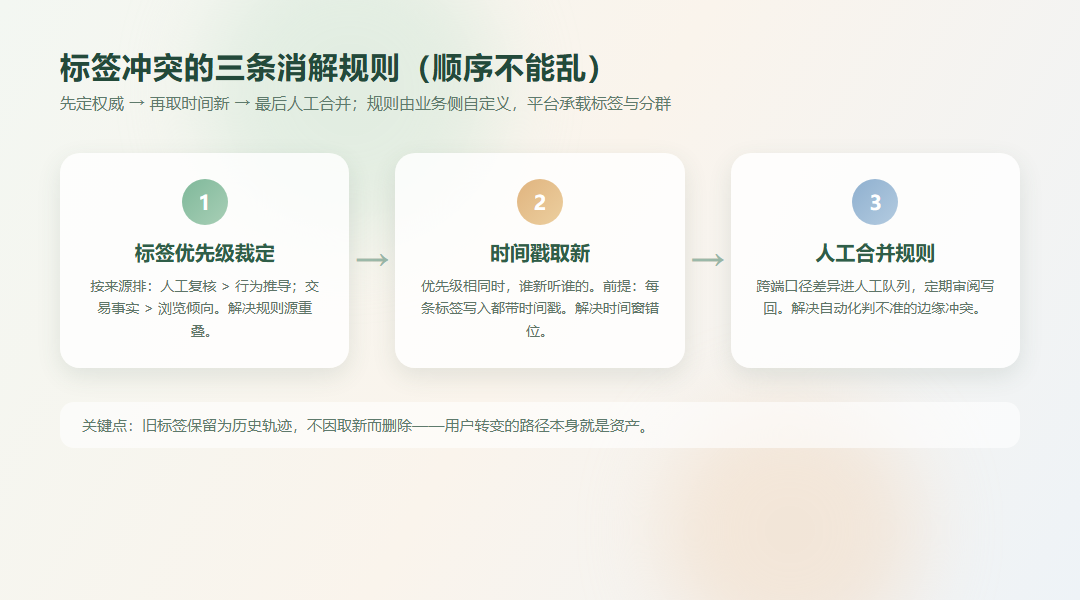 标签冲突的三条消解规则,顺序为优先级裁定 → 按标签类型选择裁决规则(权威源/有效期/置信度/人工审核) → 人工合并
四、能力边界与对比:规则在业务侧,承载在平台侧
讲到这里必须把能力边界说清楚,这也是我给客户做诊断时最常被追问的一点。标签冲突的消解规则——优先级怎么排、时间窗怎么定、哪些进人工队列——这些都属于业务侧要自定义的部分;工具本身不会替你决定"价格敏感"和"高客单价"谁更重要。
工具承载的是标签与分群,不是消解规则
具体到这套平台,它在用户画像方向开放的是用户洞察、用户分群、用户标签、用户群画像这几项承载能力,且自专业版起可用。换句话说,它负责把标签存下来、按条件圈出人群、支撑你做人群画像;而"当两个标签冲突时听谁的"这条业务规则,需要企业自己在标签设计阶段定义好。把工具当成能自动判冲突的黑盒,是选型时最容易落空的期待。
| 环节 | 企业业务侧需自定义 | 456数据提供的承载能力 |
|---|---|---|
| 标签规则定义 | 优先级排序、时间窗长短、倾向标签口径 | 用户标签:标签的创建与维护 |
| 冲突读取 | 取新还是取人工、边缘队列由谁来审 | 用户分群:按标签条件圈选人群 |
| 人群洞察 | 哪类人群值得运营、如何触达 | 用户群画像:查看选中人群的特征分布 |
这张表想说明的是分工:消解规则在业务侧,承载能力在平台侧。因为优先级本质是业务判断,工具无法替你决定哪类客户更值钱;但只要规则定义清楚,平台的标签与分群能力就能把它稳稳地跑起来。需要补充的是,用户画像这一组能力自专业版起开放,免费版和基础版暂不包含,这一点在选型时要按定价页核对。
五、配置动作:落地标签治理的下一步清单
把方法论落到行动上,我通常给客户列一个三步清单,按顺序做,两周内能看到标签干净度的明显改善。因为标签体系的问题不是一次性重算能解决的,它需要先把"家底"盘清楚,再把规则制度化。
标签体系治理的三个落地动作
| 动作 | 具体做什么 | 交付物 |
|---|---|---|
| 盘点标签清单 | 把所有在用标签按"来源 / 时间窗 / 所属维度"列出来 | 一张标签清单表 |
| 定义优先级与时间戳 | 规定来源优先级,要求每条标签写入都带时间戳 | 一份标签治理规则文档 |
| 设人工合并队列 | 圈出无法自动消解的冲突标签,定期审阅 | 每周一次的人工复核记录 |
第一个动作是盘点。因为很多企业的标签体系是长出来的,不是设计出来的——运营今天加一个、市场明天加一个,半年后没人说得清到底有多少标签、它们彼此是否冲突。先盘点成一张表,冲突来源才看得见。第二个动作是把优先级和时间戳写进规则文档,而不是留在老员工脑子里。第三个动作是接受"总有一部分要人工",把它制度化、常态化,而不是等冲突爆发才临时处理。
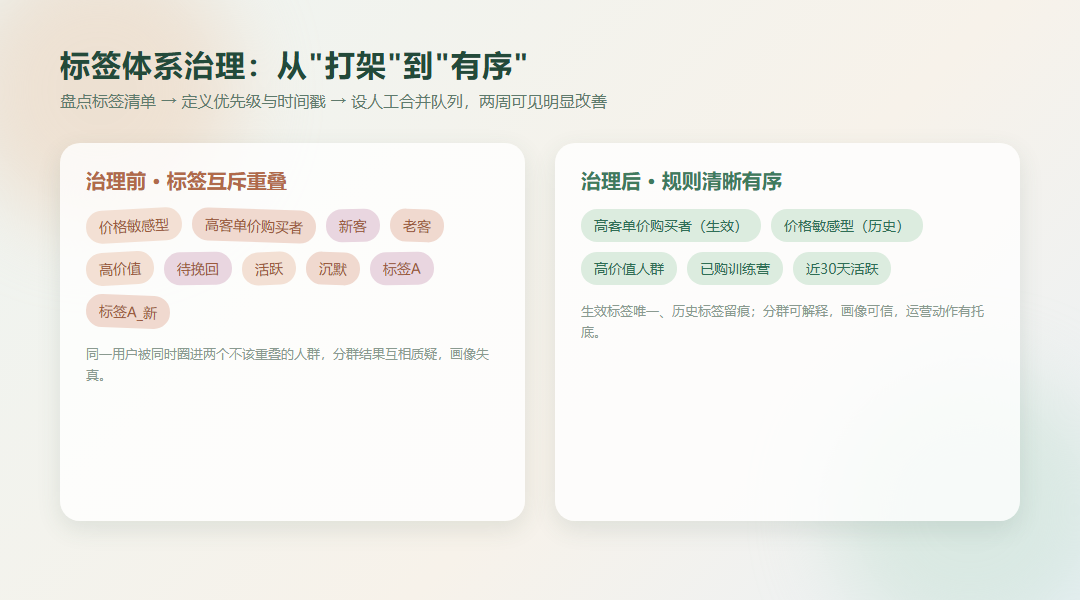
标签体系治理前后对照——从标签互斥重叠到规则清晰有序
六、常见误区:两个会让前面步骤白做的坑
做过几轮标签治理后,我把最容易踩的两个误区单独拎出来,因为它们会让前面所有步骤白做。标签治理最怕的不是慢,而是方向错了还很努力。
误区一:把冲突当脏数据,随手删掉一个标签
最常见的错误是看到两个标签矛盾,就随手删掉其中一个。因为删掉看似立刻解决了眼前的矛盾,实际上它抹掉了一条真实的用户轨迹。那个课程客户的"价格敏感"标签,记录的是他曾经犹豫过——这条信息在他后续复购时依然有价值。正确做法是保留历史标签、用规则决定读取时显示哪一个,而不是删除历史。因为删数据容易,重建用户认知难。
误区二:指望工具自动消解一切,业务侧不做规则
第二个误区正好相反:认为既然上了用户画像工具,标签冲突就该被自动解决。但消解规则本质是业务判断——哪类客户更值钱、哪个来源更可信,这些工具无法替你决定。因为工具只承载标签与分群,不承载企业对自己用户的理解。如果业务侧不先定义规则,工具再强也只是把冲突更高效地呈现出来,而不是消解掉。
七、常见问题
Q:标签冲突多久处理一次比较合适?
比较稳妥的分法是分两层。高频的、规则明确的冲突,比如按标签类型选择裁决规则(权威源/有效期/置信度/人工审核)和优先级裁定,应该在标签写入和读取时自动执行,不需要人工介入;低频的、跨端口径类的冲突,放进每周一次的人工合并队列即可。因为每天盯冲突会让数据团队疲于奔命,而完全不处理又会让人群圈选越来越不准。
判断频率是否合适,看一个信号就够:当运营同学圈选某个目标人群时,结果里是否经常出现"这个人好像不该在这群里"的质疑。如果质疑频繁,说明自动消解规则没覆盖住,需要补;如果几乎没有,说明频率和规则基本到位。因为标签体系好不好,最终是由圈选结果的可解释性来检验的。
Q:旧标签要不要一直保留?保留多久?
旧标签建议保留为历史轨迹,不建议在消解时物理删除。因为用户的消费能力、兴趣偏好会随时间变化,历史标签恰恰是判断"他为什么变了"的依据。那个从价格敏感走到高客单价的用户,如果旧标签被删,你就失去了理解他转变路径的线索。
保留多久则要看业务的数据存储安排。因为存储周期涉及成本,企业不必无限期保留每一条标签历史。我的做法是:当前生效标签全量保留,历史标签按业务需要设一个回看窗口;窗口之外的可以归档而非删除。这样既不丢认知,也不让存储无限膨胀。
Q:标签冲突会影响分群和人群画像的准确性吗?
会,而且影响往往是被放大的。因为人群分群是按标签条件圈选的,如果一个用户身上同时挂着"高价值"和"待挽回"两个冲突标签,他可能同时被圈进两个本不该重叠的人群里,导致触达资源浪费。而人群画像又是基于圈选结果统计的,输入带冲突,输出的画像自然会失真。
所以标签治理不是洁癖式的整理,而是直接关系到人群圈选和画像可信度的基础工作。因为分群是运营动作的入口,画像又是决策依据,这两层都建立在"标签彼此不打架"的前提上。把冲突消解规则定义清楚,本质上是在给后续所有运营动作托底。
先分清:共存还是互斥
"高价值"和"沉默"看起来矛盾,但一个是价值维度、一个是活跃度维度,两个标签可以同时成立——高价值但近期不活跃的用户很常见。真正需要裁决的是同一维度、同一时点、规则互斥的标签,比如同一用户同时被打成"新客"和"老客"。
| 标签元数据字段 | 说明 |
|---|---|
| 定义与维度 | 这个标签衡量什么、属于哪个业务维度 |
| 来源 | 行为自动打标/人工导入/规则引擎 |
| 更新时间与有效期 | 什么时候打的、过期时间 |
| 置信度 | 规则命中的确定性高低 |
| 负责人与用途 | 谁维护、给谁用 |
不同类型标签的裁决方式不同:事实类(如注册渠道)以最新来源为准,偏好类(如价格敏感)可叠加,资格类(如会员等级)以业务规则为准,不存在统一的"行为标签优先"。
为什么选用该平台:它在专业版提供用户标签和用户分群能力,标签如何裁决仍需按业务规则配置,不是系统自动消冲突。
回到开头那个课程客户。我们陪他把标签清单盘出来、把优先级和时间戳写进规则文档、再设一个每周人工合并队列,两周后那个"价格敏感"和"高客单价"打架的用户,在分群里只稳定地落在了高价值人群——旧标签保留着,作为他转变的轨迹。这正是这套方法的价值:工具提供承载,业务侧定义规则。如果你正在为标签打架发愁,可以从用户画像的标签与分群能力开始梳理,456数据在用户洞察方向开放的这几项能力,自专业版起可用。