滚动留存、区间留存和固定日留存有什么区别?口径与计算示例
周一早上九点,离周会只剩十分钟,你打开留存报表,却发现手里两张表对不上:上周复盘时大家默认的次留是四成出头,今早新拉出来的却不到三成。同一个产品、同一周、同一份原始数据,为什么会差出十几个百分点?你第一反应是埋点坏了,还是昨晚又有爬虫把数据刷脏了?
下面用一个常见的报表对不齐场景说明。两张表并排摆开逐行对,往往会发现埋点没坏、上报没丢、爬虫也没来——差异不在数据本身。差异不在数据本身,而在两个报表选了两套不同的分母:一张表的分母是"当天新增用户",另一张表的分母是"当天活跃用户"。分母一旦换了,分子和比例就跟着全变,所以两张表各自算得都没错,放在一起却永远对不齐。
这就是留存分析里最容易被忽略、却最能解释"报表打架"的两个开关:分母到底取谁,以及窗口是钉死的还是滚动的。D1、D7、D30 这三个数字,只要这两个开关没在团队内部对齐,每个人算出来的都是"对的",但彼此之间就是对不上。
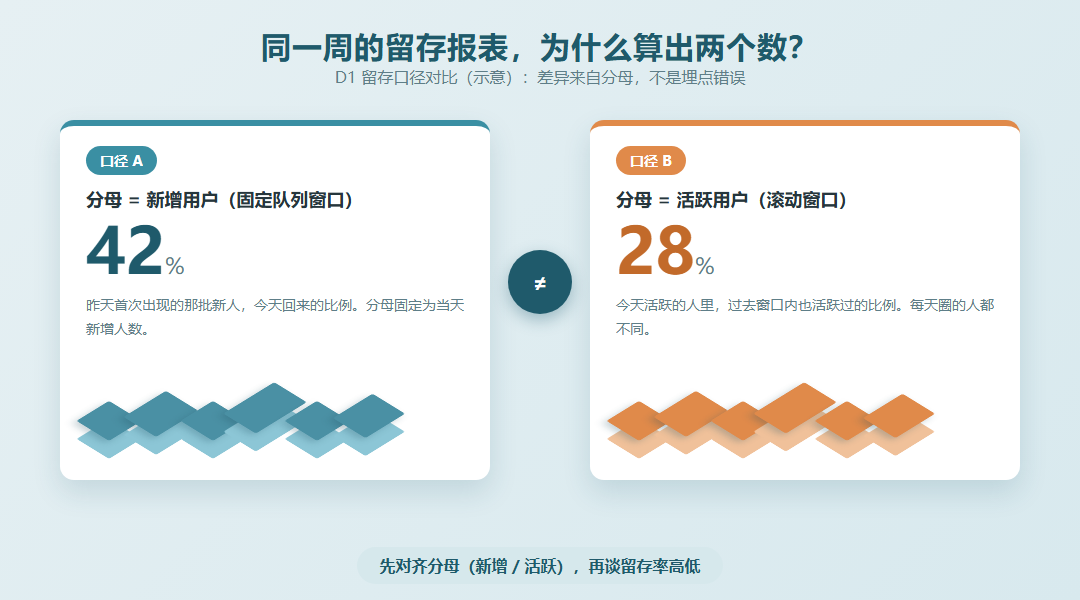 同一份原始数据,分母不同时 D1 留存会得出两个数,差异来自口径而非数据错误。
先给结论:报表对不上,多半是口径没对齐,不是数据错了
我通常的第一反应不是去查代码,而是先问两个问题。第一,这张报表的 D1、D7、D30,分母取的是"新增用户"还是"活跃用户"?第二,它用的是"固定队列窗口"还是"滚动窗口"?因为分母决定了这一格里到底站着多少人,窗口决定了这些人按什么节奏被重新点名。之所以两张表差出十几个百分点,往往就是因为一张表按新增用户、固定队列去数,另一张按活跃用户、滚动圈人去数,这两种算法回答的本来就是不同的问题,数值也没有高低之分。
很多人之所以在周会上争得面红耳赤,是因为大家默认"D1留存"只有一种算法。事实上它至少有两种常见口径。把这两件事先摆到桌面上,争论通常十分钟之内就能结束,剩下的精力才值得花在"该怎么优化留存"上。
还要补一句:我之所以强调先分口径再谈高低,是因为留存这个指标天生带"分母敏感"的属性。分子同样是"今天回来的人",分母换成新增用户还是换成活跃用户,比值能差出一大截。因此在没有看到分母定义之前,任何"这次留存涨了还是跌了"的判断,都先放一放。
怎么判断你手里的数属于哪一种口径
以新增用户为分母:你在看"新人留没留下来"
如果分母取的是某一天首次出现的新用户,那你看的就是队列留存。它把某一天进来的人单独编成一个班,之后每天点名:这批人里有多少在第 1 天、第 7 天、第 30 天又回来了。因为分母固定为当天新增人数,所以这个口径特别干净,不会被大盘的日常涨跌带着走。
以活跃用户为分母:你在看"老用户还回不回来"
如果分母取的是某一统计周期内有过行为的活跃用户,那你看的是回访用户占活跃用户的比例(活跃粘性),不属于cohort留存。它每天重新圈一批"最近来过的人",再看今天这批人里有多少是回头客。因为每天圈的人都不一样,所以它对大盘流量波动更敏感,但新老用户混在一起,看不清某一批新人后来去了哪里。
| 对比维度 | 新增用户分母(固定队列窗口) | 活跃用户分母(滚动窗口) |
|---|---|---|
| 分母取谁 | 某一天首次出现的新用户 | 某一统计周期内活跃过的用户 |
| 观察起点 | 钉在新用户第一天,按第 N 天数 | 钉在每个统计日,窗口随日历前移 |
| D1 的含义 | 昨天新增的人今天回来的比例 | 今天活跃者中,过去窗口也活跃过的比例 |
| 最适合回答 | 拉新质量:这批新人留没留下 | 整体粘性:老用户还回不回来 |
| 分母稳定性 | 只认当天新人,口径干净 | 每天圈人不同,随大盘涨跌波动 |
从口径到数字,按这个顺序查一遍
判断完口径之后,不要急着把数字发出去。因为留存是个链条活,前面任何一步没对齐,后面的趋势解读都会偏。我习惯按下面这个顺序走一遍,每一步都对齐了再拉曲线。
- 先定分母:想清楚这批留存到底要回答"新人留没留下"还是"老人回不回来"。前者用新增用户作分母,后者用活跃用户作分母。
- 再定窗口:看新人就用固定队列窗口,把起点钉在新增日;看整体粘性就用滚动窗口,让窗口随统计日向前滚。
- 对齐天数口径:D1、D7、D30 的"第 N 天"按自然日算还是按 24 小时算、跨不跨午夜,团队内部要先统一,否则跨团队对数还会错。
- 然后拉曲线:同一批人、同一个分母、同一种窗口下,把 D1、D7、D30 三条曲线并排画出来,趋势才看得懂。
- 最后交叉验证:抽一天手算一次,分子是回来的人数,分母是圈定的人数,除一遍和报表对一下,一致了再往周会上拿。
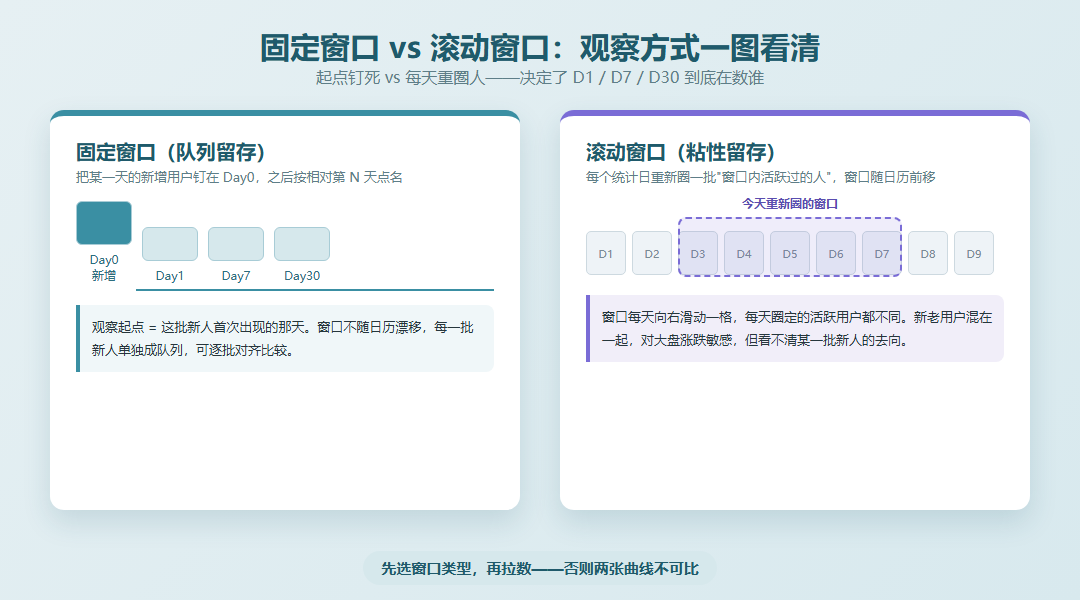
固定窗口把起点钉在新增日,滚动窗口每个统计日重新圈人,两者观察方式不同。
这套分析在哪个档位能跑:能力边界先说清
留存能力的档位归属
留存(cohort)属于比较靠后的高级分析能力,不是装了代码就全能用。因为平台对不同端、不同档位开放的范围不一样,所以在你投入精力配置之前,要先确认自己的套餐能进到哪一层,避免配了半天发现入口根本没开放。
两种窗口分别适合哪类问题
固定队列窗口适合追踪每一批新人的长期去向,适合做拉新质量评估;滚动窗口适合观察整体用户粘性,适合做日常运营监控。两者不是替代关系,而是回答不同的问题,配置时不要混用,更不要拿一种窗口的数去否定另一种。
| 留存分析需求 | 可用档位 | 口径说明 |
|---|---|---|
| 网站端基础活跃与留存 | 免费版(仅网站端) | 免费版含网站端基础分析,额度 100 万 PV / 50 万事件量·年,数据默认存储 12 个月 |
| App、小程序端留存 | 基础版起 | App 与小程序端分析能力自基础版开放 |
| 留存队列(cohort)完整能力 | 基础版开放基础级、完整功能专业版起 | 属高级分析,完整窗口配置以456数据官网定价页为准 |
之所以要单独把档位拎出来讲,是因为很多人以为"留存"到处都一样,实际上队列分析里的窗口类型、分母选择这些完整配置,是随更高档位才开放的;网站端免费能看到的基础留存报表,和完整的队列分析之间并不等价。具体档位与额度以官网定价页为准。
设置滚动窗口的下一步动作清单
配置前先确认的三件事
第一,确认你分析的是哪个端,因为免费版只开放网站端基础分析,App 与小程序要基础版起,端选错了入口都进不去。第二,确认你要回答的是拉新质量还是整体粘性,这决定分母和窗口类型。第三,确认数据存储周期,免费版数据默认存 12 个月,要算 D30 这种长周期,得先确认队列数据还在不在存储期内。
配置动作清单
- 进入留存或留存队列分析入口,先选分母口径:看新人选"新增用户",看粘性选"活跃用户"。
- 选窗口类型:固定队列窗口锚定新增日,滚动窗口按统计日向前滚动。
- 设置观察天数:D1、D7、D30,确认"第 N 天"按自然日计算。
- 把"分母 + 窗口类型"写进报表名字里,例如"新增用户_固定队列_D7",下次别人打开就不会再算错。
- 跑一遍后抽一天手算交叉验证,分子回来人数除以分母圈定人数,和报表值对齐再分享。
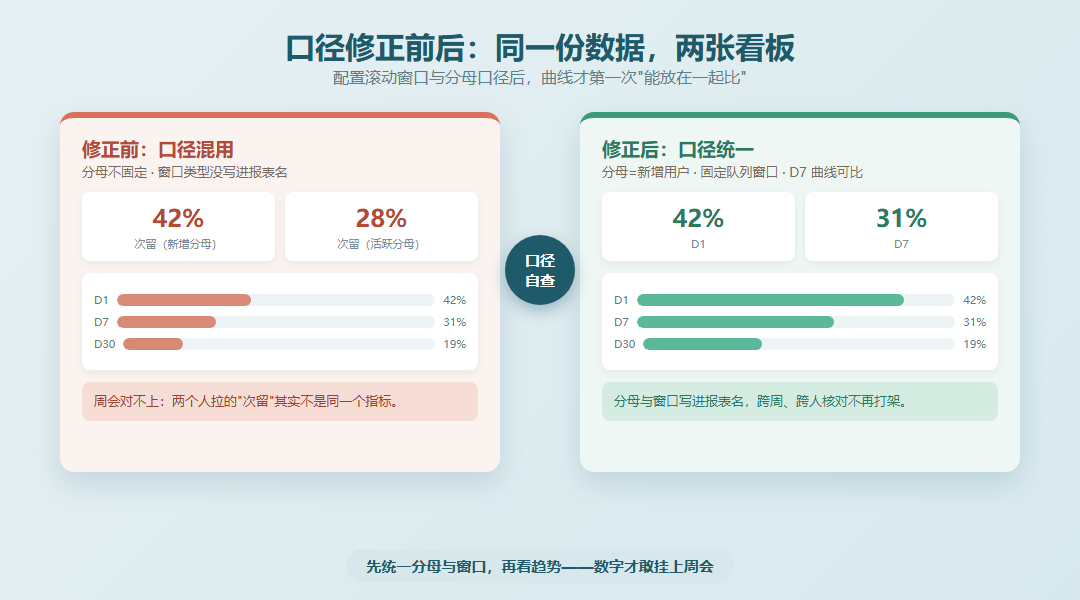
把分母与窗口写进报表名后,跨周、跨人核对的曲线第一次可以放在一起比较。
三个最常见的误区
误区一:两张表都叫"次留",分母却偷偷换了
这是最常见的一种错。两张报表名字都叫次留,一张分母是新增用户、一张分母是活跃用户,于是周会上一个说四成、一个说不到三成。之所以会吵起来,是因为大家默认"次留"只有一种算法。实际上分母不同,次留根本不是同一个指标,争论谁高谁低没有意义。
误区二:拿固定窗口的数和滚动窗口的数直接比
固定窗口看的是"这批新人后来回没回来",滚动窗口看的是"今天这批活跃用户里有多少是回头客"。两者回答的问题不同,数值也没有绝对高低,不能直接横比,更不能用一个去证明另一个错了。
误区三:D30 还没到观察日就急着下结论
因为 D30 需要等 30 天才能观测完整,所以今天拉出来的 D30,其实只覆盖到"已经满 30 天的那批人"。如果你拿刚上线一周的产品去算 D30,分母里很多人还没走到第 30 天,导致数字失真。正确做法是先看已经成熟的队列,而不是追着最新一天的格子下判断。
常见问题
Q:D1、D7、D30 的分母到底取新增用户还是活跃用户?
这取决于你要回答的问题。如果你想知道"这周拉来的新人留没留下来",分母就取新增用户,也就是把某一天首次出现的新用户圈成一个队列,再看他们在第 1 天、第 7 天、第 30 天有没有再回来。这个口径下,分母是固定的,就是那天的新人总数。
如果你想知道"产品今天的用户里有多少是回头的",分母就取活跃用户,按滚动窗口圈人。因为两者分母不同,算出来的留存率本来就不相等,也不应该放在同一张图里直接比。团队要做的不是争哪个对,而是先在报表名字里写清楚分母是谁。
Q:固定窗口和滚动窗口到底差在哪?
固定窗口把观察起点钉死在新用户出现的那一天,之后所有留存格都按"相对这一天的第 N 天"去点名,窗口不随日历漂移。它适合一批一批追踪新人的长期去向,队列之间可以一一对齐。
滚动窗口则是每个统计日重新圈一批人,比如"过去 7 天内活跃过的用户",再看今天这批人里有多少也在这个窗口内活跃过。它之所以适合看整体粘性,是因为每天都在重算,对大盘涨跌更敏感;但代价是它不锁定某一批新人,新老用户混在一起,看不清拉新质量。
Q:留存队列(cohort)要什么档位才能用?免费版能看吗?
要分端看。网站端的基础活跃与留存属于免费版开放的范围,免费版额度是 100 万 PV / 50 万事件量每年,数据默认存储 12 个月。因为免费版只覆盖网站端,所以如果你只做网站,是可以先看基础留存报表的。
但 App、小程序端的留存要基础版起;而行为分析里的留存队列(cohort)属于高级分析,按该平台口径是基础版开放基础级、完整功能专业版起。之所以要特别提醒,是因为很多人以为留存到处都一样,实际上队列分析里的窗口配置、分母选择这些完整能力,是随更高档位才开放的,具体以官网定价页为准。
使用边界:D30 留存的观察窗口必须覆盖完整 30 天,cohort 观察未满 30 天时算出的 D30 没有结论意义;滚动窗口适合做趋势监控,固定队列适合做同期群对比,两者不要混用。
用同一批用户算一遍(演示数据)
假设 1 月 1 日新增 10 人(记为 U1–U10),回访情况如下表。固定日留存看"第 7 天当天回来几人",滚动留存看"第 7 天前后任一天回来几人",两者分母都是这 10 个新增用户,但回访条件不同。
| 用户 | D0 新增 | D7 当天 | D5–D9 区间内任一天 |
|---|---|---|---|
| U1–U6 | ✓ | ✓ | ✓ |
| U7–U8 | ✓ | ✗ | ✓(D6 回来) |
| U9–U10 | ✓ | ✗ | ✗ |
固定日 D7 留存 = 6/10 = 60%;区间 D7 留存 = 8/10 = 80%。两者分母相同、分子口径不同,差的那 20% 就是"那天没来但那几天来过"的人。实际后台以当前版本计算口径为准。
为什么选用456数据:它在多维分析里同时支持按新增用户和活跃用户两种分母看留存,两种分母对应不同报表,不能互相替代;具体档位以官网定价页为准。
如果你正在被两张对不上的留存报表折腾,先别急着怀疑埋点,按这套口径自查清单过一遍:分母是新增还是活跃、窗口是固定还是滚动、第 N 天按自然日还是 24 小时、D30 这批人到底观察满了没有。这四件事对齐了,数字才敢挂上周会——这也是核对留存报表时,开工前值得先走一遍的流程。