标签重叠严重?互斥人群分群的三条规则
上周连着开了三个会:市场部要一个“潜客人群包”,运营部要一个“活跃用户包”,销售部要一个“高意向客户包”。三个包都从我这出,听起来不复杂。可等三个包的人数摆到一张表上,问题就来了——加起来 8.2 万人,我拿去重,真实去重后只有 5.1 万。也就是说,有 3 万多人同时躺在两三个包里,被三个部门反复触达,预算也被重复算了一遍。之所以会变成这样,不是哪个同事圈错了,而是从头到尾没人规定过“同一个人到底算谁的”。更直接的后果是,同一个客户一天能收到三条不同部门的推送,体验差到直接取关。
一、重叠是怎么自然发生的
把三个包的条件摊开看就明白原因了。市场圈“近 30 天访问过官网”,运营圈“近 7 天打开过 App”,销售圈“加过企业微信且咨询过价格”。这三件事本来就会发生在同一批人身上——一个真正感兴趣的潜在客户,大概率既上过官网、又打开过 App、还咨询过价格。没有谁设错条件,三个条件单独看都合理,叠在一起却高度重合。
重叠不是粗心造成的,而是“各部门按自己目标独立圈人”这件事的必然结果。只要缺少一条统一的归属规则,人群包就会像三张重叠的圆一样,谁都觉得这个人归自己。更麻烦的是,这种重叠平时看不见:每个部门报上来的人数单独看都挺合理,只有把三张包叠在一起去重,才会发现预算被重复花在了同一批人身上。
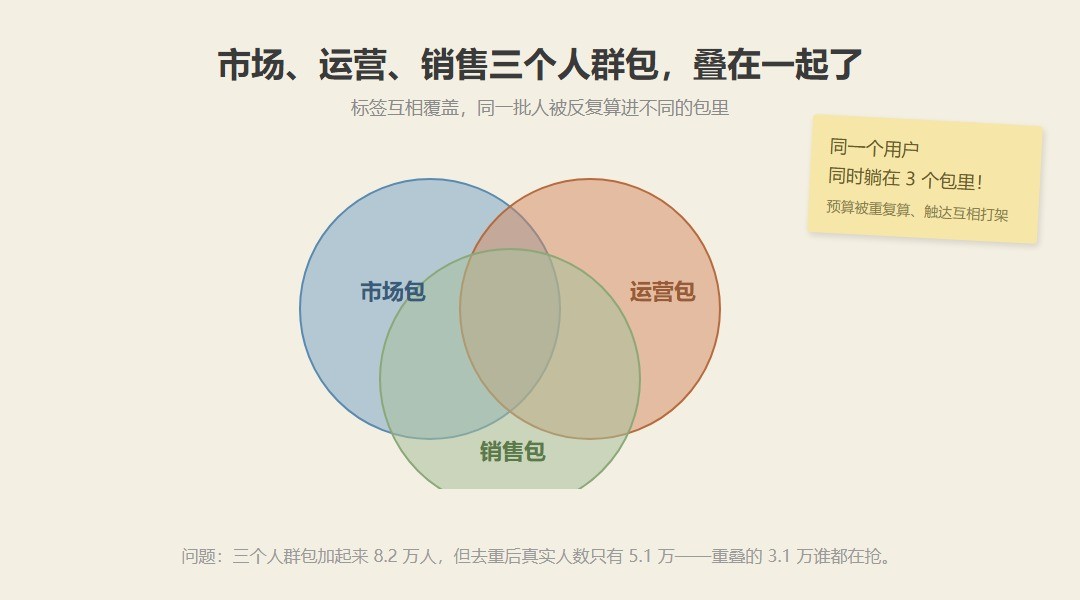 市场、运营、销售三个包各自合理,叠在一起却大面积重叠。
二、把人群切成互斥,靠三条原则
要让一个人只属于一个包,光靠口头约定“你们别重复”是没用的,必须在规则层把重叠堵死。三件事一起做才管用:
| 原则 | 解决什么问题 | 具体怎么做 |
|---|---|---|
| 分群优先级排序 | 一个人同时命中多个包时,听谁的 | 给包定先后,先命中的那个包把人带走 |
| 排除条件(not in) | 规则上杜绝重复入选 | 后建的包显式排除已被前圈圈走的人 |
| 同一统计时点快照 | 各包口径错位 | 所有包都按同一天的数据圈人 |
三条原则,缺一条都有漏洞
三条必须一起上,单做哪一条都有漏洞。只排优先级、不写排除条件,规则上仍可能让人同时满足两个包;只加排除、却各取各天的数据,这个包按今天、那个包按上周,人数还是对不平。三条合起来,才能从“约定”变成“规则”。其中“同一统计时点”这一条最容易被忽略:市场部按周一的数据圈人、运营部按周五的,哪怕前两条都做了,两边圈的也根本不是同一批人,互斥自然无从谈起。
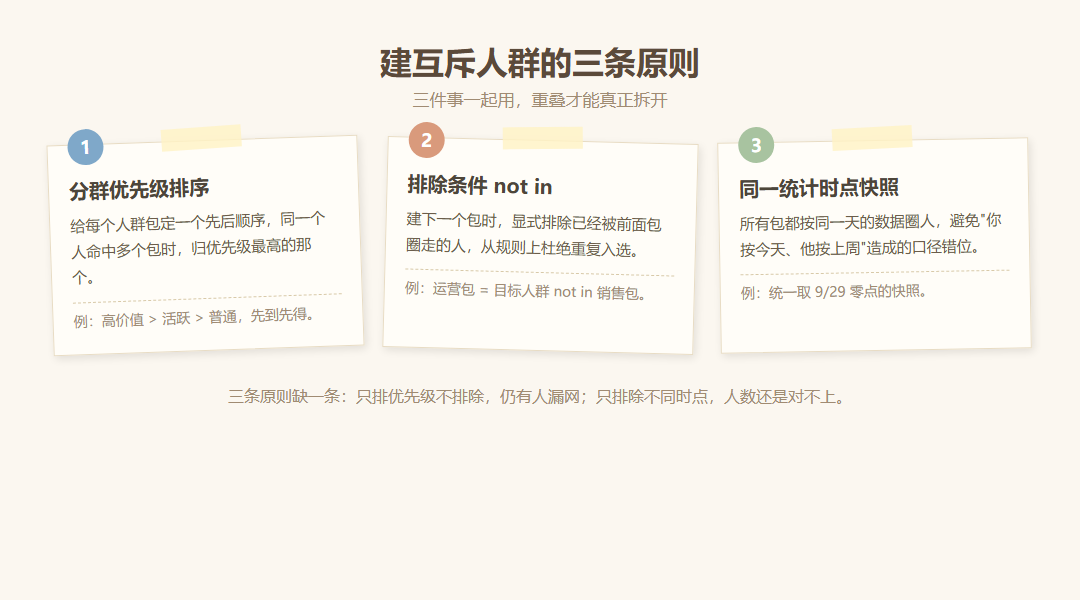 优先级、排除条件、同一时点快照,三条原则缺一不可。
三、优先级这张表,该怎么排
优先级不是产品经理一个人拍的,得拉三个部门一起对齐。一个可参考的排法,是按“越值得被独占、越难再触达”的顺序往前放:高价值付费用户排最前,其次是活跃高意向,再往下是普通活跃,最后是沉睡待召回。这么排的道理很简单:一个高意向客户如果被营销短信先轰炸走了,销售再跟就很难挽回;把他优先划给销售独占,整体损失最小。这张表一旦定下来,就成为所有人圈人时的默认排序,不再每次开会吵。
对齐的时候,建议把排序表连同每个包的圈选条件写成一页纸,让三个部门都签字认可。只要有一个部门事后觉得“这个人更该归我”,又偷偷在自己包里加回排除名单外的人,整套互斥就会被悄悄击穿。这页纸不只是技术配置,更是一份部门之间的口径约定:谁先、谁后、谁排除谁,白纸黑字写清楚,以后争议才有据可依。
四、排除条件在分群里怎么写
排序定好之后,落到分群配置里就是一条 not in 的规则。建第二个包时,条件不能只写“我要哪些人”,还要加一句“不要已经被第一个圈圈走的人”。通用做法是先看一下两个标签的交集有多大,再用差集/排除逻辑写上:运营包 = 目标人群排除销售包已圈走的人。这条必须显式写出来——不写,系统并不知道两个包之间有先后,它只会老老实实把同时满足条件的人都算进去。
一条完整的建包顺序
举个完整的配置顺序帮你理解:先建销售包,圈“咨询过价格的高意向客户”,优先级设为最高;再建运营包,圈“近 7 天活跃用户”,同时加上 not in 销售包;最后建市场包,圈“近 30 天访问官网”,再 not in 前面两个包。后建的包都在主动绕开先圈走的人,三个包从规则上就不可能再交叉。
这里同样要把边界说清楚:这套能力做的是“按同一时点把人群切成互斥的静态圈选”,它并不提供生命周期管理,也不会根据用户行为自动把人从 A 包挪到 B 包;这类人群自动流转能力目前未实现,需要你按周期重新跑一次分群来更新。
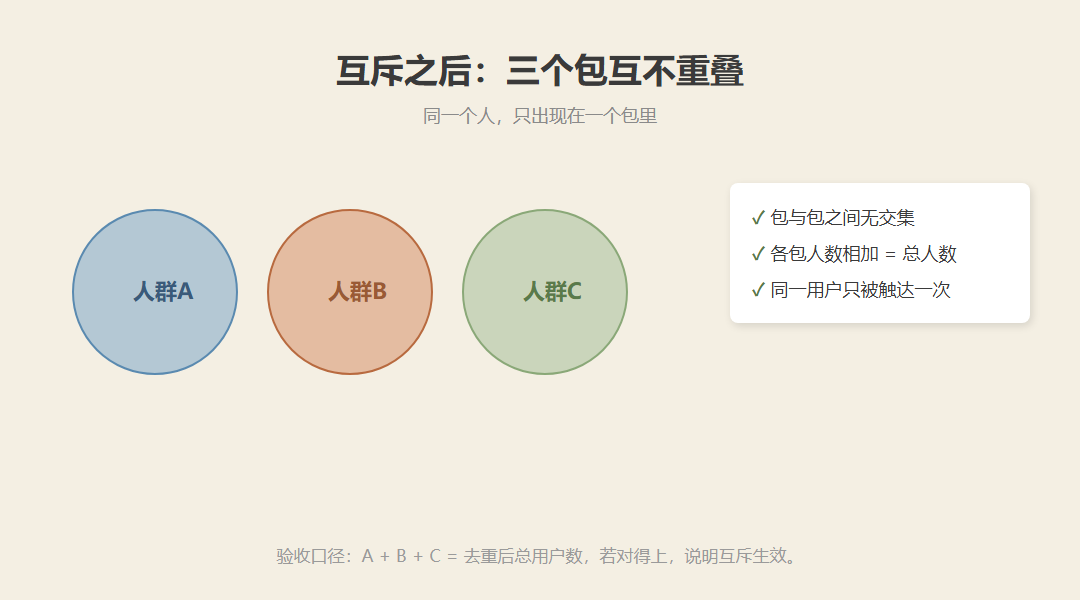 互斥生效后,三个包互不交集,人数相加等于总人数。
五、怎么验收互斥真的生效了
先算总账,再做抽查
规则配完,别急着发预算,先做两个数得上的核对。第一算总账:把三个包的人数加起来,应该等于去重后的总用户数;如果加起来明显大于总数,说明还有重叠没排干净。第二做抽查:从销售包里随机抽几十个人,逐个去看他们在不在运营包或市场包里,只要发现一个同时在两个包里,就是排除条件没写全。抽查不能省——总数对得上也可能藏着个别人的漏网之鱼,而触达冲突往往就出在这几个人身上。
还有一点容易被忘掉:互斥不是配一次就永远有效的。因为用户每天都在变,今天划在运营包的人,下个月可能已经成了付费客户,本该升级到销售包。所以建议按固定周期——比如每月一次——用同一天的快照重新跑一遍分群、重新套一遍优先级和排除条件。之所以要固定周期,是因为不定期重算的人群包,会随着用户行为慢慢“涨”回重叠,直到下次投诉出现才被发现。
三种圈人方式的差异
上面这套按优先级排序、后建包 not in 先建包、再按同一时点快照验收的做法,落到具体工具上通常有三条路:自己写代码跑人群去重、用 CRM 或网站自带的用户名单、用第三方人群分群平台。三条路在接入成本、去重口径、跨端统一、实时性和维护成本上的差别,大致如下表。
| 对比维度 | 自建埋点/代码方案 | 网站/App原生后台 | 第三方分群平台 |
|---|---|---|---|
| 接入成本 | 事件、订单自己进数仓,优先级排序和 not in 扣减逻辑手写 SQL,周期以周计 | 后台默认按标签圈人,零接入,但包与包之间不能互相扣减 | 嵌入 SDK 后用排除条件搭差集即可,能否多包链式互斥扣减以后台实际运算为准 |
| 去重口径 | 自己定义 user_id,同一人跨端是否只落一个群,全靠 SQL 里自己写扣减 | 通常只给单标签名单,不做包间去重,跨包重复全靠人工发现 | 人群包跨端去重,按同一用户标识归并,确保同一人只落进一个群、包与包互斥不重叠,是否内置以此为准 |
| 跨端统一 | 要自己做多端 ID 映射,映射错了同一个人会落进两个群 | 网站和 App 后台各自独立,人群包不通,互斥无从谈起 | 同一用户标识归并到同一份分群,多端行为进同一张去重表 |
| 实时性 | 取决于脚本调度,通常 T+1 | 原生后台多为按月或按周出名单 | 分群结果的刷新频率、调整排除条件后能否当天重算,需以产品后台实际能力为准 |
| 维护成本 | 分群规则、优先级表、人群包重算都要自己盯 | 后台自己会跑,包与包的扣减关系却改不动 | 发版与兼容由平台兜着,自己只维护分群规则与人群包的排除名单 |
常见追问
Q:为什么要建互斥人群?
A:如果一个用户同时属于多个群,你在做营销或分析时就不知道该看哪个群的数据。互斥保证每个用户只在一个群里,这样各群的数据加起来才等于总数,不会重复计算。
Q:标签重叠了怎么办?
A:先梳理标签体系,看哪些标签维度是真互斥的(比如新用户vs老用户),哪些是正交的(比如性别vs地区)。正交维度的标签本来就该重叠,不需要强行互斥。
Q:人群优先级怎么排?
A:按业务目标排。如果这个季度重点是留存老用户,那老用户群的优先级高于新用户群;如果重点是拉新,反过来。优先级决定了一个用户同时命中多个标签时归到哪个群。
为什么选用456数据
把互斥人群划清楚之后,选工具就看一件事:分群能不能互相扣减——先拉三个部门对齐优先级、再按 not in 条件依次建包、最后用重叠分析和抽查验收。这几步对应的通用方法是按差集/排除逻辑依次建包、用优先级排序定归属、再用重叠核对和抽查验收;平台是否已内置分群优先级配置、not in 排除运算与人群包重叠分析,具体功能需以产品后台或官方文档确认为准,不建议默认当作现成工作流。其中 App 与小程序的事件上报属于基础版起开放的能力,用户画像与分群属于专业版起开放;网站分析本身有免费版可用。如果你们已经在用自建数仓跑人群去重,对比上面这张表的五项差异再决定;原生后台的单维度名单够用的话,也没有必要额外换工具。
你们公司的几个人群包,是各部门各建各的,还是有一份全员认可的优先级表?有没有过同一个客户被三个部门轮番打电话、最后投诉的经历?欢迎在评论区聊聊,也说说你们最后是靠什么把重叠压下去的。