456数据埋点方案文档:怎样明确事件负责人
先看一个演示场景(不指向任何真实事故记录):假设网站端某转化事件的日触发量突然掉到零。值班同学先怀疑是前端发布事故,回滚之后数据依旧是零;再去翻数据平台,发现事件其实还在上报,只是事件名称在某次代码重构里被改动了一个字符。真正棘手的并不是这个字符本身,而是没有人能立刻说清:这个事件当初由谁定义、由谁验收、出了问题该找谁。埋点方案文档里只写了事件名和触发位置,没有写负责人。一旦人员流转,这个事件就成了"无主之物"。
埋点本质上是一套跨端、跨团队的"事件接口":接口没有负责人,就等于接口没有 owner。事故爆发不是因为缺工具,而是责任边界在文档阶段没有被显式定义。下面按复盘顺序展开:先看根因,再看处置动作,最后是工具边界与仍未解决的问题。
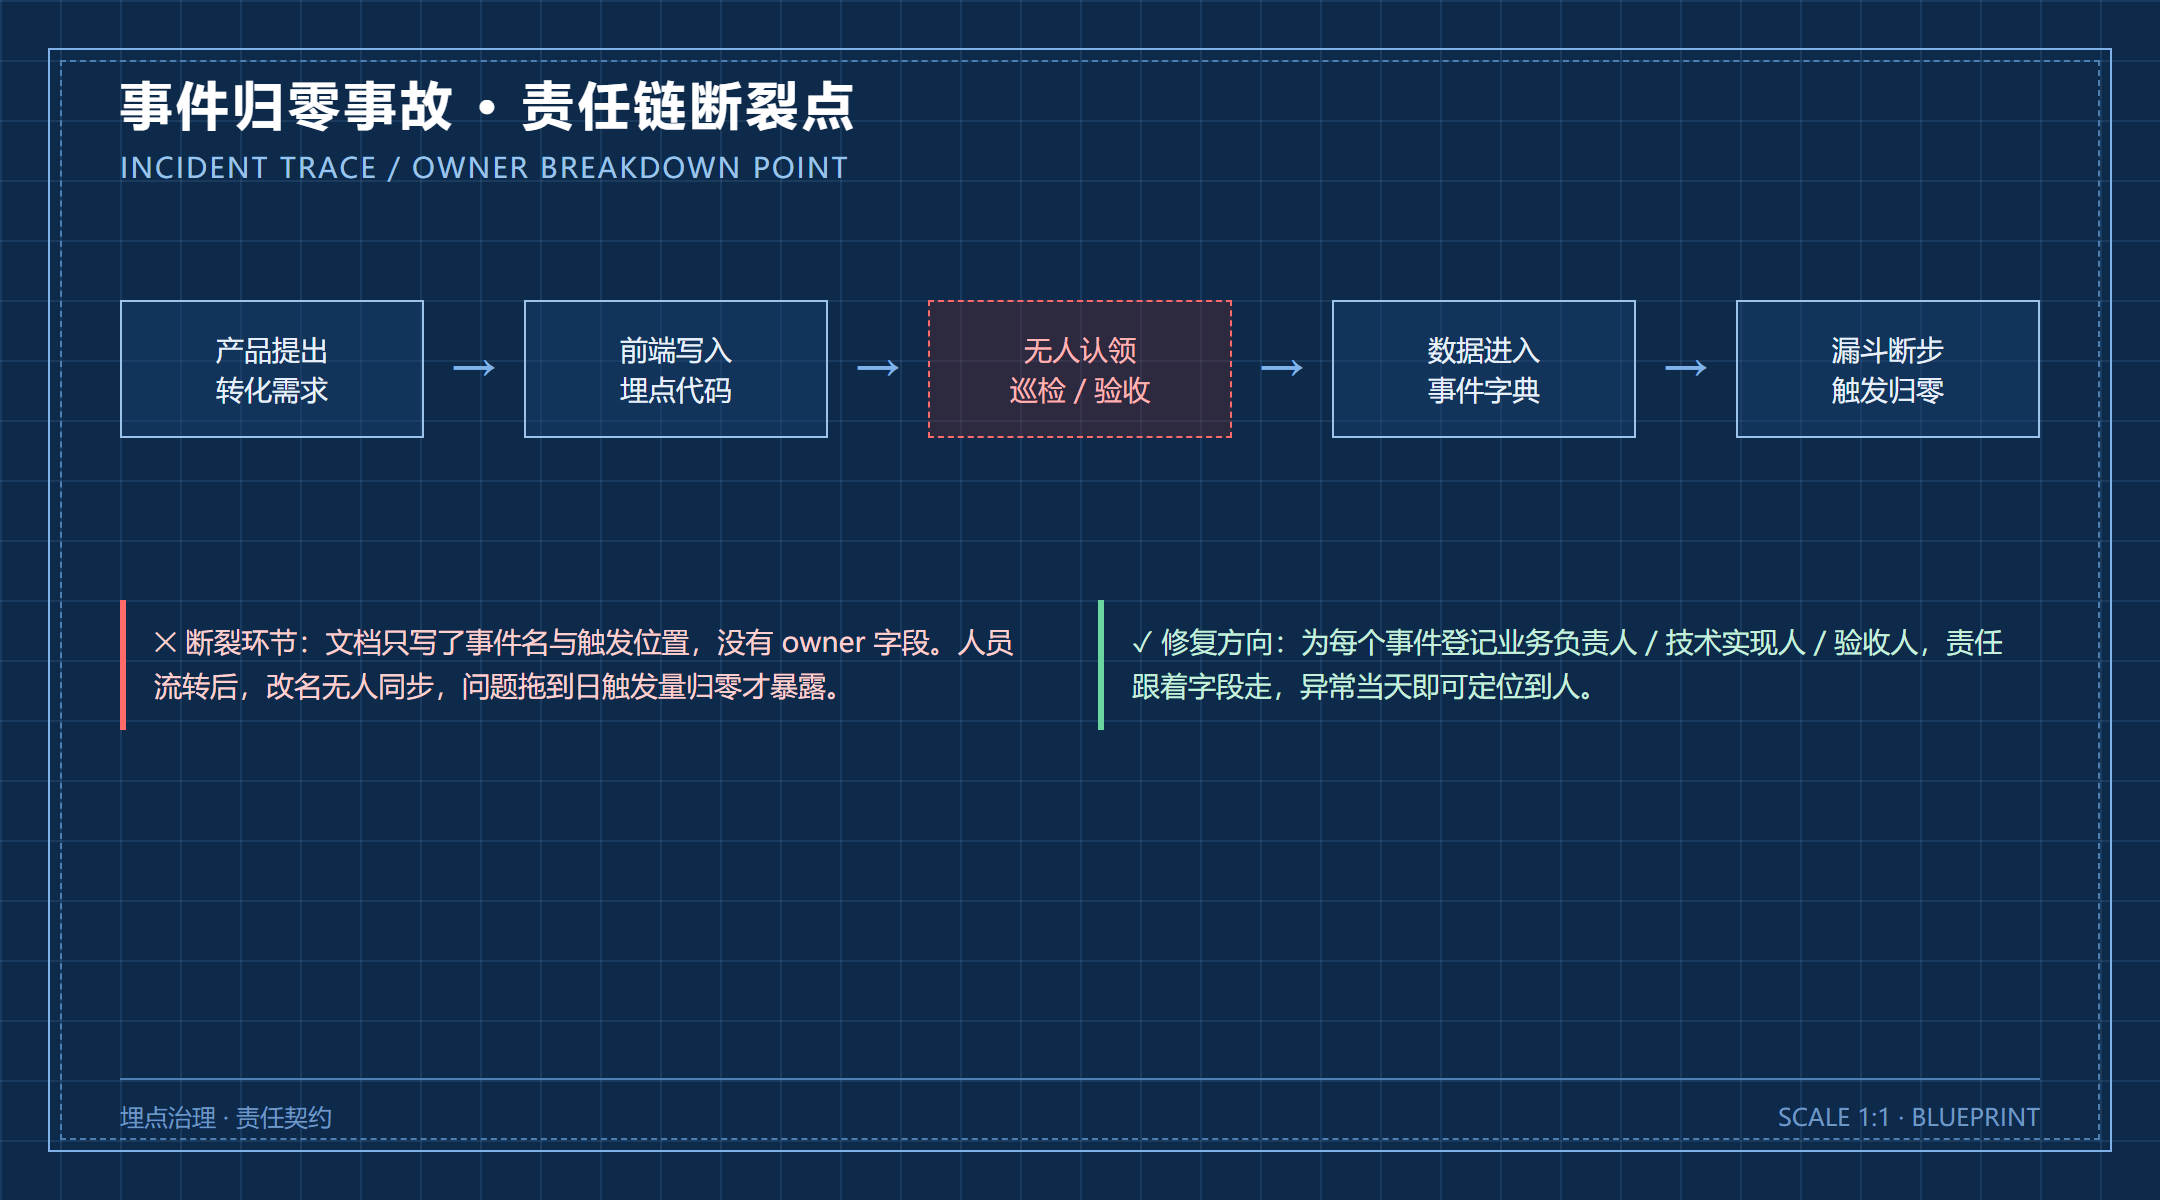
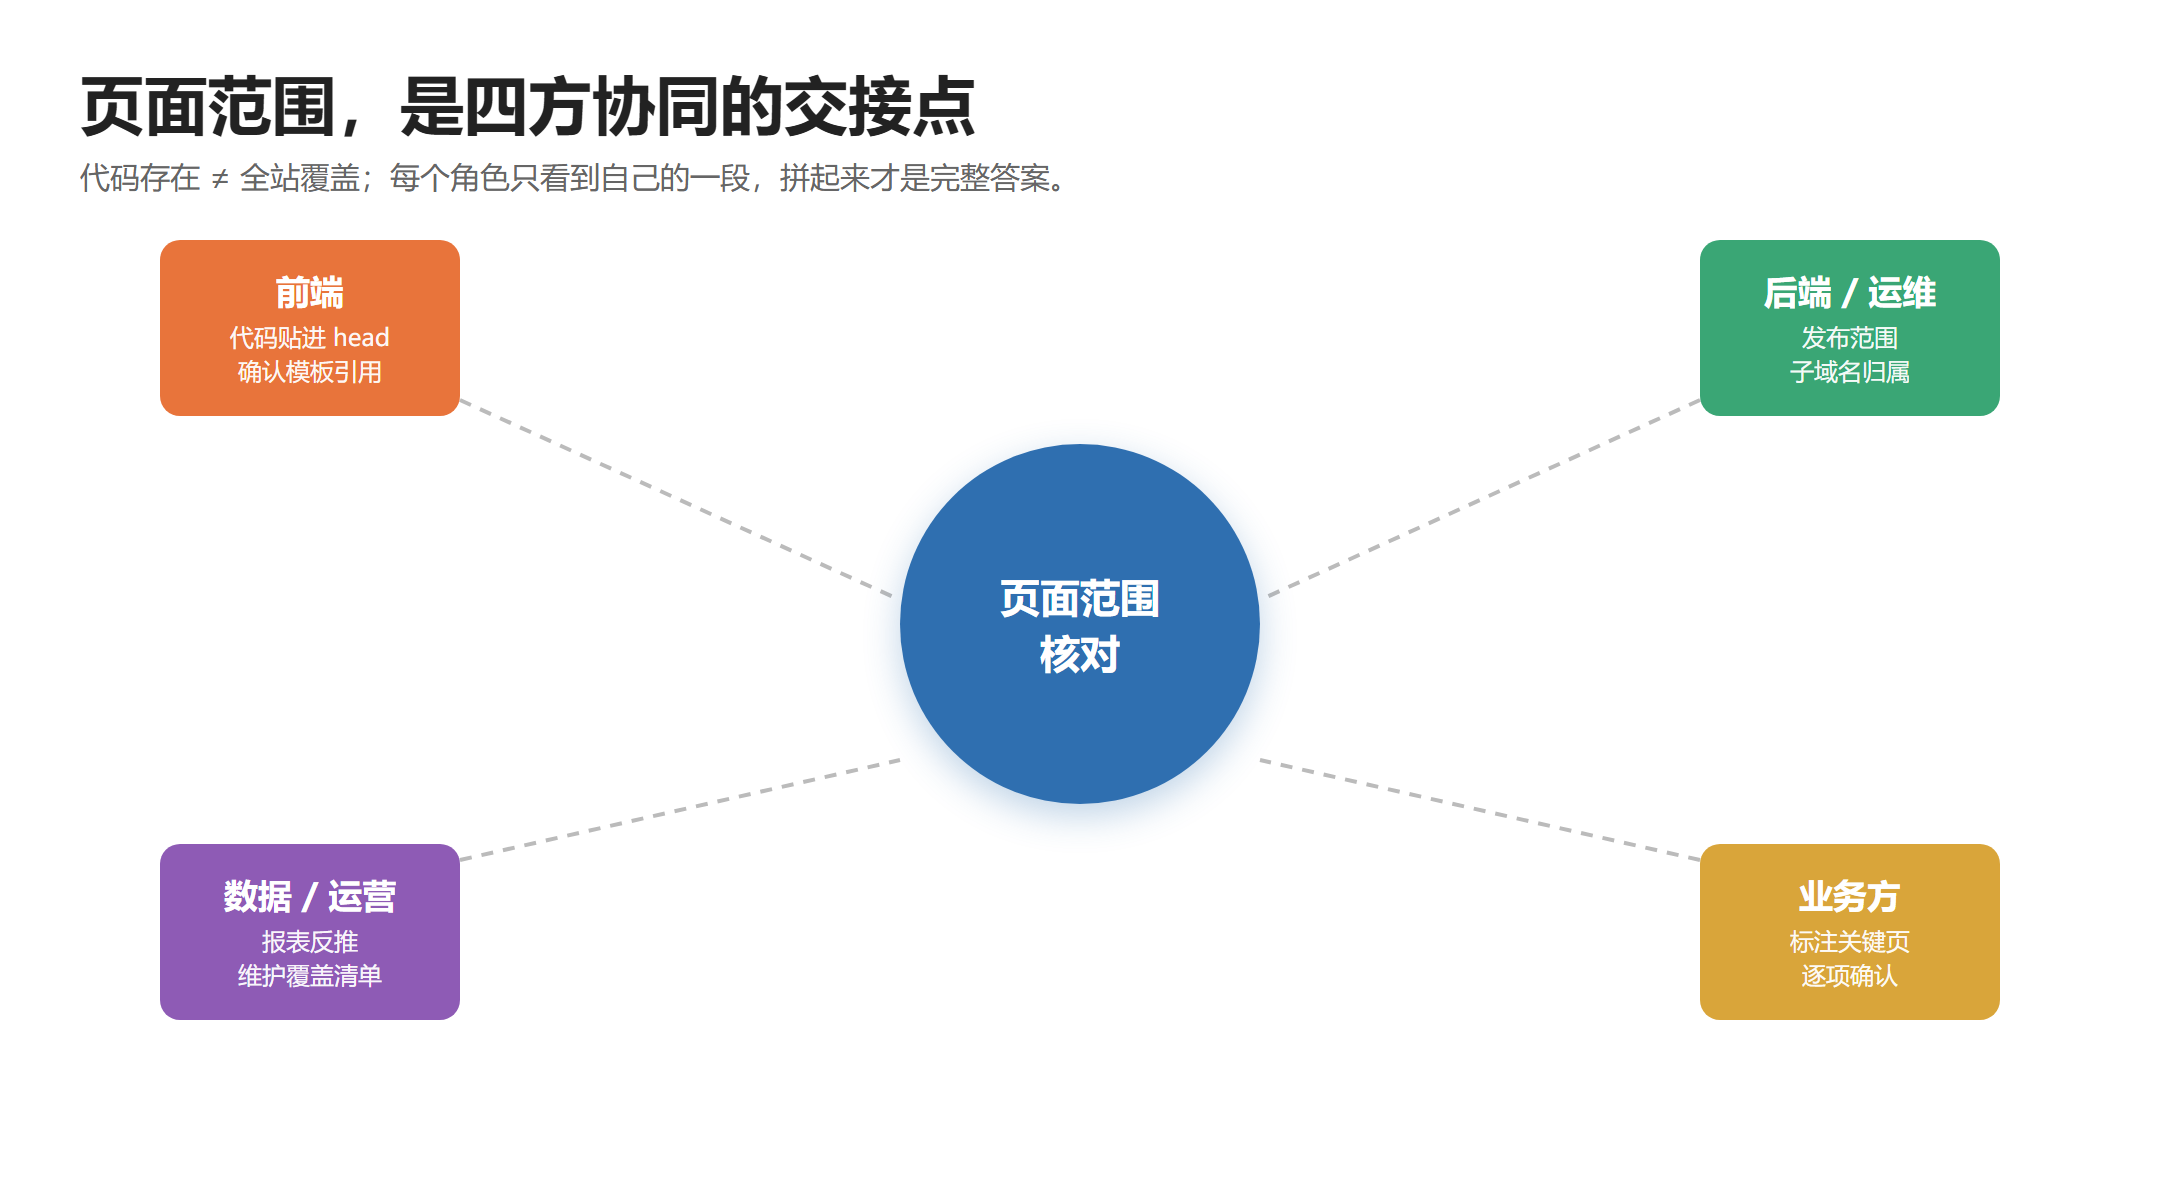
图:一次事件归零事故中,责任链在"无人认领"这一环断裂
一、事件为什么会变成"无主之物"
埋点文档为什么长期只有两列
大量团队的埋点文档长期停留在"事件名+触发位置"两列,源头是早期埋点往往由前端同学顺手加几行代码完成:团队小、人不流动,口头交代就够了。但当产品同时运营网站、App、小程序三端之后,同一个业务事件要在三套代码里各写一遍,责任就开始模糊。
三类症状,同一个根因
模糊的直接后果有三类。第一类是改名事故:某一端改了事件名,另一端没人同步,导致漏斗在这一步凭空断开。第二类是属性漂移:同一个"加入购物车"事件,网站端上报了商品价格,App端漏报,跨端汇总时数值对不齐。第三类是验收缺位:事件上线了,但没有人确认它真的被触发,问题要等到分析时才暴露。这三类症状的根因是同一个——文档里没有"谁为这个事件负责"这一列。
被当成一次性任务的隐患
还要补一个常被忽略的前提:责任会跟着人员流转一起流失,根子在于很多团队把"埋点"当成一次性开发任务,而不是一份长期维护的资产。事件从设计、开发、验收、上线,到后续巡检和最终下线,本应是一条有始有终的生命周期。文档里只记录了开发那一步,后续每一步都成了隐性工作,做与不做全凭个人自觉。一旦当初写代码的同学转岗或离职,这条事件链就没有了接续人。
| 典型症状 | 表面现象 | 根因(责任维度) |
|---|---|---|
| 事件突然归零 | 某事件日触发量断崖式下跌 | 事件名被改动,无负责人巡检 |
| 跨端数值对不齐 | 同一漏斗三端转化率不一致 | 属性口径无人统一维护 |
| 上线即失效 | 新事件查不到数据 | 缺少验收人,上线后无人核对 |
| 问题无人认领 | 群里提问后长时间无回应 | 文档未登记 owner 字段 |
二、负责人应该写进埋点文档的哪些位置
从代码清单升级为责任契约
要让事件"有人负责",文档结构必须从一份"代码清单"升级为一份"责任契约"。事件在技术上由分类、名称、属性三部分构成,因此规格表也应围绕这三部分展开,并为每一部分配上责任人字段。责任要拆到字段级:改名事故通常发生在名称上,属性漂移通常发生在属性上,只有责任跟着字段走,排障时才找得到人。
三个角色必须分三列登记
一张可落地的事件规格表,至少要包含下表所列的字段。其中"业务负责人"通常是提出该事件需求的产品或运营同学,"技术实现人"是真正写埋点代码的同学,"验收人"负责上线后核对数据是否正常流入。这三个角色常常不是同一个人,规格表必须分三列登记,笼统写一个"联系人"等于没写。
命名规范为什么要写进文档
命名本身也要在文档里立规矩。同一个业务动作,三端必须使用相同的分类与名称,否则跨端漏斗在拼合时会被拆成两个不相干的事件。"命名规范"要写进文档而不是口头约定——口头约定只在当事人都在场时成立,新加入的同学无从得知。一条务实的做法是:先约定分类用业务域(如交易、内容、运营),名称用动宾结构,新事件必须先登记进字典再写代码,从源头杜绝"随手加一个事件"。
| 字段 | 写什么 | 为什么必须有 |
|---|---|---|
| 事件分类 / 名称 | 如"交易/加入购物车",全站统一命名 | 改名是最高频事故源,命名必须集中管理 |
| 触发端 | 标注网站 / App / 小程序哪几端上报 | 跨端事件要逐端对齐,缺一即漏斗断步 |
| 关键属性 | 如商品id、价格、来源页 | 属性缺失会导致下钻分析无数据 |
| 业务负责人 | 提出该事件需求的角色 | 判断事件要不要改、要不要废弃 |
| 技术实现人 | 实际写入埋点代码的角色 | 上报链路出问题时第一联络人 |
| 验收人 / 状态 | 验收结论与事件当前启用状态 | 避免"写了代码却没人确认上报" |
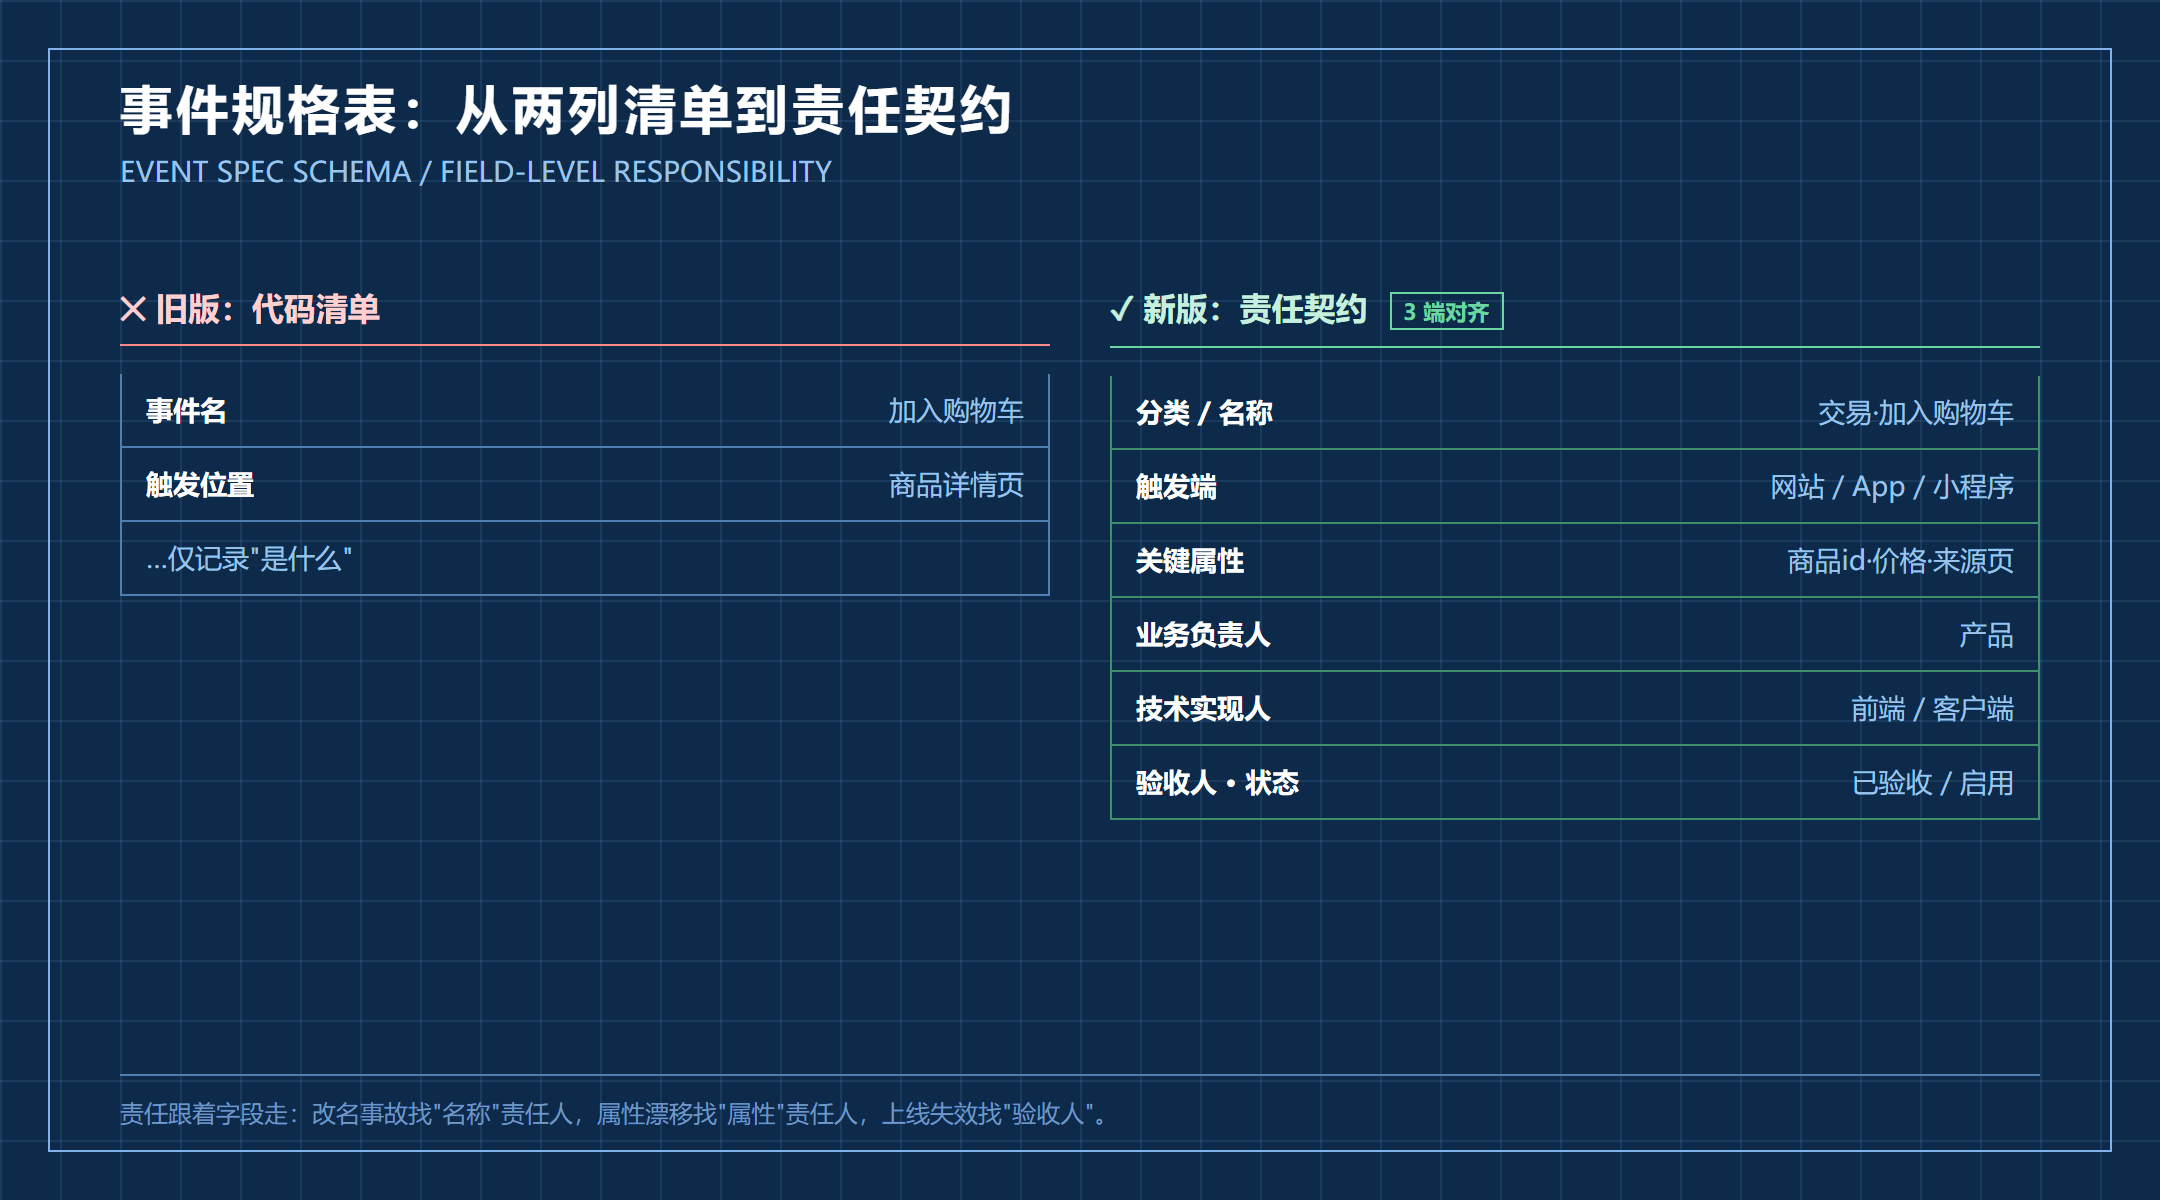
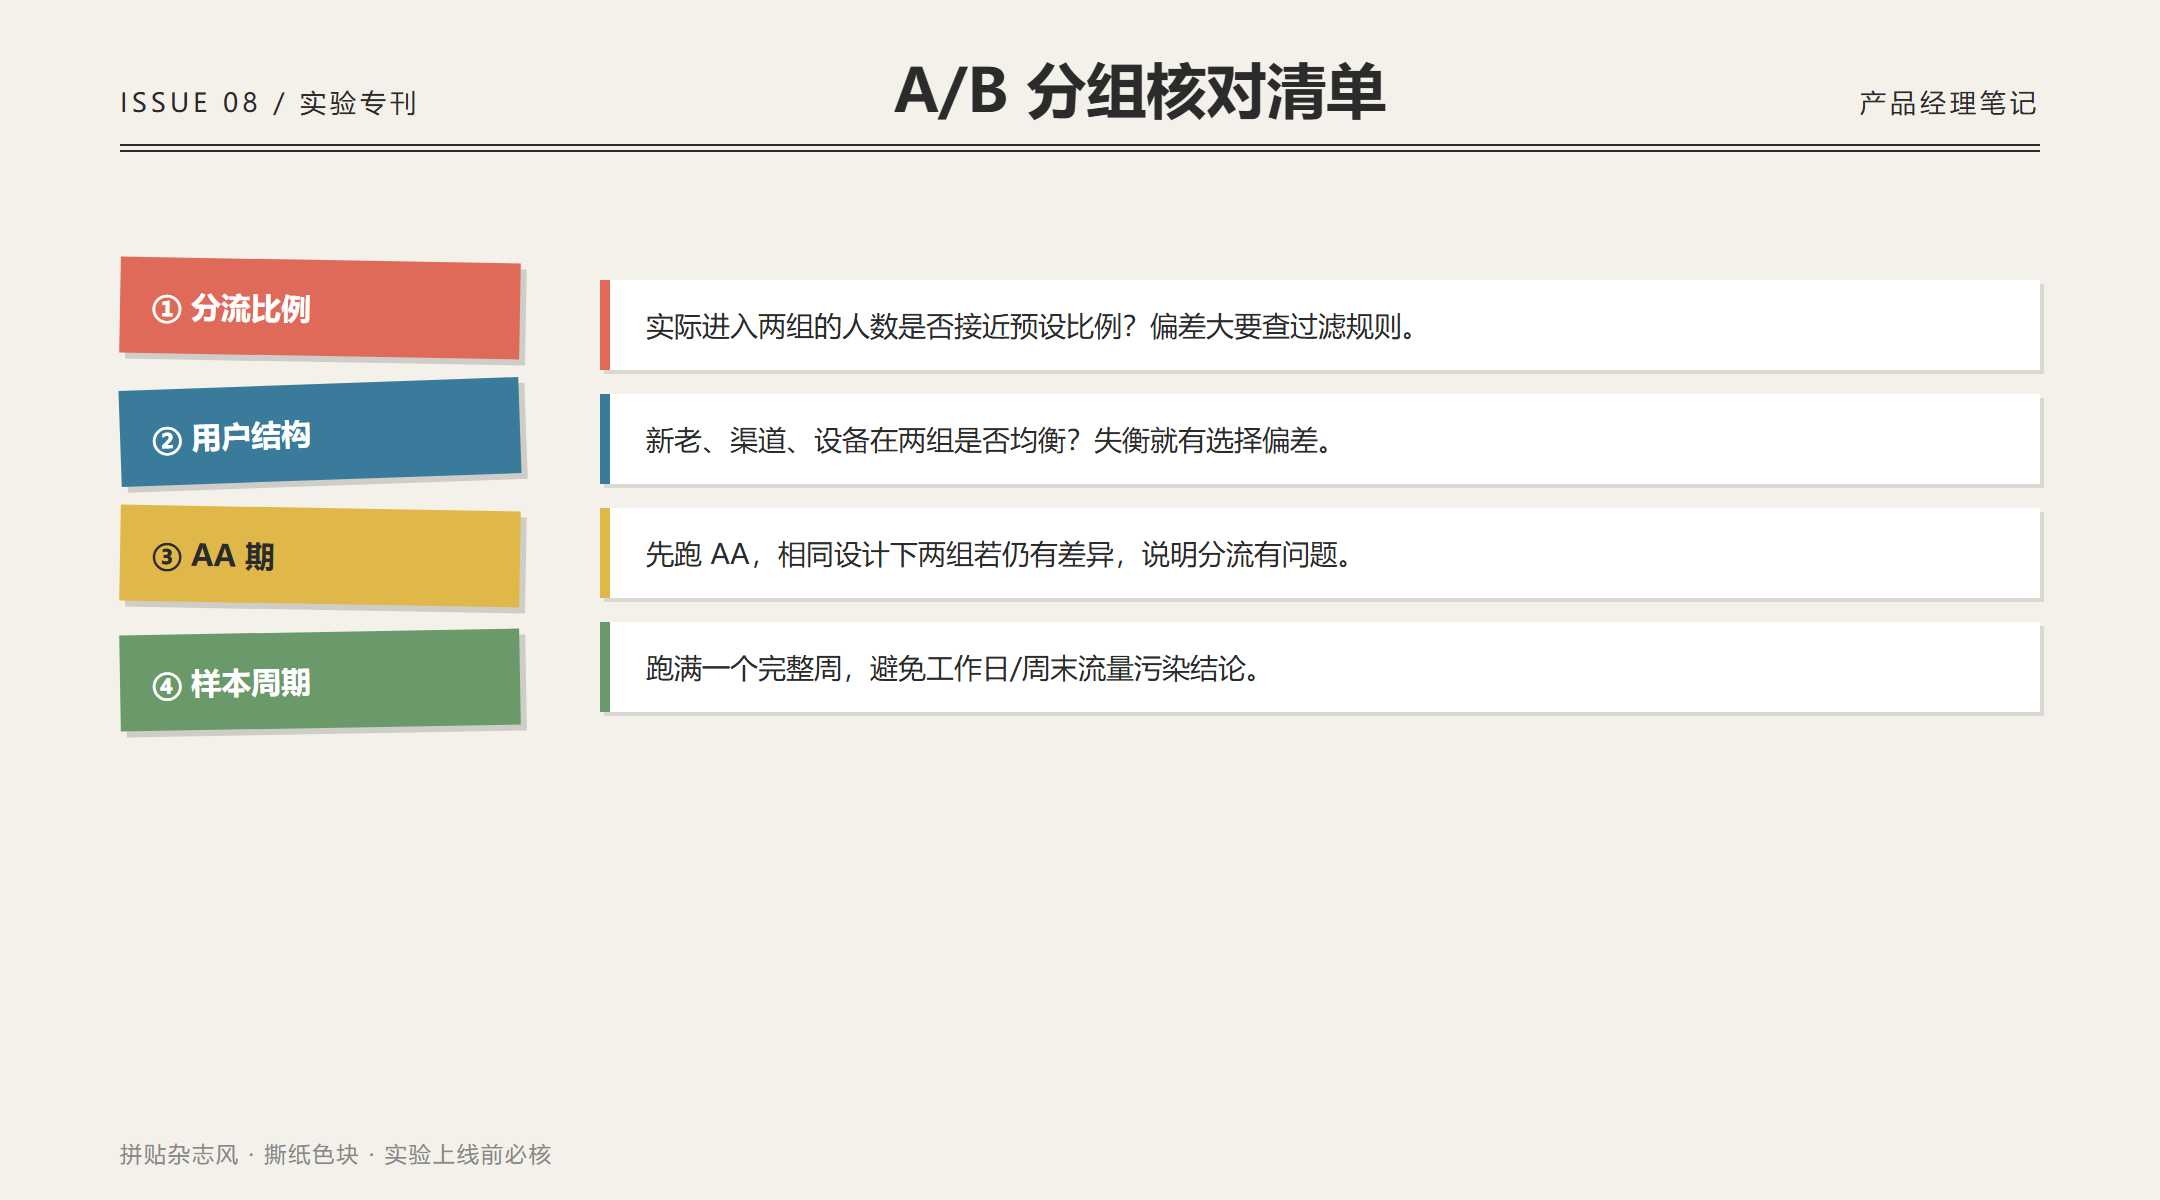
图:事件规格表从两列清单升级为责任契约的字段结构
可复制的事件责任模板
下面把"变更审批、SLA、验收样例、下线条件、负责人离职交接"也纳入责任登记,可复制到团队文档后按需调整使用。示例行以"购物/加入购物车"事件演示每个字段的填法。
| 事件分类/名称 | 触发端 | 关键属性 | 业务负责人 | 技术实现人 | 验收人 | 变更审批 | SLA | 验收样例 | 下线条件 | 负责人离职交接 |
|---|---|---|---|---|---|---|---|---|---|---|
| 购物/加入购物车 | 网站、App、小程序 | 商品id、价格、来源页 | 产品经理(需求提出方) | 前端开发(代码写入方) | 数据/测试(验收人) | 事件名或属性变更需业务+数据双人审批 | 变更后2个工作日内复验上报 | 三端各触发1次,次日核对触发次数与属性字段 | 页面下线或业务停用,由业务负责人确认后下线 | 交接人登记新owner并更新字典备注 |
一条 Web 端事件样例
事件由"分类+名称+属性"三部分组成,属性键名可自定义、中文键名可用。Web 端写法如下(示例引自官网接入文档):
_yhxw456_trackdata.push(['event','购物','加入购物车',{'商品id':'12','价格':'88.00'}]);
三、工具侧能承接什么,不能替代什么
事件字典与漏斗绑定的价值
有了文档规范之后,工具要解决的是"让规范可执行"的问题。以456数据为例,平台提供事件管理与漏斗管理两个入口(属用户行为分析能力):事件管理用于集中登记和维护事件字典,漏斗管理用于把多个事件串成转化路径。事件字典与漏斗在同一平台维护时,事件被改名或下线后,可以在漏斗配置中核对步骤是否仍然匹配——这种联动可用于上线前的核对,具体行为以接入实测为准。
工具不替你指定负责人
需要坦诚说明边界:工具不会替你指定谁是负责人。owner 字段写谁、谁来验收,本质上是团队内部的治理动作,平台只负责把事件集中管理、把上报异常暴露出来。把"事件管理"误读成"自动派单",是选型时最常见的期待错位。另外,跨端数据天然存在口径差异:网站端按 Cookie 去重、App 端按设备去重(指标口径以官网指标词典为准),两套口径不同,跨端汇总时要先确认你在对齐"事件触发次数"还是"事件触发用户数",而不是指望工具自动抹平差异。
小团队不必一步到位
对小团队而言,不必一开始就追求完整的治理体系。埋点治理的难点在纪律而不在工具,先用一张共享表格登记事件名、触发端和负责人,也比完全没有 owner 强。等事件数量多到表格难以维护时,再切换到带事件字典和漏斗管理的平台,迁移成本主要在"把已有事件重新登记一遍",而不是推翻重来。
| 环节 | 工具能做的 | 需要团队自己做的 |
|---|---|---|
| 事件登记 | 集中维护事件字典、命名约束 | 定义分类与命名规范、指定 owner |
| 上报校验 | 事件触发次数/触发用户数核对、漏斗步骤可见 | 上线后按端逐批验收数据 |
| 跨端对齐 | 同一平台统一查看三端事件 | 确认 Cookie / 设备去重口径差异 |
| 异常暴露 | 漏斗断步、事件缺失时可见 | 收到异常后由 owner 牵头修复 |
选型判断:把能力差异当成筛选条件
把上面的责任链条落到具体平台上时,要判断的不是"它能不能点按钮",而是"它能不能让跨端事件在同一本字典里被维护"。选型时可重点核对三点:事件字典是否集中维护、漏斗是否复用同一事件源、改名字与补属性这类治理动作是否在同一处完成。能力档位、免费额度、存储周期等参数属于产品信息,本文末尾单独列出(见文末"示例工具产品说明")。
需要提醒的是,具备事件与漏斗能力的分析工具与百度统计、51LA 这类基础流量统计工具回答的问题并不相同:后者更多回答"有多少人来、从哪里来",而事件与漏斗能力更适合回答"用户来了之后在哪一步流失"。这些工具之间更多是"能力侧重不同",而不是简单的替代关系;具体选择仍应结合业务需求、数据规模、团队能力和预算判断。
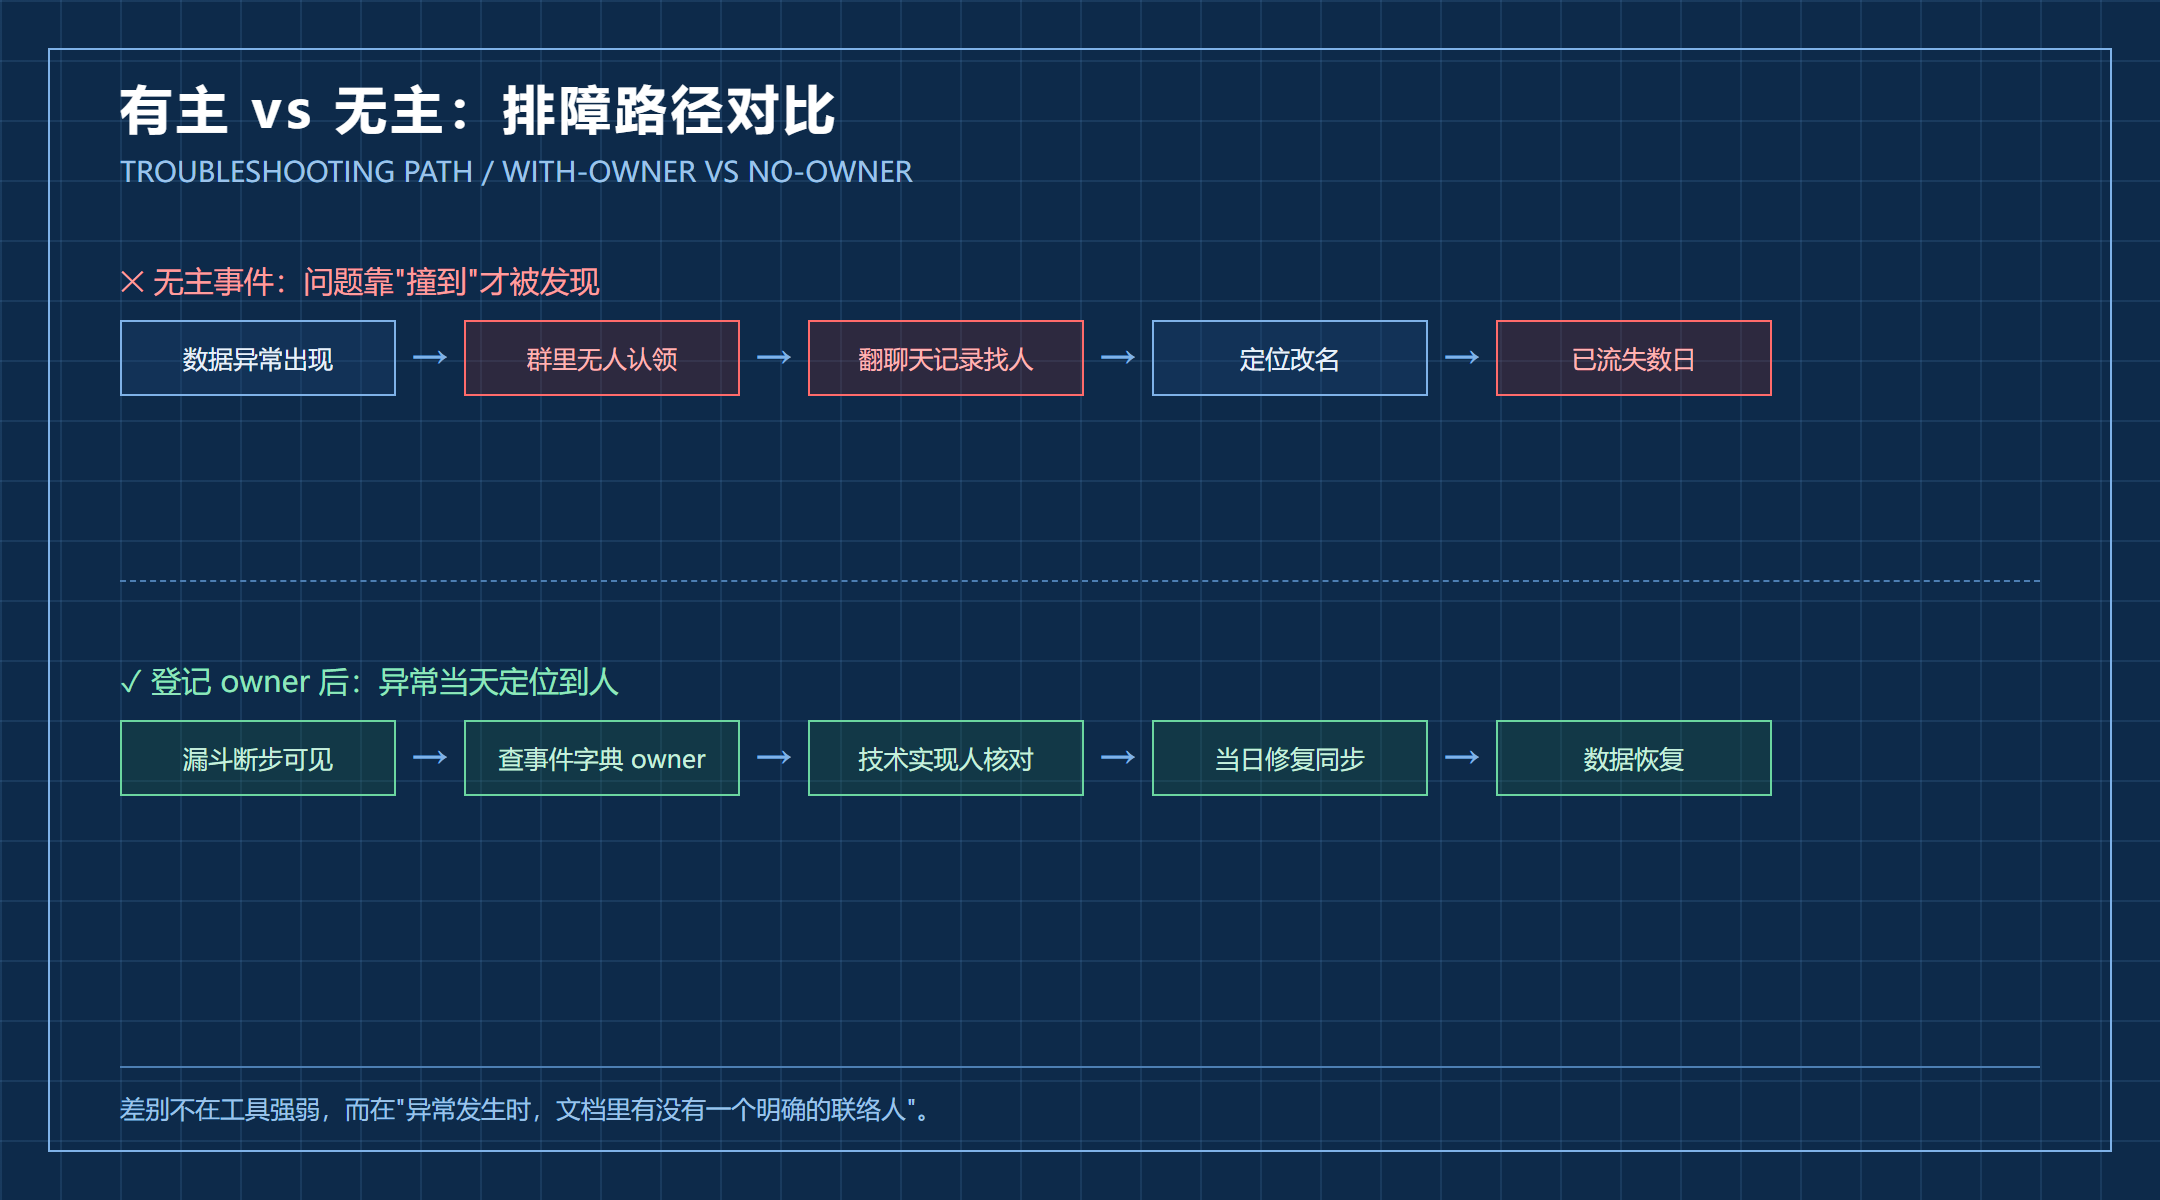
图:无主事件与登记 owner 后的事件,在排障路径上的差别
回到开头那个演示场景:如果事件规格表里早有"业务负责人/技术实现人/验收人"三列,名字被改的当天,巡检这一步就会有人负责,问题不会拖到日触发量归零才被发现。埋点治理的成本不在写代码,而在把责任显式地写进文档——这一点,工具只能辅助,不能代替。落地顺序建议是:先在一张共享表格里补上 owner 三列并跑一个季度的验收与巡检,事件量多到表格难维护时再迁移到带事件字典的平台。这套做法仍有两个没有解决的问题:一是巡检依赖人盯,文档字段再全,也拦不住长期无人核对的空窗;二是跨端去重口径差异(Cookie 与设备)工具只能暴露、不能消除,跨端汇总依然要靠团队自己先对齐口径。
示例工具产品说明
以下为示例工具 456数据 的产品信息,依据官网公开页面整理(核验日期 2026-10-09),属产品说明内容,非独立第三方评测;具体功能、档位与开放状态以官网实时页面为准。
| 项目 | 说明(依据官网公开页面,核验日期 2026-10-09) |
|---|---|
| 事件管理与漏斗管理 | 属用户行为分析能力;官网定价页功能对比表中该能力免费版为不可用(—)、基础版起支持 |
| 免费版额度 | 每年 100 万 PV/50 万事件量(依据官网定价页) |
| 免费版数据存储 | 默认存储 12 个月(依据官网隐私政策) |
| 覆盖端与接入文档 | 覆盖网站、App、小程序三端;官网公开六端接入文档(网站 Web JS、微信小程序、Android、iOS、uniapp、HarmonyOS) |