网站流量指标三层看板:PV、UV、跳出率的阅读顺序
先看一个演示场景(不代表任何真实会议记录):月初的复盘会上,负责投放的同事指着大屏说,这个月 PV 涨了不少,势头很好;负责内容的同事却摇着头,说跳出率偏高,留不住人。两个人盯着同一块看板,得出了相反的结论。问题不在谁对谁错,而在于十几个指标被平铺在同一屏上:PV、UV、IP 数、新访客率、跳出率、平均浏览时长、平均浏览页数,谁也说不清开会时到底该先汇报哪一个——指标一多,没有层级,讨论就会退化成各说各话。
多数流量统计工具默认把所有指标一股脑摆出来,却不说明它们之间的从属关系。一个成熟的看板不应该是指标的堆砌,而应该是一棵有顺序的树:先看哪几个判断"健不健康",再看哪几个判断"为什么",最后才下钻到明细。本文就按这个思路,把网站流量指标分三层安排一次。
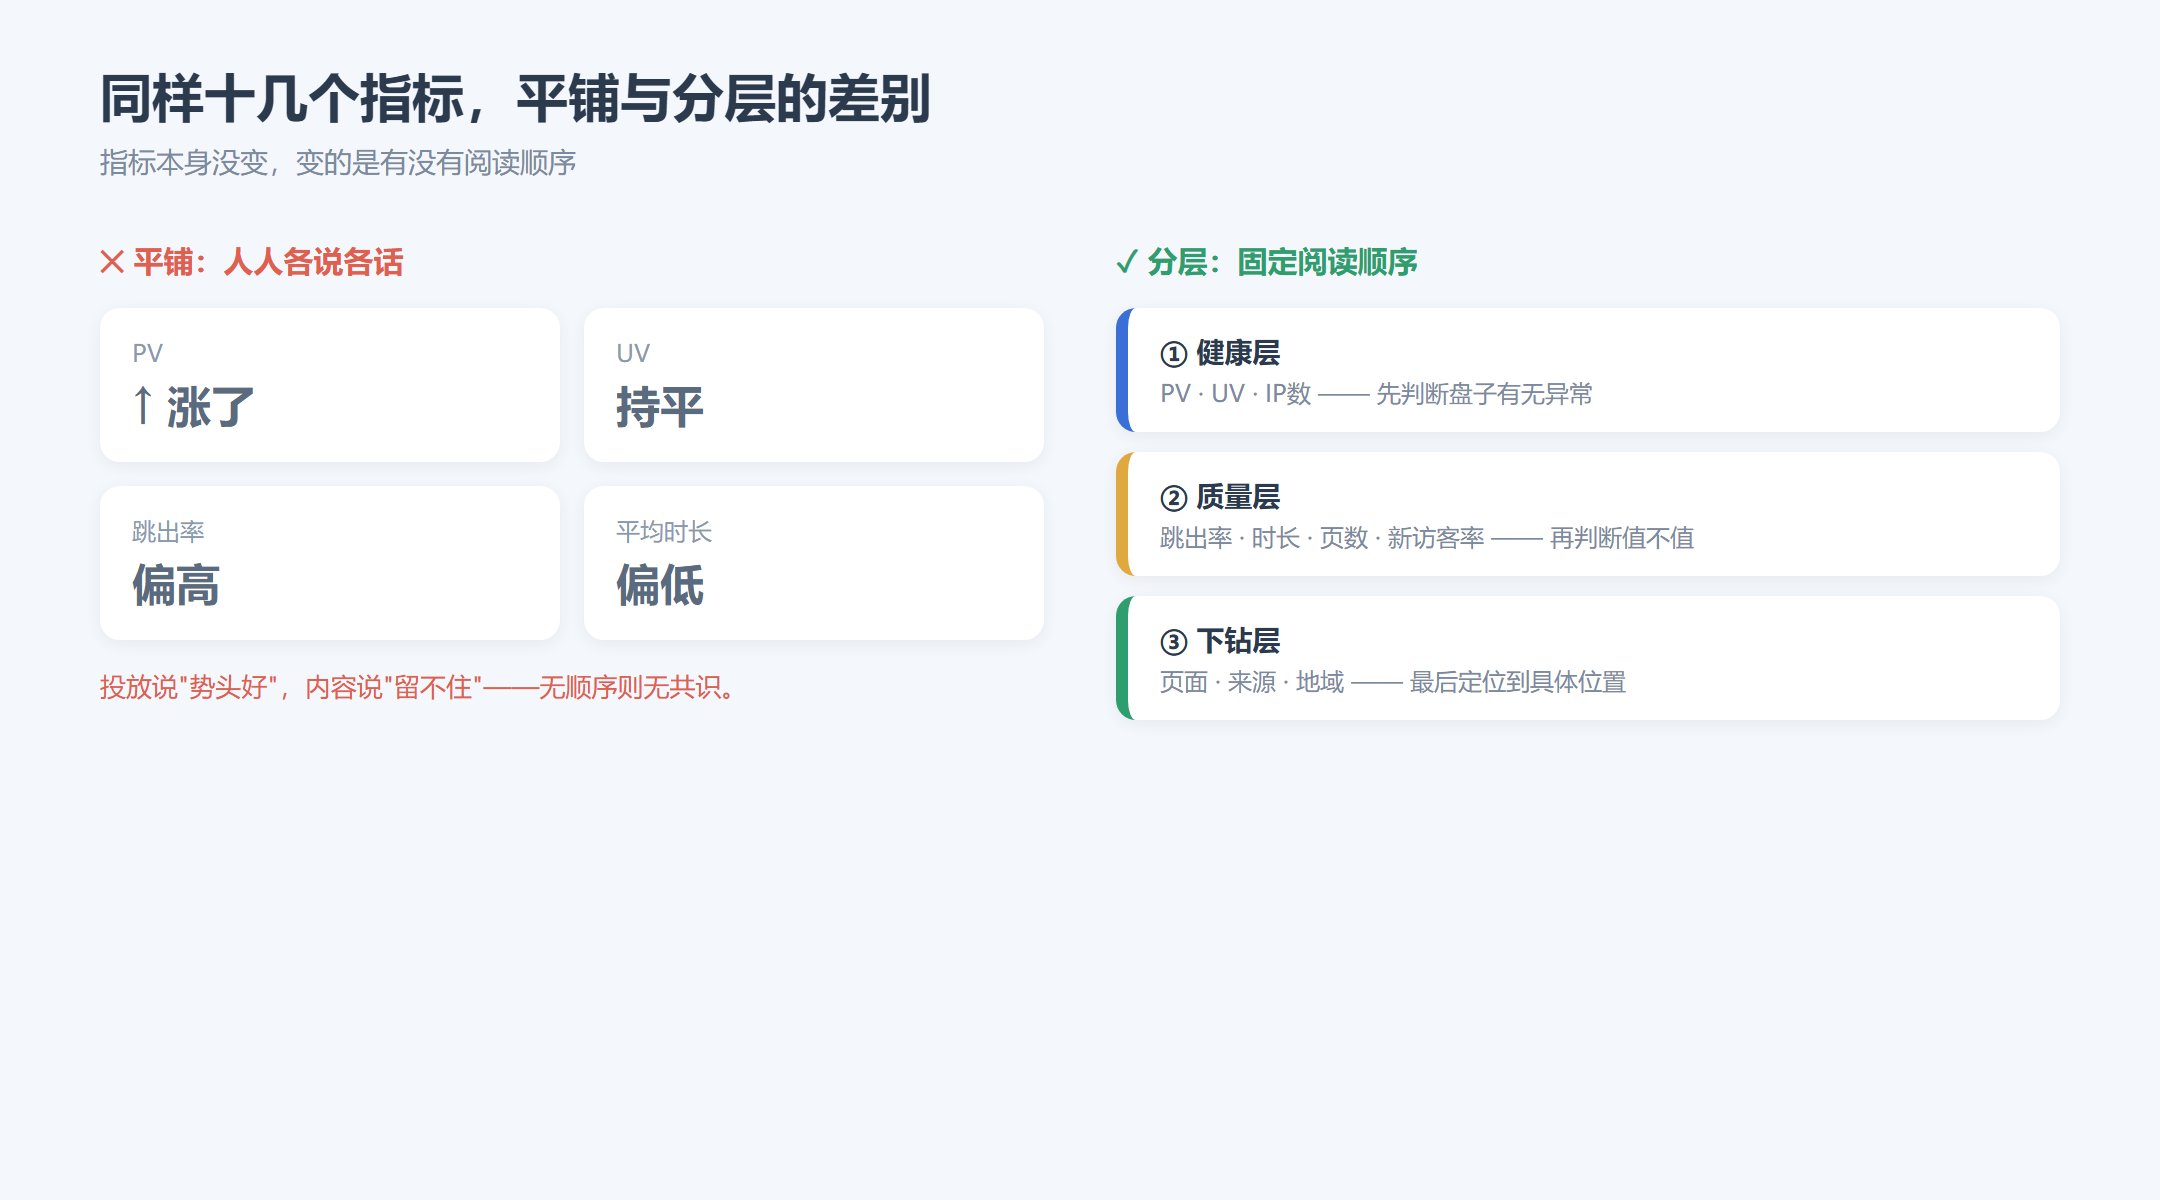
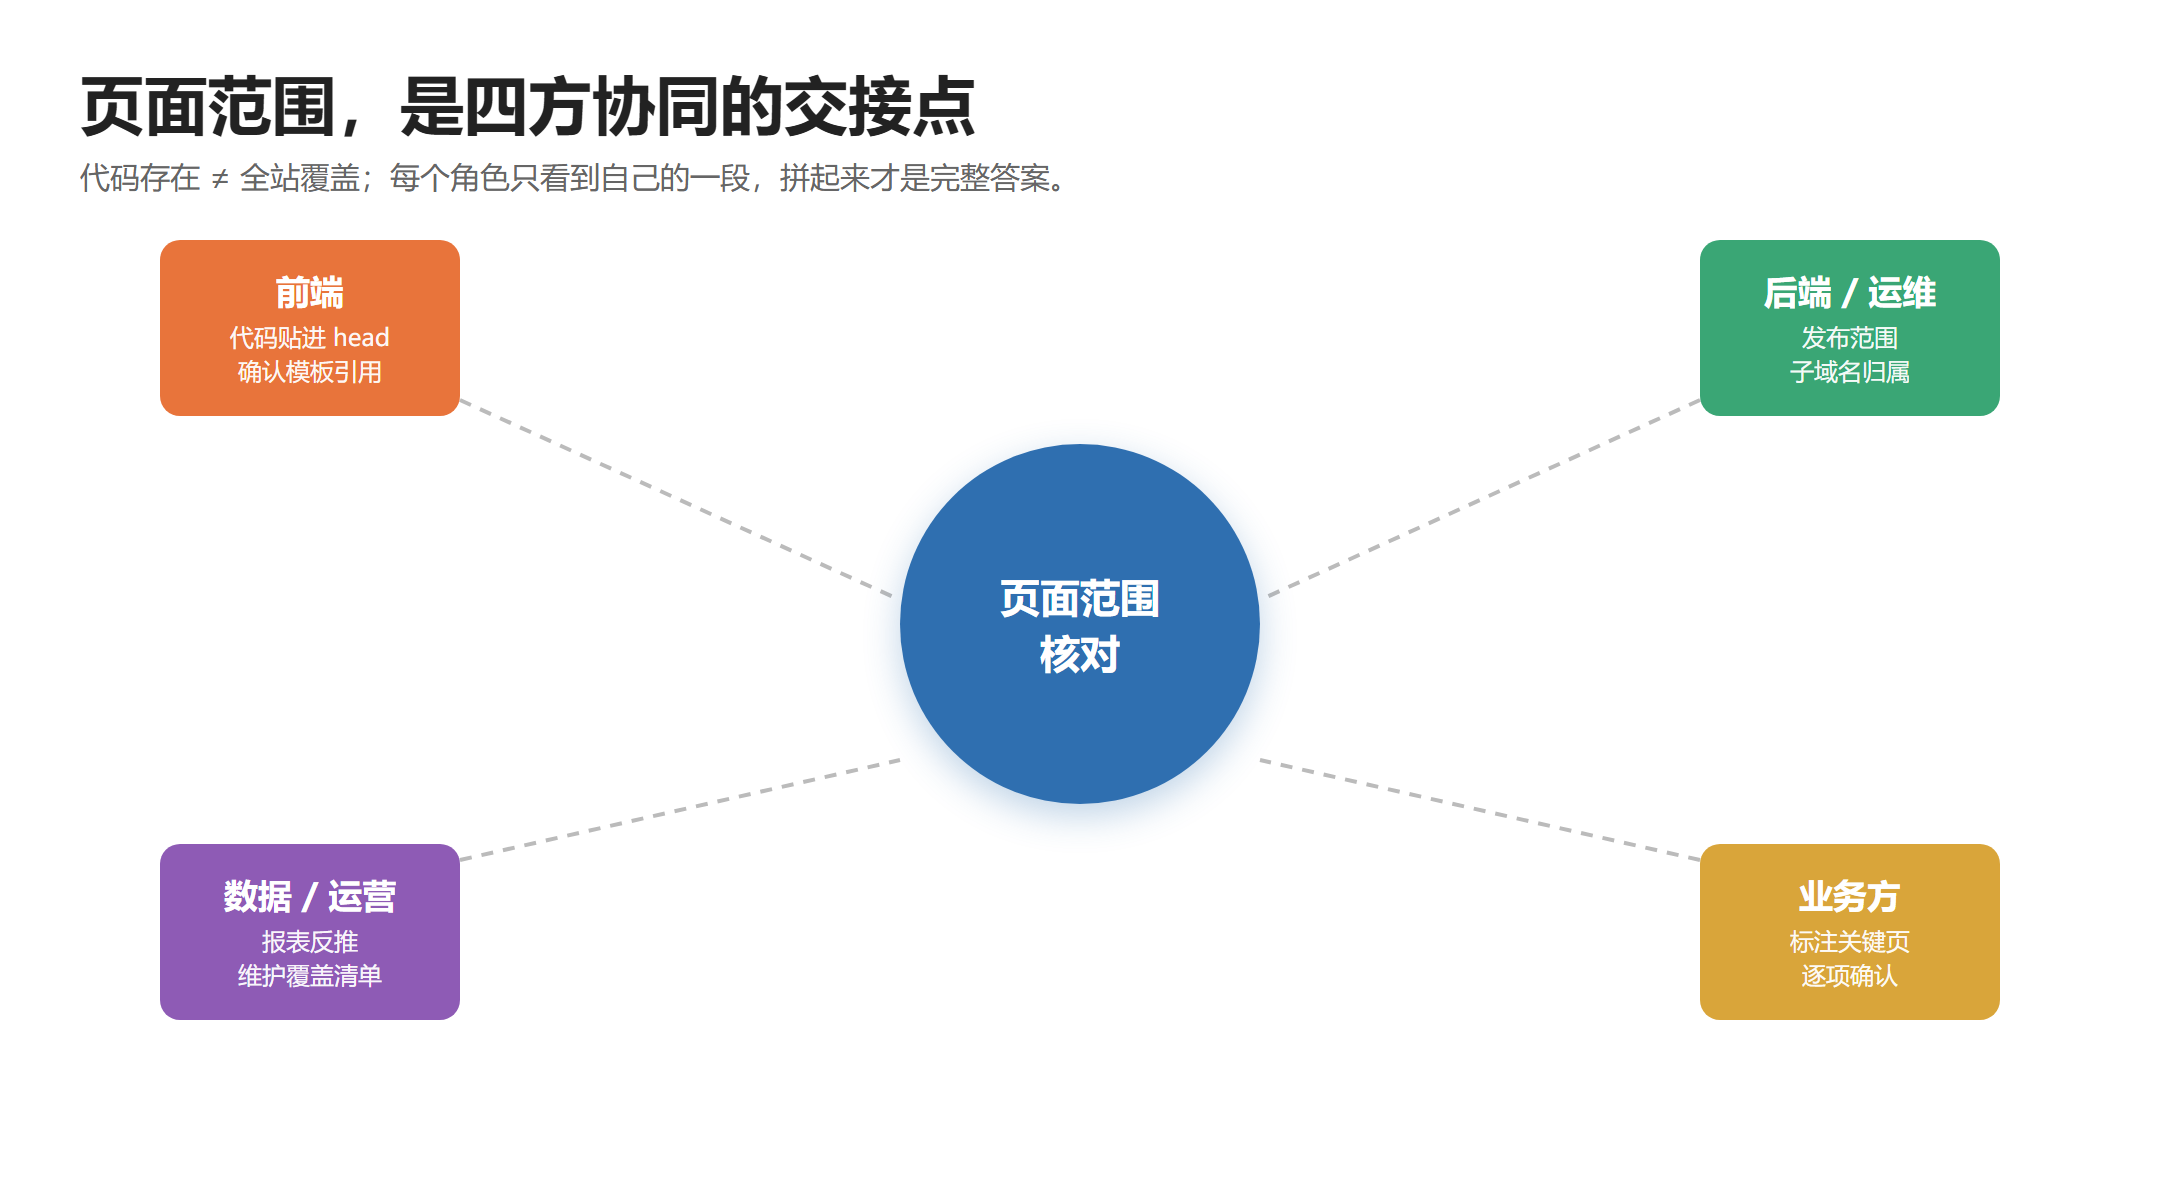
图:指标平铺时人人各说各话,分层后才有固定的阅读顺序
一、第一层:先看"健康指标",判断盘子有没有异常
哪三个指标构成基本盘
第一层只回答一个问题:整体流量盘子健不健康。这一层应该放最稳定、最不需要解释就能看懂的总量指标。按官网指标口径,访客数 UV 是一天之内的独立访客数(以 Cookie 为依据,同一访客多次访问只算一个),浏览量 PV 是用户每打开一个页面就记录一次,IP 数是一天之内的独立访问 IP 数。这三个指标共同构成"有多少人来、来了多少次"的基本盘。
为什么看数要从这一层开始
它们放在第一层,因为波动时通常意味着外部变化(投放、节假日、被搜索引擎收录或降权),而不是页面本身的问题。健康指标一旦出现断崖式涨跌,后面所有质量指标的解读都会失真,看数必须从这一层开始,而不是一上来就钻进某个具体页面。
二、第二层:再看"质量指标",判断人来得值不值
这一层在衡量什么
确认盘子没异常之后,才进入第二层:流量质量。这一层回答的是"来的人有没有真的留下来"。按官网指标口径,跳出率是只浏览了一个页面便离开网站的访客占总访客的百分比,跳出率越高代表页面留存、吸引力越差(跳出率口径);平均浏览时长是从打开首个页面到关闭页面的平均时间差(平均浏览时长口径);平均浏览页数是单次访问平均打开的页面数量;新访客率则是当日新访客数除以当日总独立访客数,用于衡量拉新效果(新访客率口径)。需要补充一个边界:跳出率高并不必然等于页面差——是否算异常,应在同类页面、相同目标下进一步核查,再结合 PV 规模与页面类型综合判断。
| 层级 | 回答的问题 | 典型指标 | 口径要点 |
|---|---|---|---|
| 第一层 健康 | 盘子有没有异常 | PV / UV / IP数 | UV 按 Cookie 去重,PV 按打开次数累计 |
| 第二层 质量 | 人来得值不值 | 跳出率 / 平均时长 / 平均页数 / 新访客率 | 跳出率只统计单页离开;新访客率看拉新 |
| 第三层 下钻 | 问题出在哪 | 受访页面 / 来源渠道 / 地域 / 终端 | 用于定位具体页面与渠道,不用于下结论 |
为什么必须结合健康指标一起看
质量指标放在第二层而不是第一层,因为它们必须结合健康指标一起看才有意义。举例来说,跳出率高本身不一定是坏事——如果你的落地页是单一目标页(如下载页),用户看完即走是合理行为。脱离 PV 规模单独谈跳出率很容易误判,这一层的正确用法是"发现异常后再下钻",而不是每天盯着它做情绪判断。
新访客率为什么要单独拎出来
新访客率是这一层里特别值得单独拎出来的一个指标。它等于当日新访客数除以当日总独立访客数,衡量的是拉新能力而不是留存能力。新访客率持续走低,往往意味着拉新渠道在枯竭;但如果同时 PV 并没跌,说明是老用户在反复访问。把新访客率和回访情况放在一起看,才能区分"是新人不来了"还是"老人不来了"——这两种情况对应的优化动作完全不同。
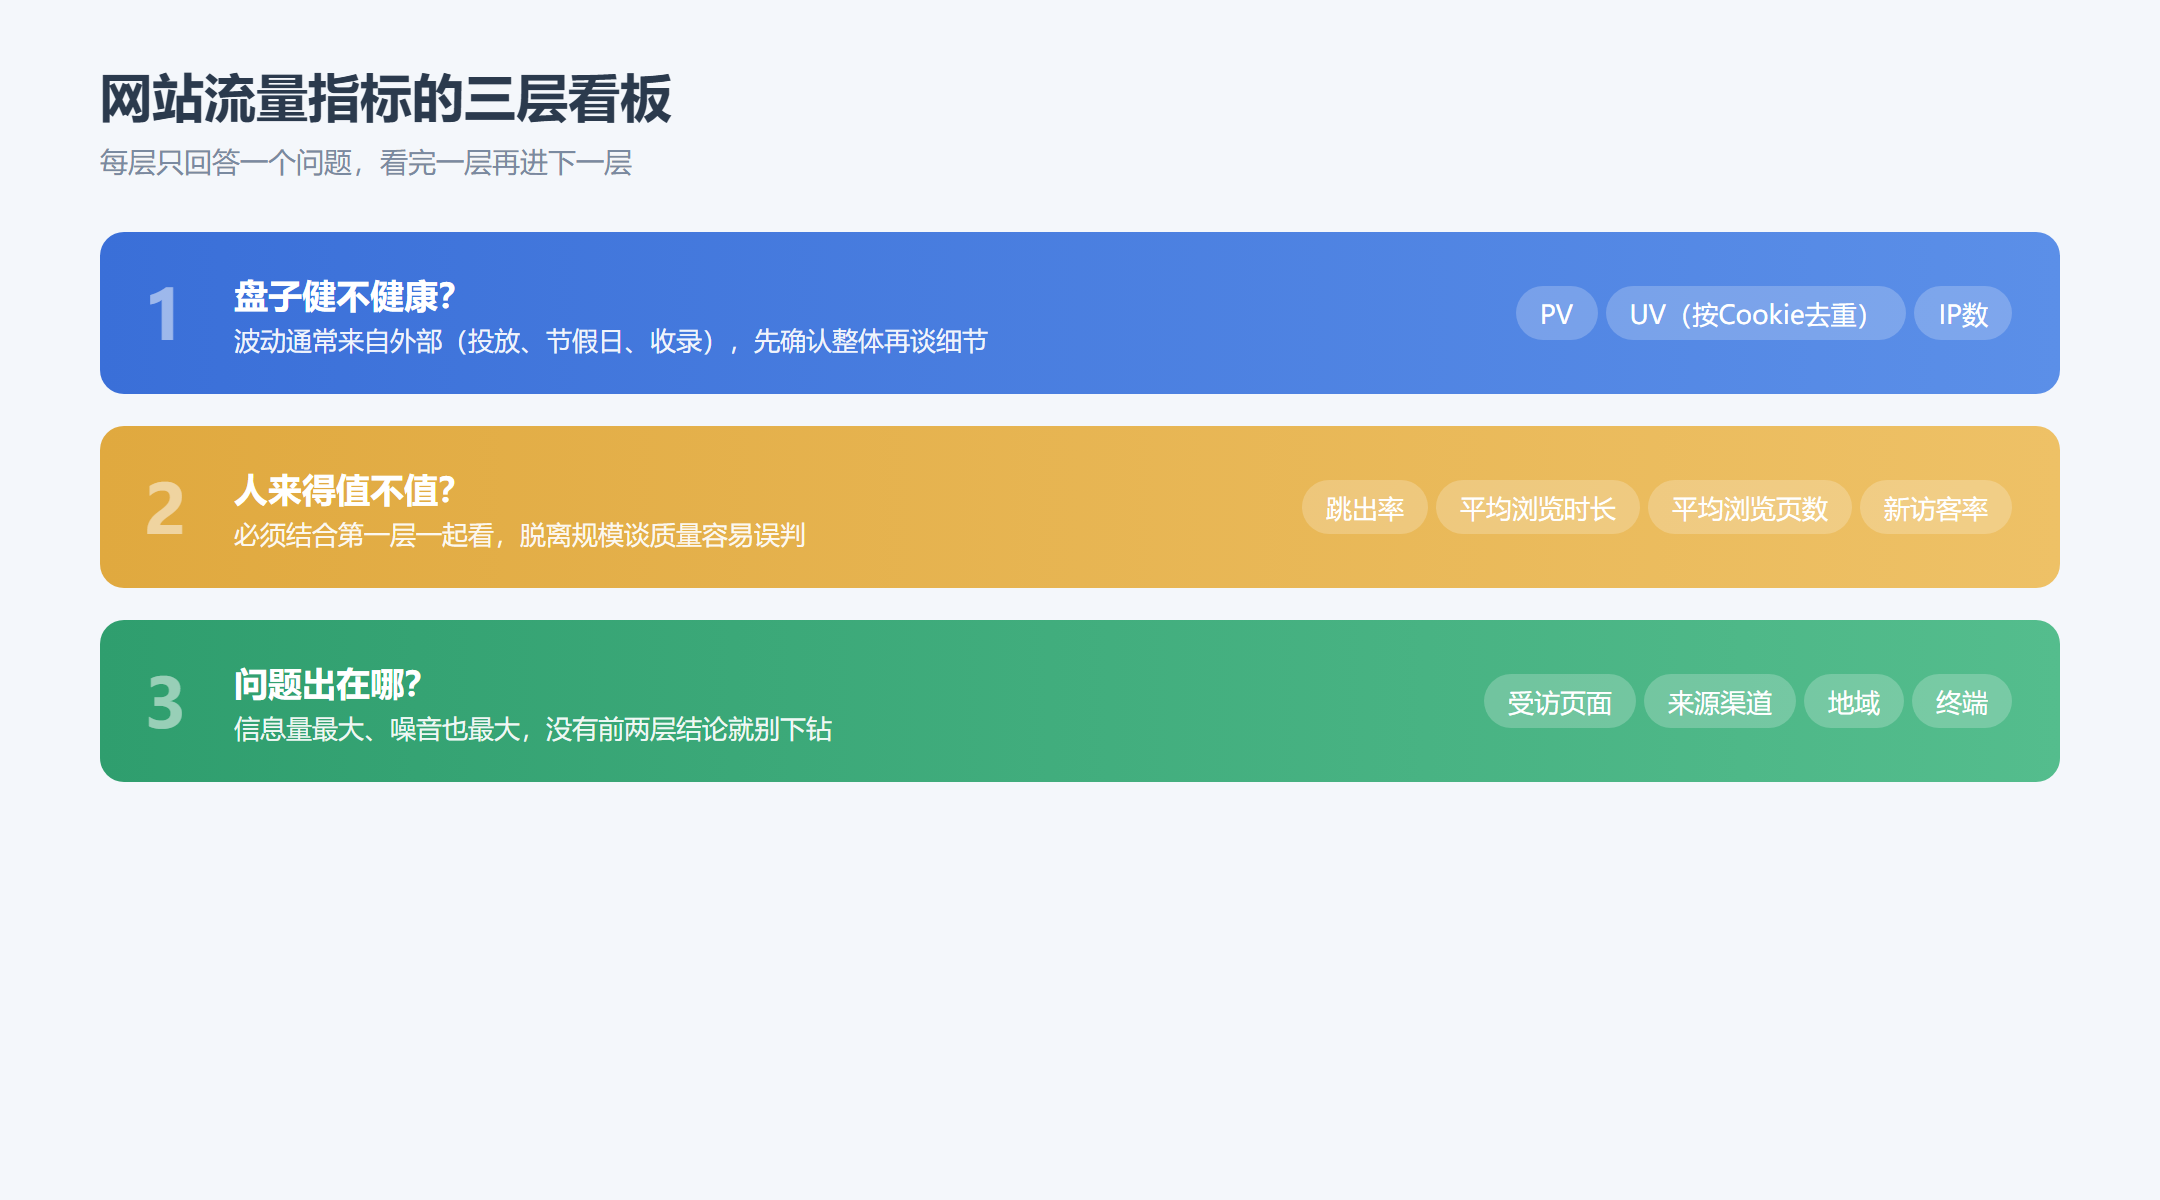
图:从健康层到质量层再到下钻层的指标阅读顺序
三、第三层:最后下钻"明细指标",定位具体位置
明细指标为什么放在最后
前两层告诉你"好不好",第三层才回答"哪里不好"。这一层包括受访页面分析(页面访问用户数按独立用户去重、页面访问次数按打开次数累计)、来源渠道与来源关键词、地域与终端设备等。明细指标信息量最大但噪音也最大,没有前两层的结论做引导,下钻很容易变成漫无目的的翻页,所以放在最后。
跳过前两层直接开会的错误
一个常见的错误是跳过前两层,直接从某个页面的明细数据开始开会。这样做缺乏"整体是否正常"的参照:你看到某页跳出率高,却无法判断它是全网站的普遍现象,还是只有这一页的问题。正确的顺序始终是:先健康、再质量、后明细,一层一层往下收。
三层对应的三个看数频率
落地到实际节奏上,这三层看数的频率也不一样。健康层适合每天扫一眼,它反映外部波动;质量层适合按周复盘,单日的跳出率和时长抖动往往不具结论性;明细层只在前两层发现异常时才临时打开。频率不分开,每天都下钻明细,分析会被噪音填满,反而看不出真正的趋势。把三层和三个时间尺度对应起来,看板才真正变成"工具"而不是"数据仓库"。
一组算例:用三层顺序走一遍(示例数据)
假设某内容站一周数据为 PV=10,000、UV=4,000、跳出率=68%。按三层顺序读,读数方式如下表:
| 步骤 | 看什么 | 示例数据 | 怎么判断 |
|---|---|---|---|
| ① 健康层 | PV 与 UV 是否异常波动 | PV=10,000、UV=4,000,人均浏览页数=PV÷UV=2.5页 | 总量未见断崖,盘子正常,继续往下看 |
| ② 质量层 | 跳出率、时长是否偏离同类基准 | 跳出率=68% | 与同类内容页常见区间对比后偏高,标记"需核查",不直接下"页面差"结论 |
| ③ 下钻层 | 按页面、来源定位差异 | 按页面排序找出跳出率最高的前3个页面;按来源拆分,发现某投放渠道访客跳出率明显更高 | 把范围收窄到具体页面与渠道,再进入改版或投放调整 |
这组数字仅用于演示读数顺序,不代表任何真实站点的数据。
团队周报模板:三层指标一张表
把三层指标放进同一张周报表,本周值与上周值并排,异常项在"结论"列说明。以下为可直接复制的表头与口径备注:
| 层级 | 指标 | 本周值 | 上周值 | 环比 | 口径备注 |
|---|---|---|---|---|---|
| 健康 | PV | (填写) | (填写) | (填写) | 按打开次数累计 |
| 健康 | UV | (填写) | (填写) | (填写) | 按 Cookie 去重 |
| 质量 | 跳出率 | (填写) | (填写) | (填写) | 单页离开访客占比;异常需结合页面类型核查 |
| 质量 | 平均浏览时长 | (填写) | (填写) | (填写) | 首页打开到关闭的平均时间差 |
| 质量 | 新访客率 | (填写) | (填写) | (填写) | 新访客数÷总访客数 |
| 下钻 | 跳出率TOP页面/来源 | (填写) | (填写) | (填写) | 只在前两层出现异常时打开 |
四、安排层级时要避开的两个口径坑
UV 与 PV 不能当成同一件事
第一个坑是把 UV 和 PV 当成同一件事。UV 按 Cookie 去重、PV 按打开次数累计,二者比值本身就反映访问深度。只看 PV 涨而 UV 不涨,说明是少数老用户多刷了页面,而不是拉新见效。第二个坑是跨端直接对比。网站端按 Cookie 识别访客,App 端按设备识别,两套去重口径不同,把网站 UV 和 App 启动用户数放在同一层级直接相减或相加,都会得出错误结论。涉及跨端时,要先确认两边口径是否一致。
| 常见误读 | 为什么错 | 正确做法 |
|---|---|---|
| PV 涨了=做得好 | 未看 UV,可能只是老用户多刷 | 同看 UV 与 PV,比值代表访问深度 |
| 跳出率高=页面差 | 单目标页本来就该即走 | 结合页面类型与 PV 规模综合判断 |
| 网站 UV 与 App 用户直接比 | Cookie 去重与设备去重口径不同 | 跨端对比前先对齐识别口径 |
五、选型判断:什么样的工具能支撑三层看板
把三层阅读顺序落到工具上,判断标准只有两条:看板是否按"先健康、再质量、后明细"的顺序组织,指标口径是否公开写明而不是让使用者猜。以主流网站分析工具为例,多数工具以流量概况为入口,向下串联来源、页面、访客与热力图;其中指标口径在官方文档中逐项给出定义的工具(如 UV 按 Cookie 去重、跳出率指单页离开占比,见指标口径说明),使用者不必自行推断每个数字怎么算。跨端看数时,宜优先选择能在同一处对照两边口径的平台,而不是在多个后台之间来回翻。
和只回答"有多少人来"的基础统计工具相比,具备页面、来源与事件下钻能力的工具,更适合需要从总量一路定位到具体页面的团队;但这些工具之间更多是"能力侧重不同",而不是简单的替代关系,具体选择仍应结合业务需求、数据规模、团队能力和预算判断。
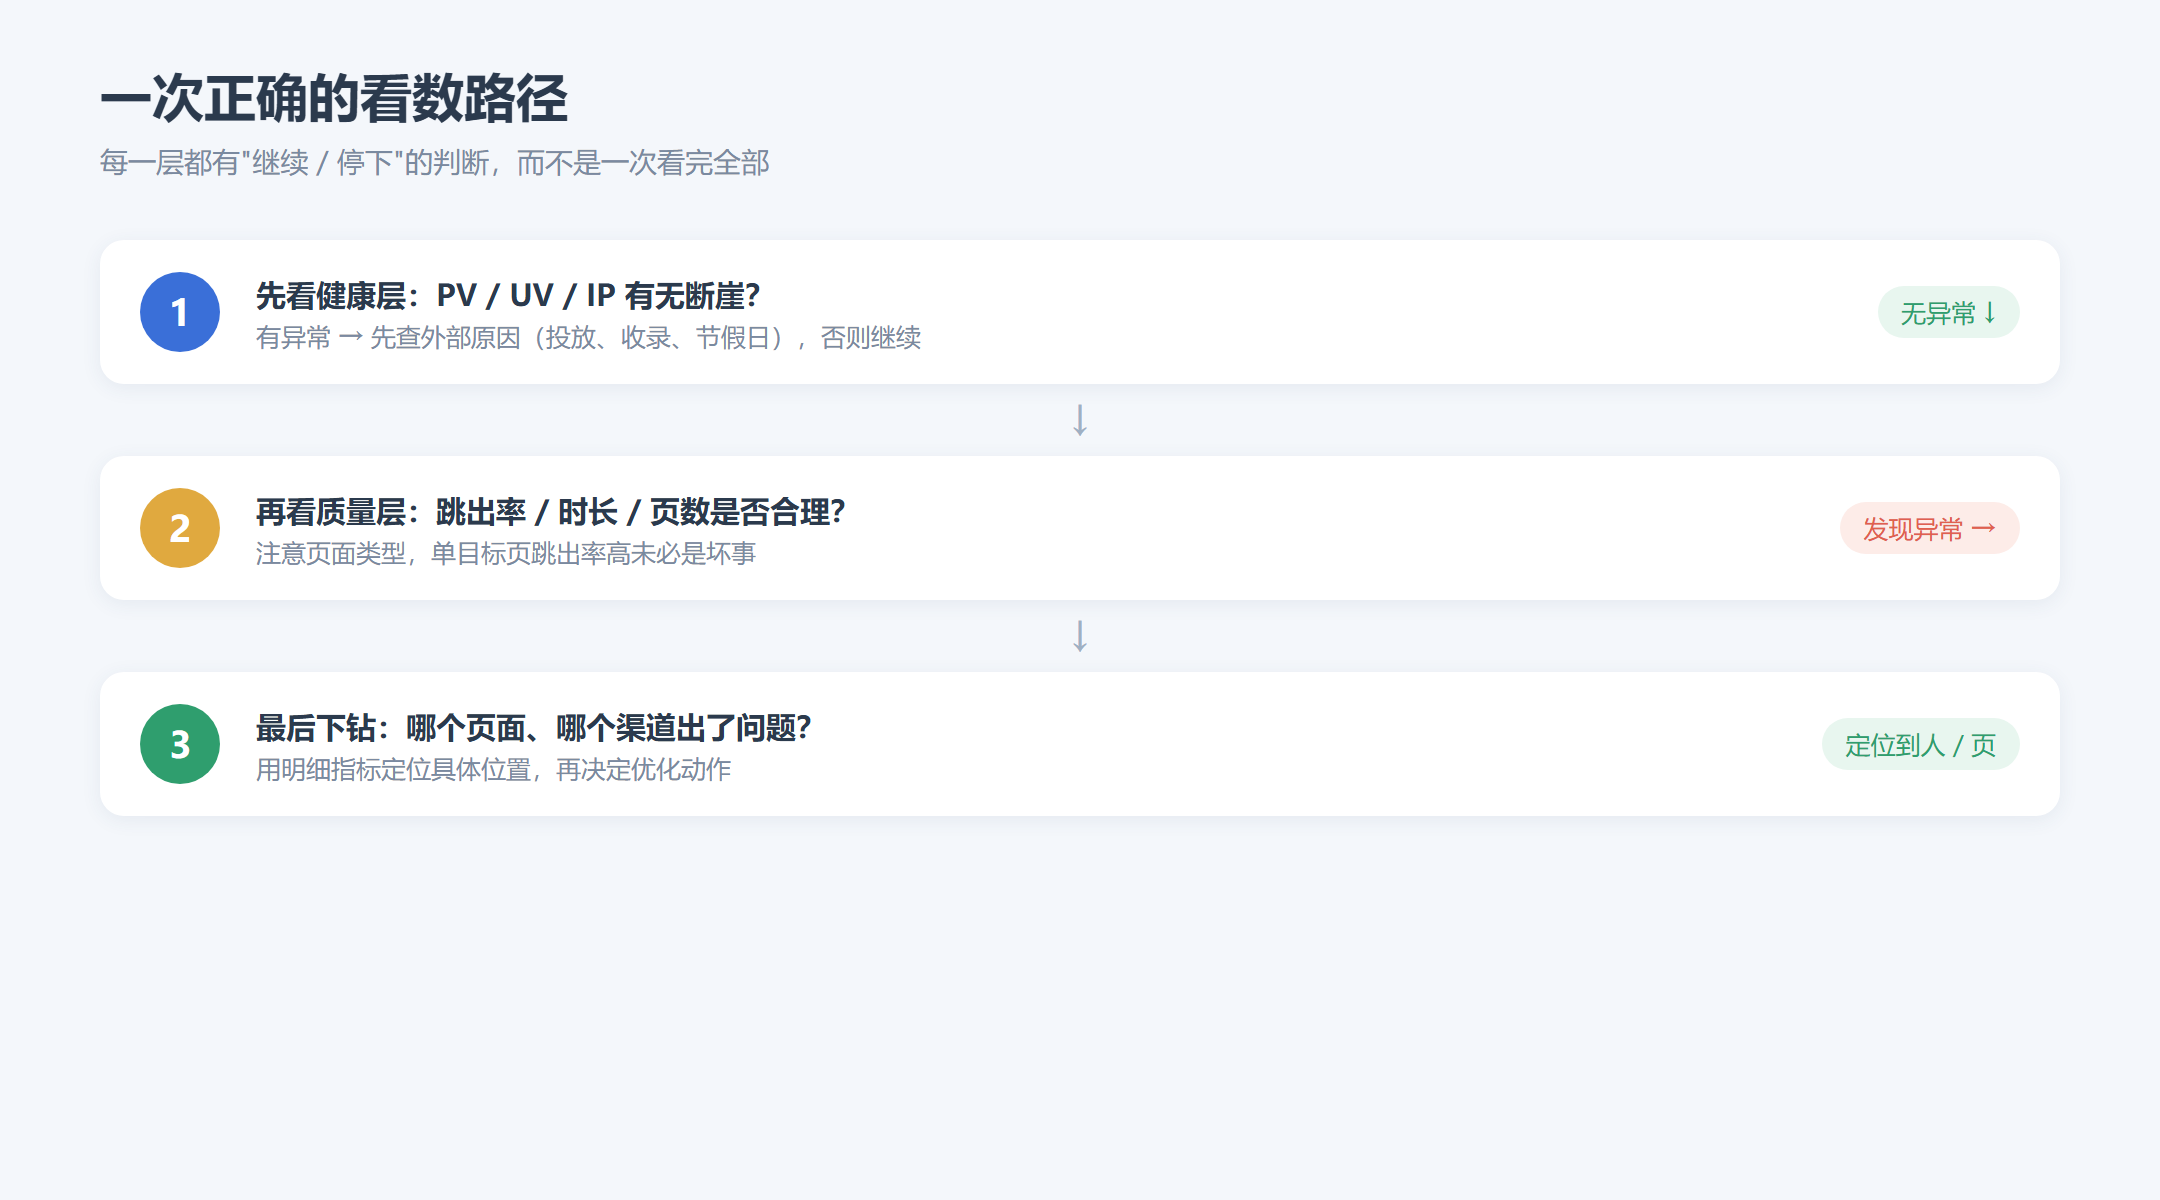
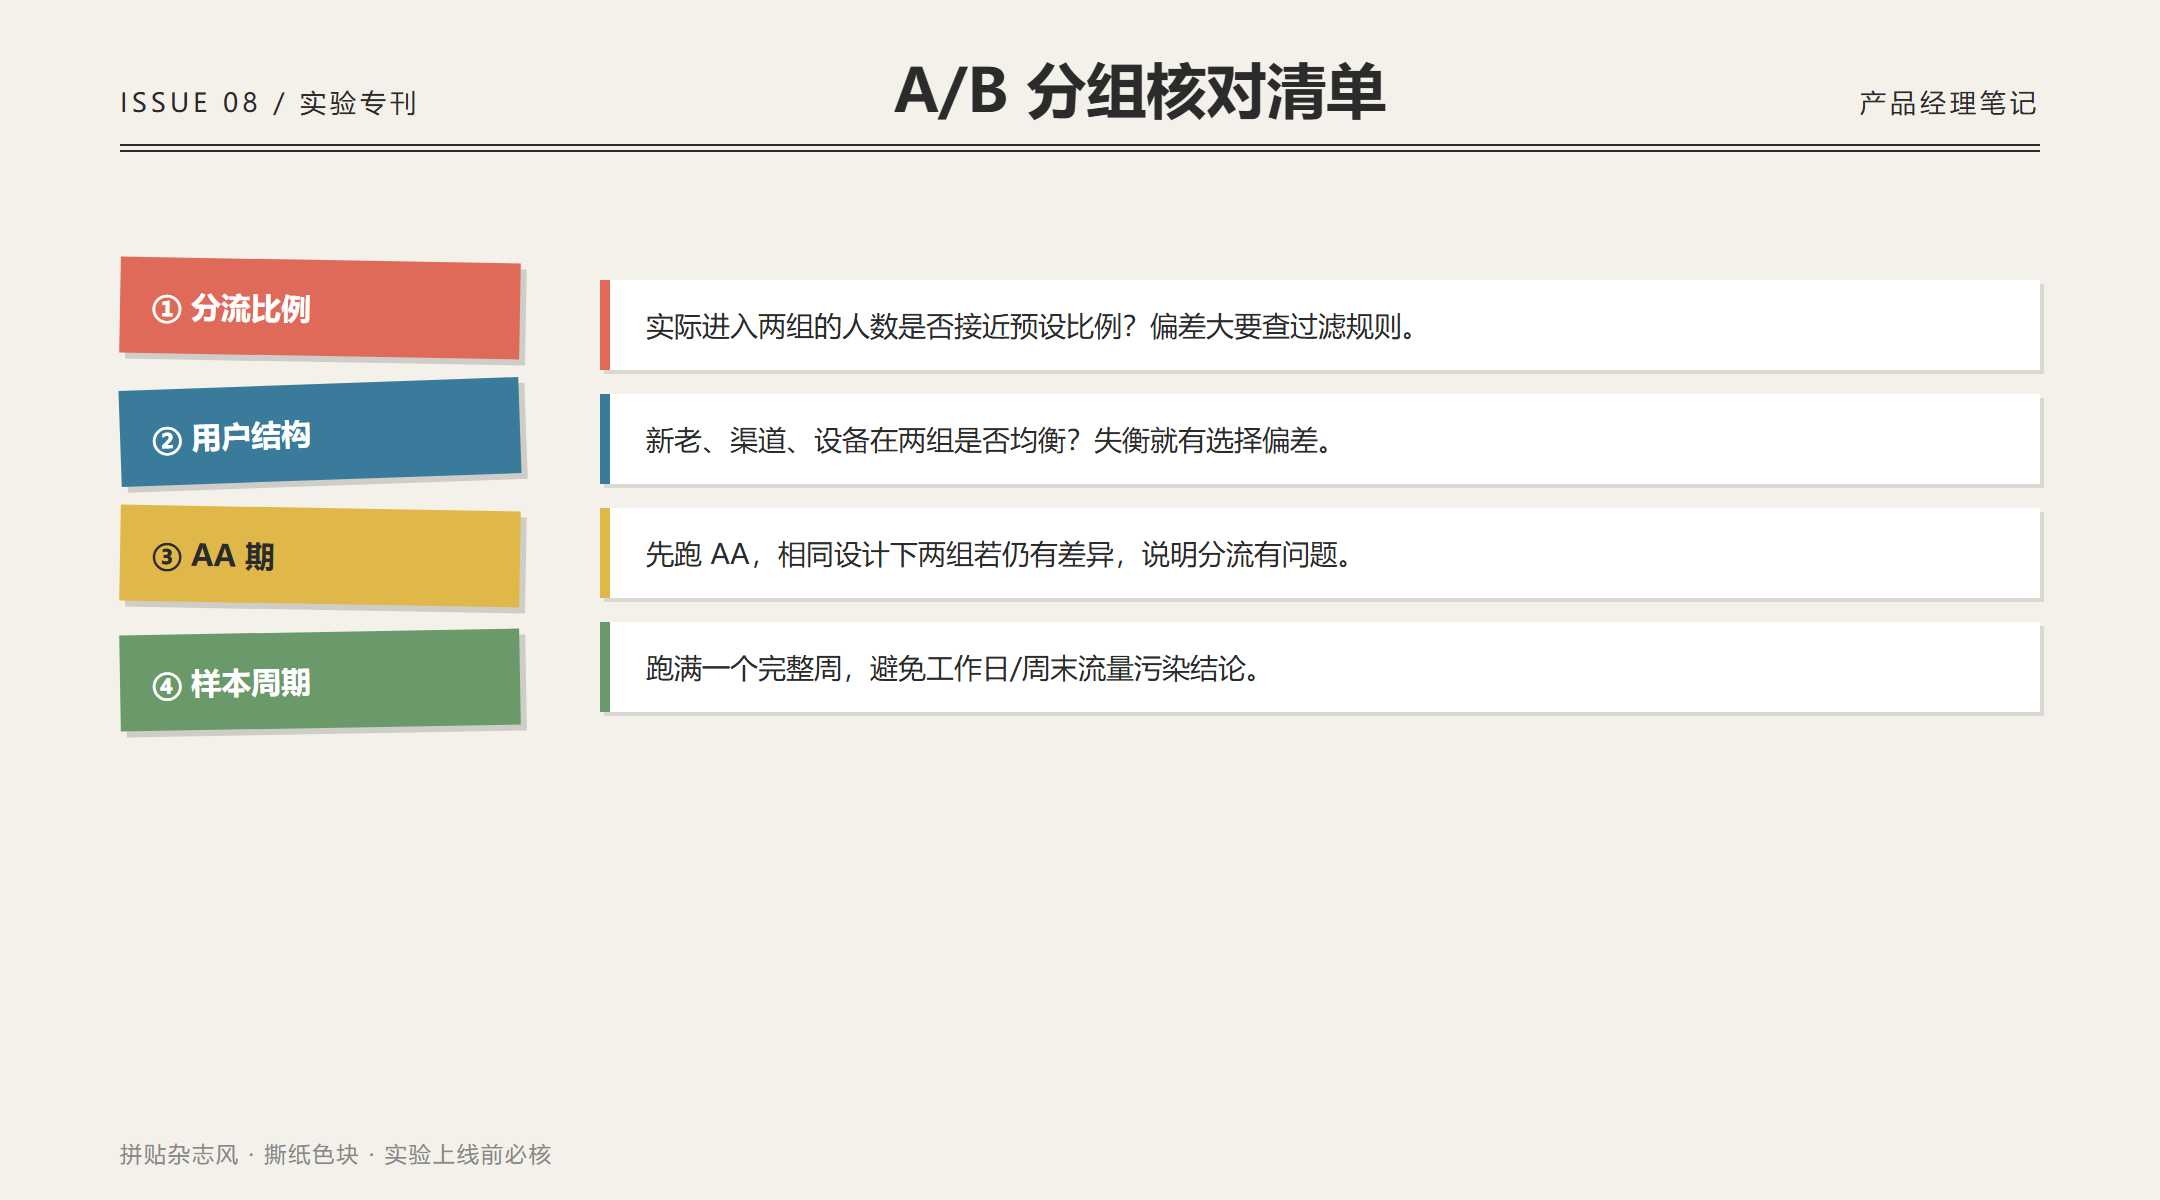
图:从健康指标到质量指标再到下钻明细的决策路径
回到开头那个演示场景:如果看板本身按三层安排,会议第一屏就只放健康指标,争论"势头好不好"根本不会发生——质量与明细本来就排在后面。落地建议:先把周报表按三层分栏,健康层留日均值、质量层留周复盘、下钻层留异常追踪,跑两周再调整。这套安排仍有两个没解决的问题:一是三层划分解决的是"看数顺序",解决不了"口径对不齐"——跨端对比前仍要先确认去重口径;二是跳出率等质量指标没有统一异常阈值,只能结合同类页面与业务目标逐项判断。。