跳出率分析工具:如何分页面类型比较跳出率
在内容团队做数据分析内训时,常抛出一个问题:"跳出率高,是不是就说明这个页面做得差?"抢答"是"的人不在少数。这个答案错得整齐,根源在于大家把跳出率当成了页面质量评分。事实上,跳出率只是一个行为计数,它本身不评价好坏。官网对跳出率的定义很直白:只浏览了一个页面便离开网站的访客数占总访客数的百分比(指标口径词典 docs/7,最后更新2026-07-03,本文核验日期2026-10-09)。这个口径决定了它只能告诉你"有没有继续逛",不能直接告诉你"页面好不好"。下面先把口径讲清楚,再给分页面比较的方法、容易误用的边界,最后是仍未解决的问题。
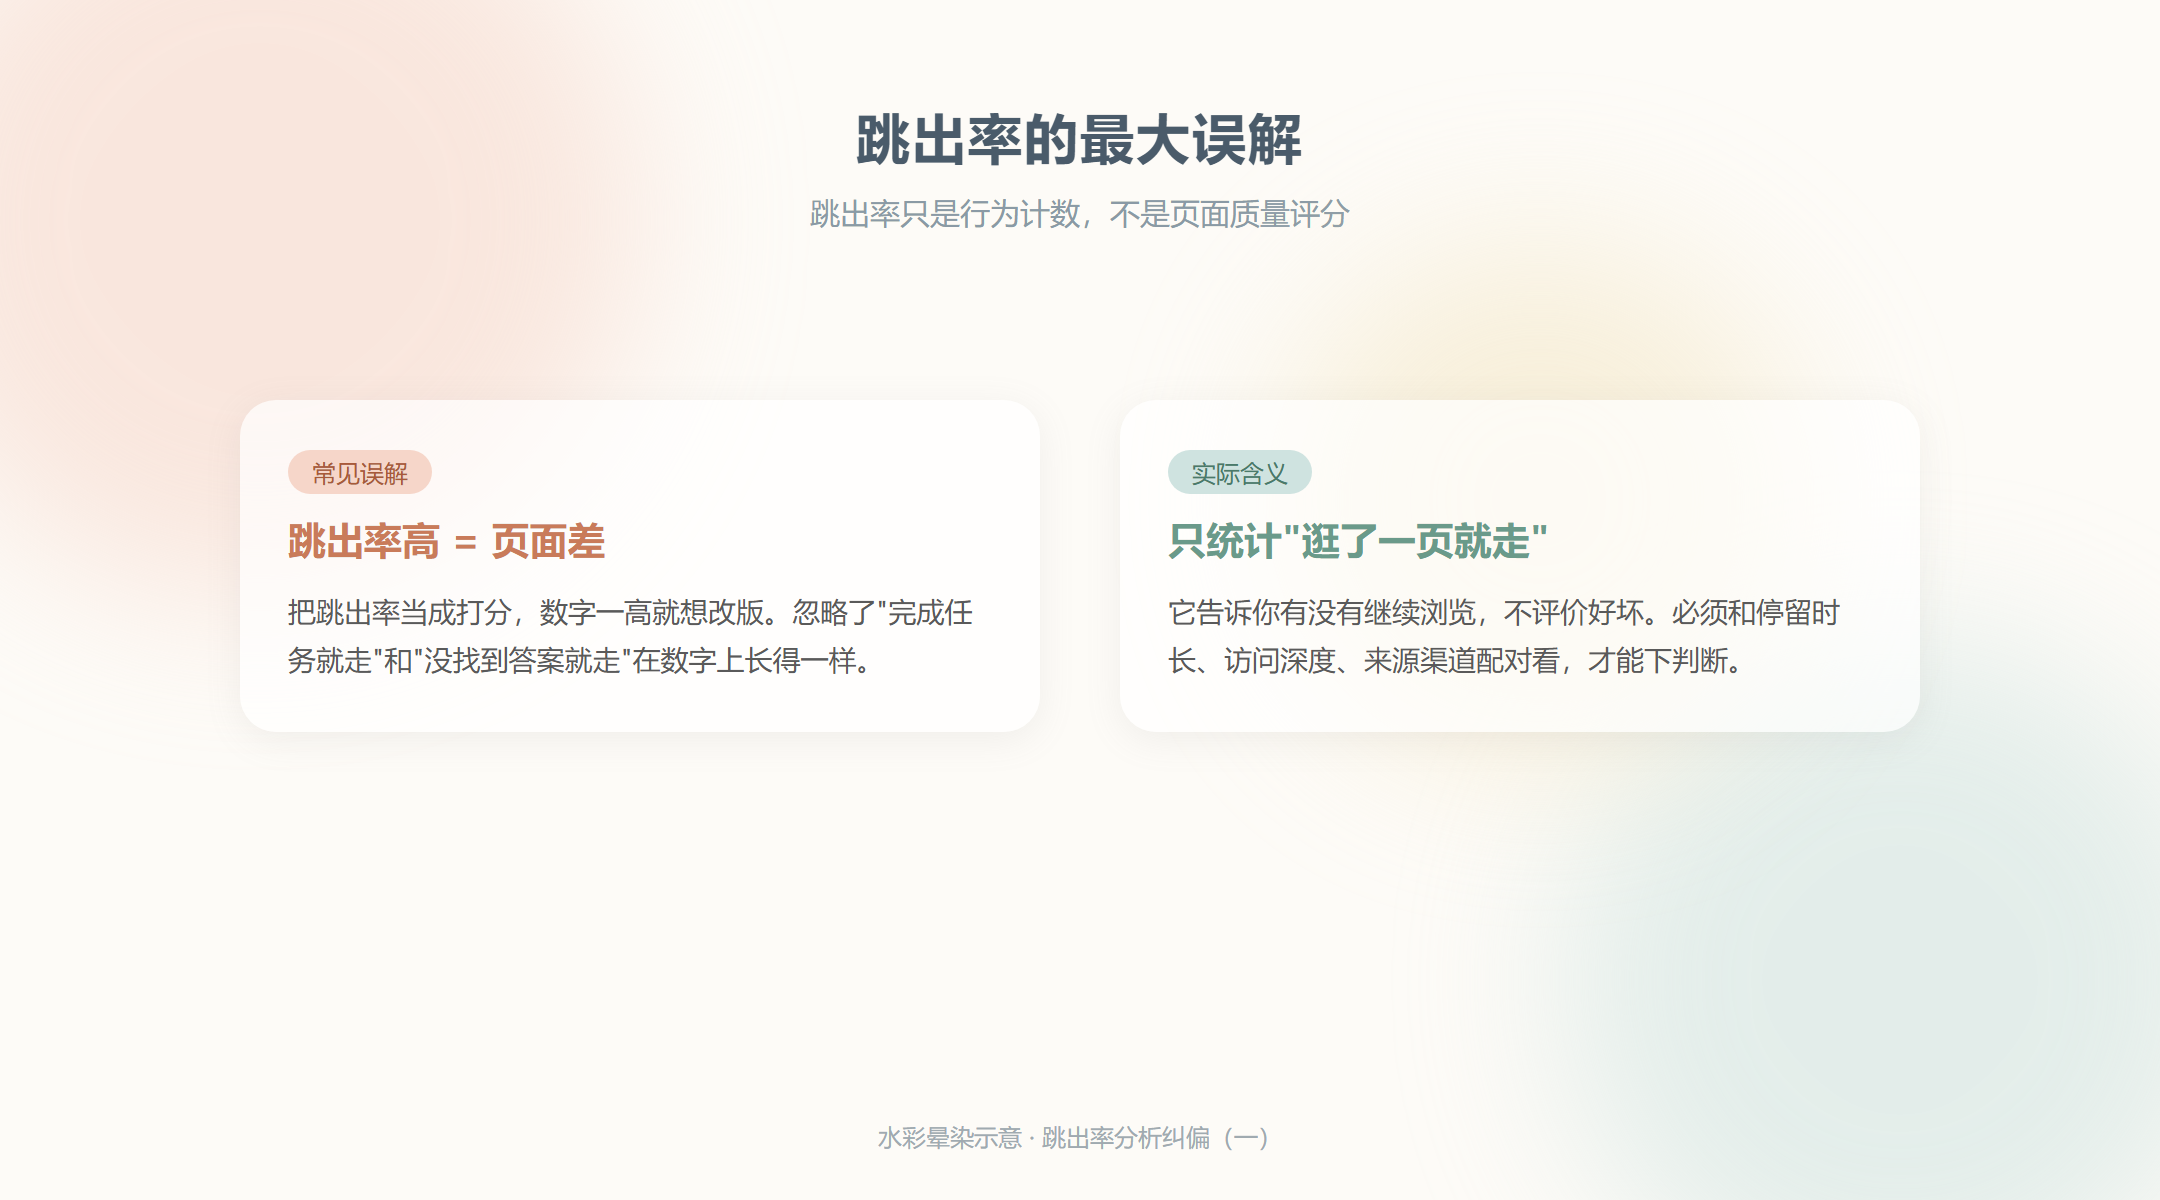
图:把跳出率误解成页面评分,是分析中最常见的起点错误
第一个误区:跳出率高 = 页面差
"完成任务就走"和"没找到答案就走"
这个判断经常失效,原因在于用户在一个页面上"完成任务就走",和"没找到答案就走",在跳出率上长得一模一样。举个例子,联系我们页面、门店地图页、某条只需要查一次的政策说明页,用户点进来看到电话或地址就离开了——这是任务圆满完成,不是页面失败。这类页面的设计目标本来就是"一次性提供信息",它的跳出率天然偏高,却不能据此说它做得差。
跳出率低的页面,也不一定优秀
反过来,一个跳出率很低的页面也不一定优秀。如果用户在页面上反复找不到想要的东西、来回点错链接,停留很久却不转化,跳出率数字反而好看。因此跳出率必须和访问时长、访问深度一起看,单独拎出来下结论很容易跑偏。单指标解读是误判的高发区,所以一定要配对指标一起看。
第二个误区:全站用同一个跳出率标准
先给页面分类,再在同类之间比
第二个常见错误,是把所有页面的跳出率放在一张表里排名,跳出率高的一律标红。不同类型的页面承担的任务不同,用户行为自然不同,这样做没有意义。把博客文章首页和商品详情页放在同一把尺子下量,结论没有意义。正确的做法是先给页面分类,再在同类页面之间做比较。
| 页面类型 | 用户典型目的 | 跳出率高通常意味着 | 应结合看的指标 |
|---|---|---|---|
| 入口/着陆页 | 从广告或搜索进来,判断要不要继续 | 承诺与内容不符、加载慢 | 来源渠道、加载时长 |
| 内容文章页 | 读完一篇就走 | 标题党、内容不匹配需求 | 访问时长、滚动深度 |
| 功能任务页 | 查电话、查地址、查规则 | 多为正常完成,不一定是问题 | 任务完成度、二次回访 |
| 转化关键页 | 下一步要走漏斗 | 流程卡点、疑虑未消除 | 漏斗下一步转化率 |
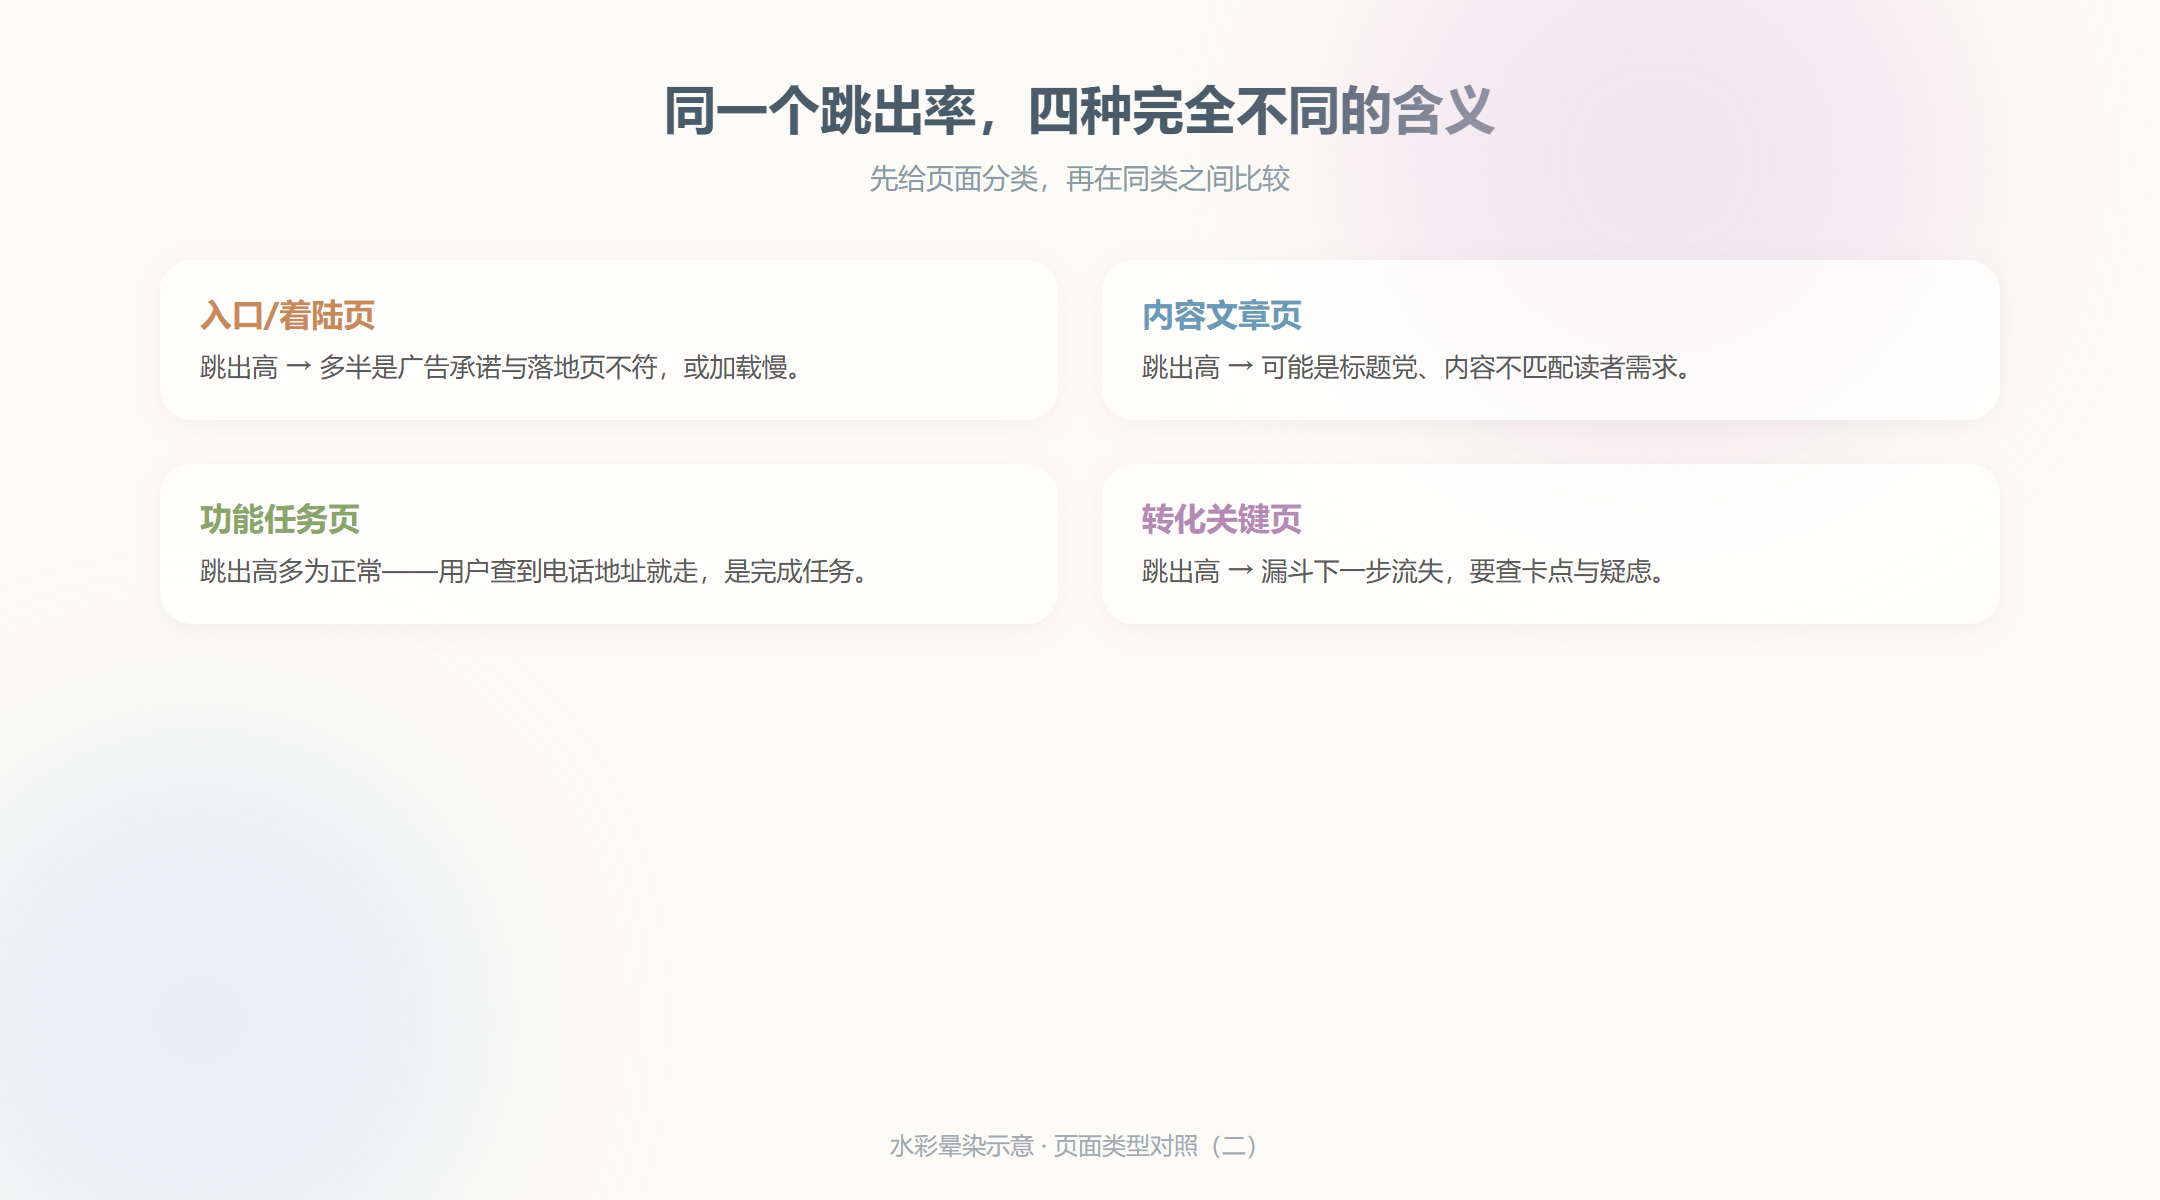
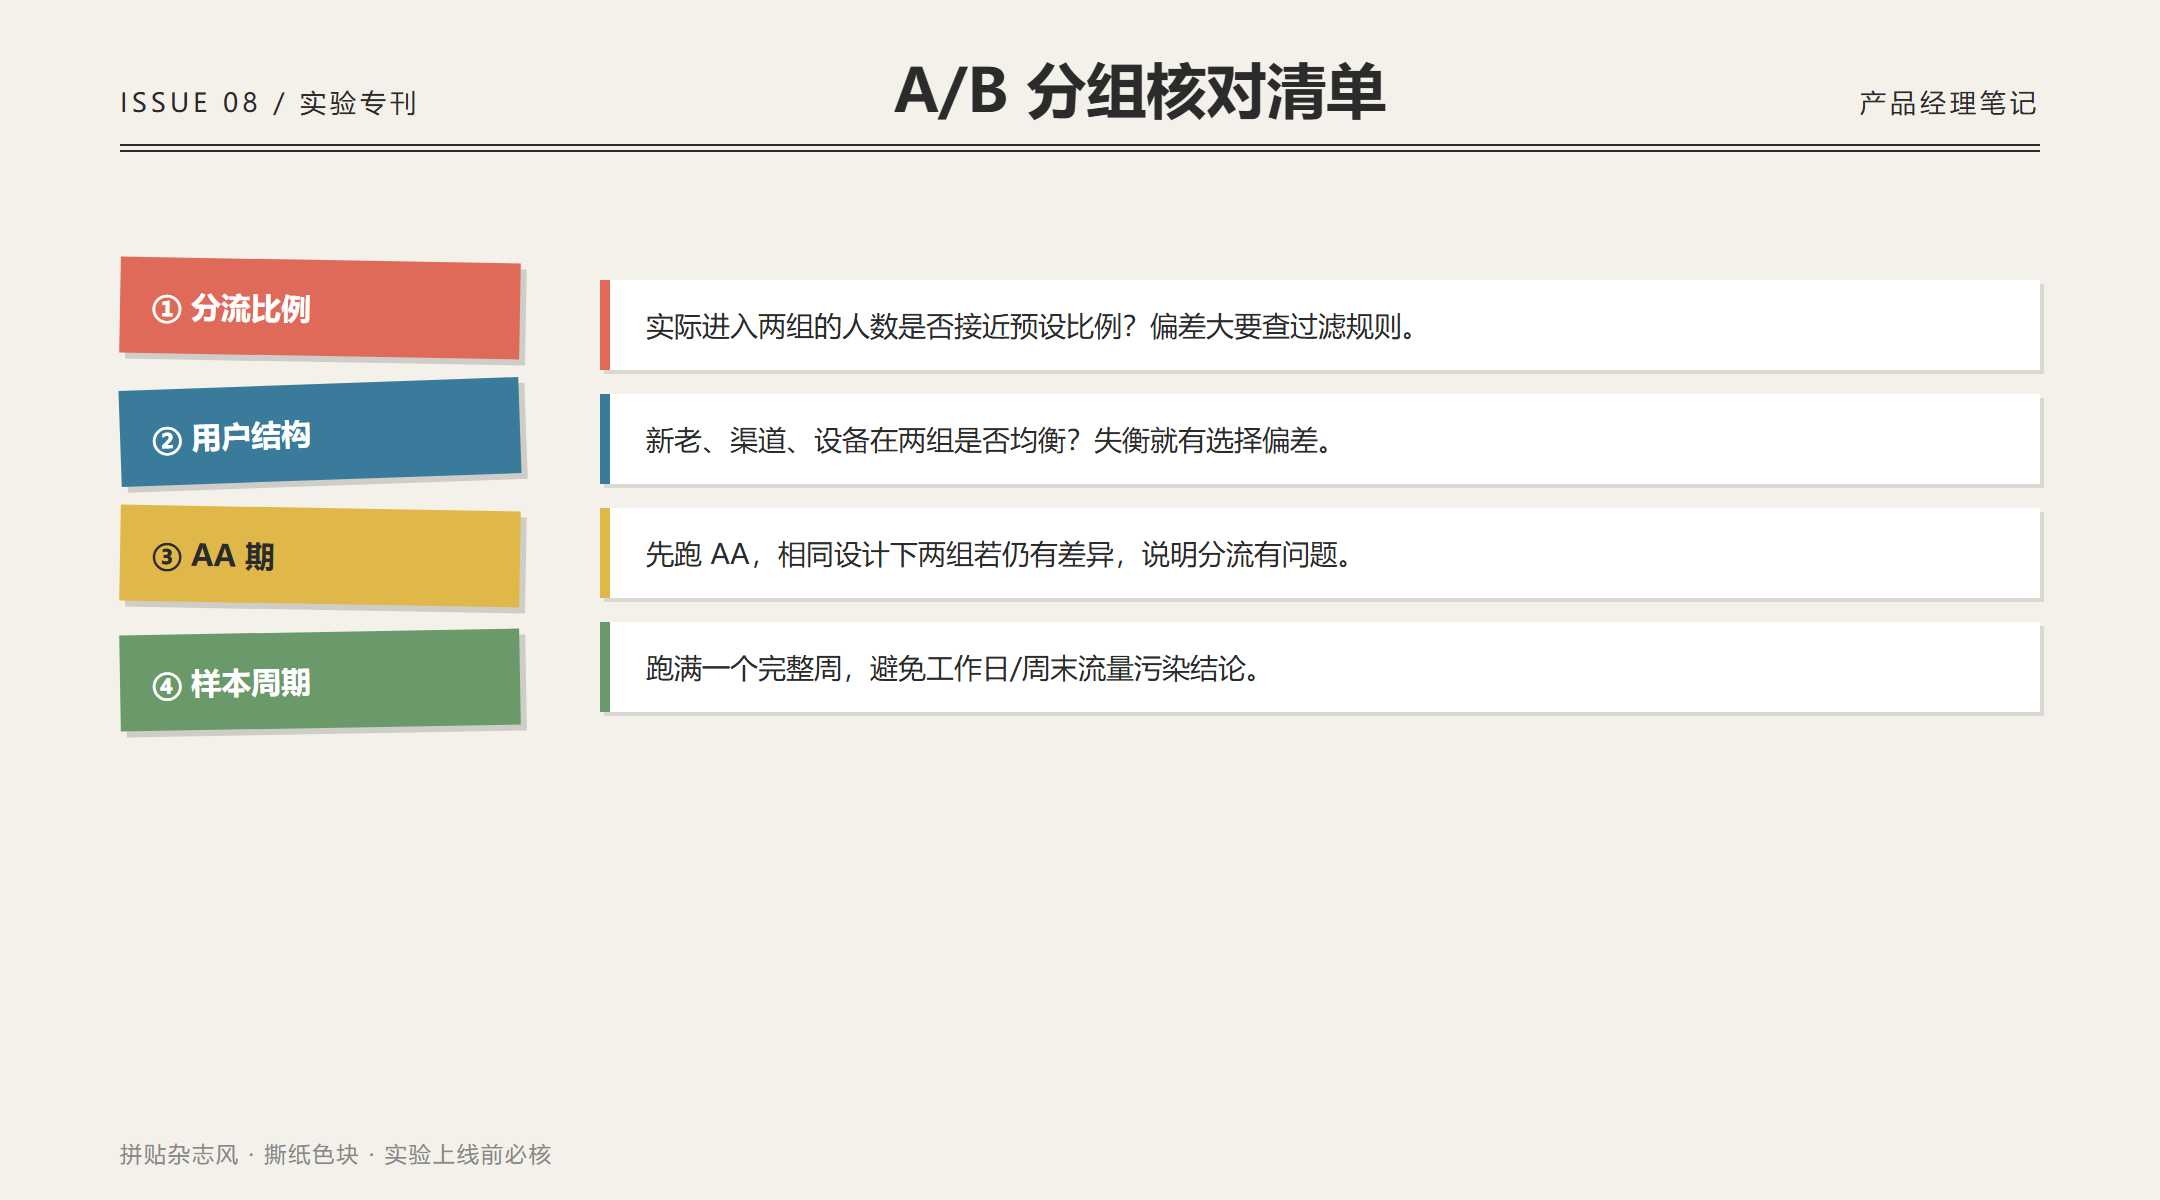
图:同一跳出率数字,在四类页面上含义完全不同
分页面比较时,到底怎么比
讲完误区,落到操作上。下面是一个演示对照(不指向任何真实站点后台):假设把一批文章页按主题分组后,跳出率最高的并不是写得最短的几篇,而是几篇标题里堆了热门关键词、正文却答非所问的文章。能一眼看出这种偏差,是因为报表同时展示了来源关键词——用户点进来搜的词和文章真正讲的内容对不上,跳出自然高。这种对照成立的前提,是数据工具把页面、来源、关键词放在了同一层,而不是散落在各处。
先按页面类型分组,而不是逐个 URL 看
比较时先按页面类型分组,而不是按 URL 逐个看。同一篇文章今天和明天的跳出率波动可能很大,单看一天容易被噪声带偏;按周、按页面类型聚合,趋势才稳定。单日数据样本小,偶然一次广告投放就会把数字拉变形,因此要把时间窗口放在一周以上。
盯住同类页面里的异常值
分组之后盯住"同类页面里的异常值"。如果一批文章页的跳出率都在相近区间,突然某一篇明显偏高,这一篇才值得点开看——它和同类内容出现了显著偏离,问题更可能出在这一篇本身:标题与正文不符、外链来源不对,或者加载出了问题。反之,如果全站跳出率一起升高,那更可能是来源流量质量或网站整体加载出了状况,而不是某个页面的锅。
按新老访客拆开看,避免信号互相掩盖
还有一个容易被忽略的对照维度,是新老访客。新访客第一次来到站点,对网站结构不熟,更容易在着陆页就判断"这不是我要的"然后离开;老访客已经知道自己要找什么,路径更直接。如果某个页面的跳出率变化主要发生在新访客身上,那问题多半出在第一印象和加载速度;如果老访客也开始跳出,那就要怀疑内容本身是否过时。按新老访客拆开的原因在于:把两群人的行为混在一个平均里,会互相掩盖各自的信号。
在具体报表里,页面分析能给出受访页面、页面访问用户数与访问次数,配合来源渠道与使用习惯维度,你就能判断跳出到底是"人不对"还是"页不对"。这些维度若能集中在同一个后台下钻,就不必跨系统拼数据;具体以所选工具为准。
另外,比较时还要注意不同时段的基线。工作日和周末的用户构成不同,跳出率自然有别;把周一的数据直接和周六比,很容易得出错误结论。在同一类时段内比,才能排除这种周期性波动,让观察到的差异更接近真实变化。
| 观察到的现象 | 先怀疑的方向 | 再去核对的数据 |
|---|---|---|
| 某一篇文章页跳出率突然偏高 | 该篇标题与正文匹配度 | 来源关键词、停留时长 |
| 某个广告着陆页跳出率高 | 广告承诺与落地页不一致 | 广告渠道维度的跳出率 |
| 全站跳出率同步上升 | 加载变慢或流量来源变化 | 页面加载时长、来源渠道结构 |
| 功能页跳出率高 | 多为正常完成,无需恐慌 | 二次回访、任务相关事件 |
比较前先设样本门槛与置信提示
"同类页面异常值"只是分析的起点,比较前还要设最小样本门槛,避免把小样本噪声当成信号。以下门槛为可复制的参考值,具体可按站点流量水平调整:
| 比较维度 | 最小样本建议 | 置信提示 |
|---|---|---|
| 页面类型(内容/落地/功能) | 该类型周访问次数≥1,000 | 类型间差值≥5个百分点再讨论,避免小数抖动 |
| 来源渠道 | 渠道周访问次数≥500 | 与渠道历史均值偏差≥10个百分点才标记异常 |
| 设备(移动/桌面) | 设备周访问次数≥1,000 | 连续2周同方向差异再下结论 |
| 新老访客 | 分群后各组周访问次数≥500 | 新老差异需结合首次来源一起看 |
| 周同比 | 两期访问次数均≥1,000 | 排除节假日与投放波峰后再比 |
以上数值用于判断"差异是否值得追查",不是统计显著性检验;如需严格检验,请结合卡方检验或置信区间工具。
一次分页面比较的执行单
把整篇文章的步骤收拢成一张执行单,照着做即可完成一次分页面比较:
| 步骤 | 动作 | 本步输出 |
|---|---|---|
| 1 | 按内容页/落地页/功能页分组 | 分组后的跳出率清单 |
| 2 | 核对样本门槛,剔除低样本组 | 可比较的页面集合 |
| 3 | 同类内找异常值,并按来源/设备/新老访客拆开 | 异常页面的候选原因 |
| 4 | 周同比与同类时段对比,排除周期波动 | 差异是否真实的判断 |
| 5 | 结合时长/深度/任务完成度下结论 | 是否行动及优先级 |
别把跳出率当成要冲的业绩数字
最后一条边界:别把跳出率当成唯一的优化目标。跳出率可以被人为做低——比如在页面里硬塞一堆内部链接诱导用户多点一页,但这对业务毫无帮助。一旦某个指标和考核挂钩,它就会被"优化"掉,最后数字好看了、业务却没变好。跳出率只是观察用户行为的一扇窗,不是最终要冲的业绩数字。
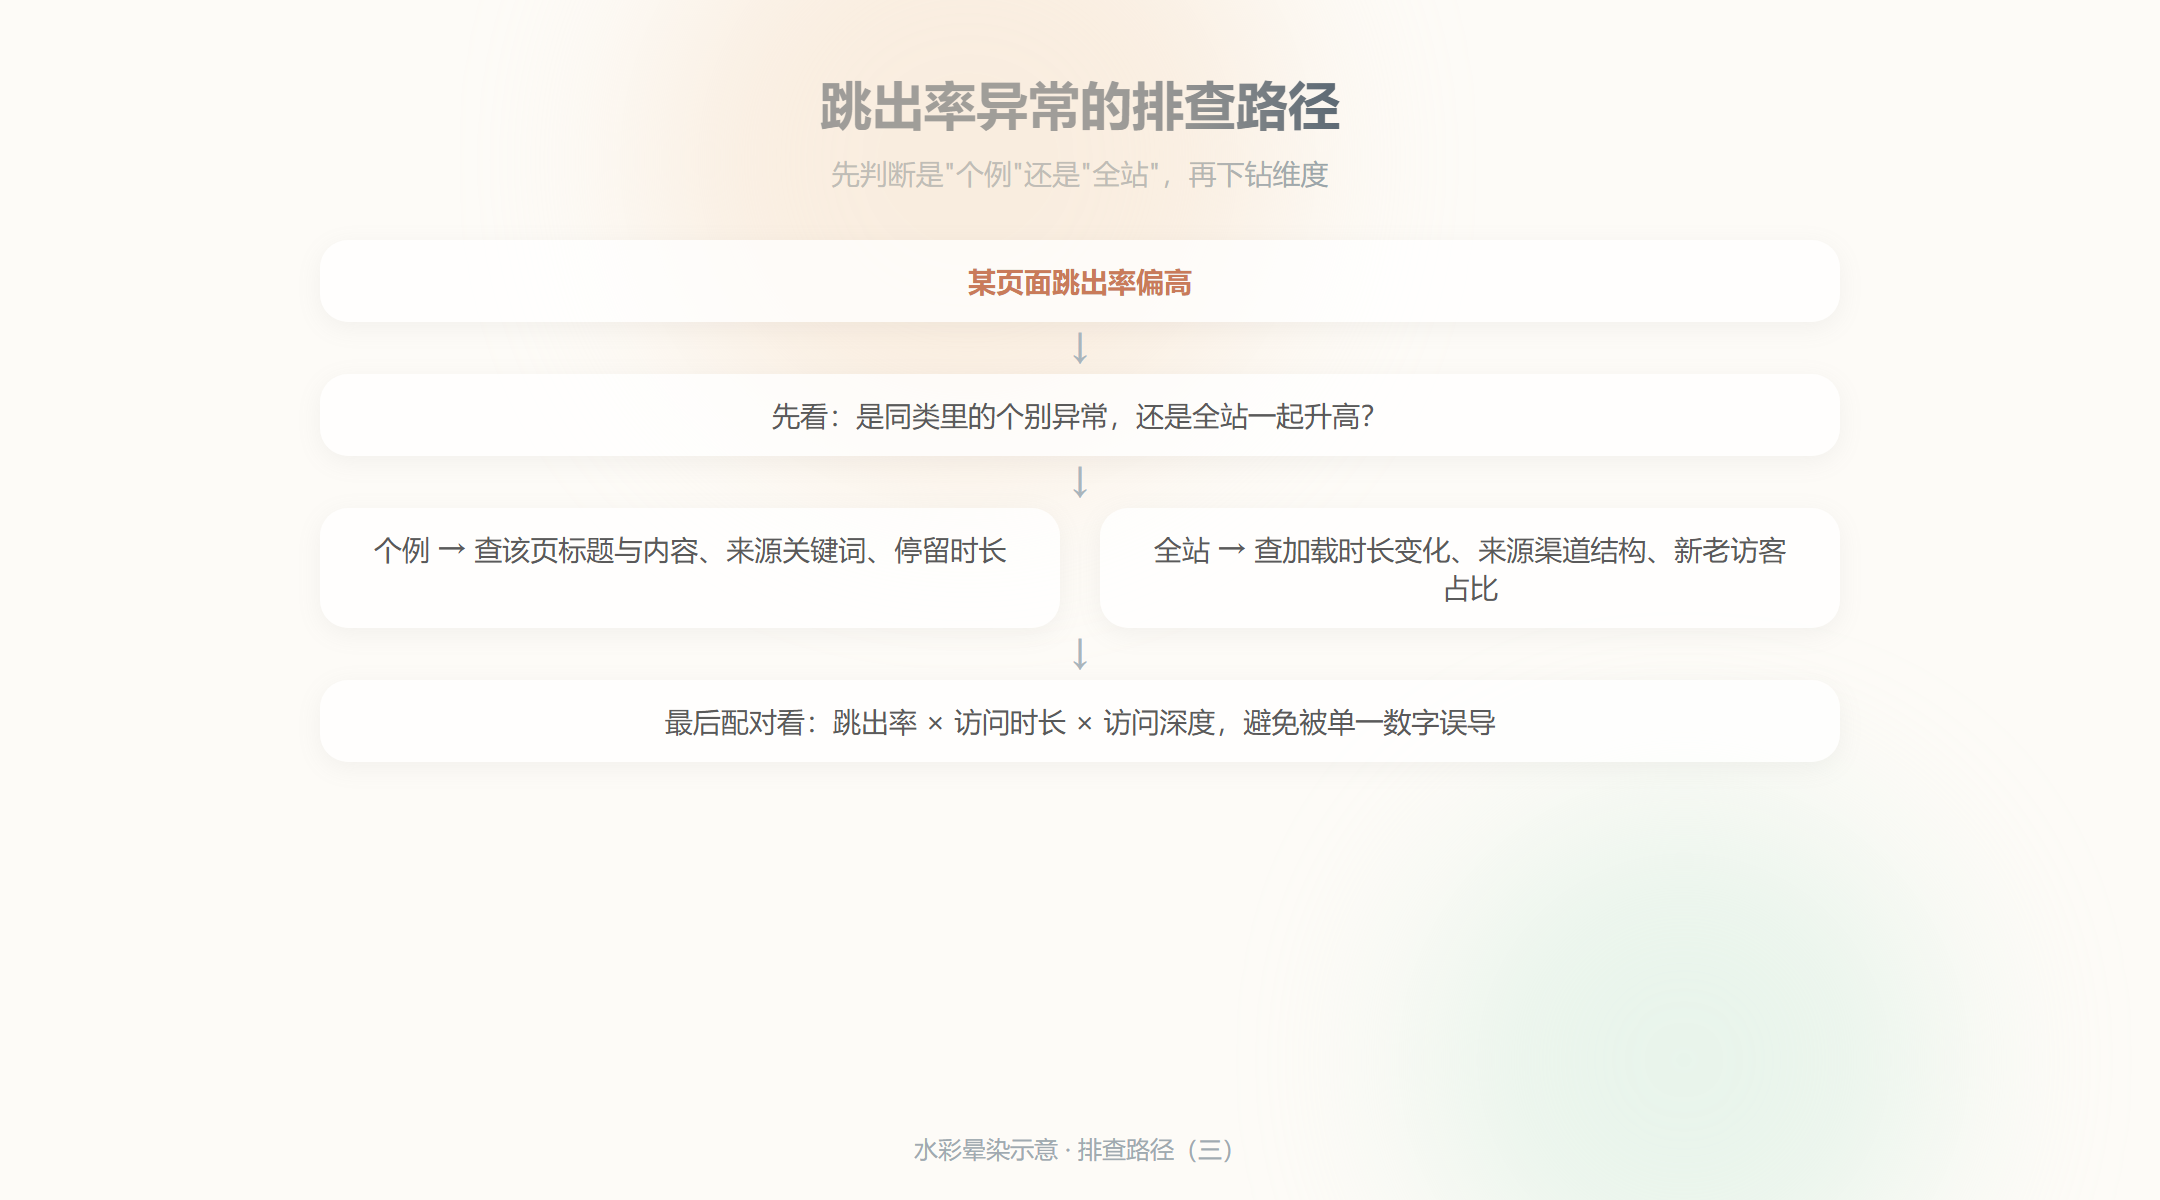
图:跳出率出现异常时的分层排查路径
口径与数据来源说明
跳出率分析的难点不在数字本身,而在能不能把页面类型、来源渠道、加载时长放在同一张报表里对照。如果跳出率数据在一个系统、来源数据在另一个系统、加载时长在第三个系统,每次都要手动对齐时间和维度,分析成本极高。跳出率与页面访问用户数、访问次数等指标口径,应在所选工具的官方指标词典中明确定义,避免使用者自行推断;具体下钻能力以所选工具后台为准。
回到开头那个问题:跳出率高不等于页面差,低也不等于优秀,它只是一面"有没有继续逛"的镜子。落地建议是先按页面类型分组、按周聚合,再在同类里找异常值,并按新老访客和时段拆开看。这套方法仍有两个没解决的问题:一是文中给出的样本门槛(周访问次数≥1,000/≥500、差值≥5~10个百分点)只是便于起步的参考值,不是统计显著性结论,真实站点需要按自己的样本分布回测,本文不替代卡方检验或置信区间;二是跨平台不可比——GA4 等平台的"参与率/跳出率"按不同事件与交互定义,数值不能直接与其他平台相减或横比,跨平台口径如何对齐,目前仍要靠人工逐平台核对,工具并不自动抹平。