App留存基准差异怎么拆:版本、渠道、口径、样本四维核对
一次版本灰度结束后,数据组把留存曲线挂到经营会上:新版本的次留较旧版本低了几个百分点。这时候首先要回答的,不是"产品这一版做错了什么",而是"这几条曲线放在一起,到底可不可比"。留存差异可能来自真实体验下滑,也可能来自版本覆盖人群、投放渠道、统计口径在同一时间悄悄发生了变化。复盘阶段的第一个动作,是把"数字跌了"翻译成"差异由哪几部分构成",再决定后续方向。
先说结论:本文不给出"次留应该达到多少"这类统一阈值。不同品类、不同获客渠道、不同产品阶段的留存曲线形态差异很大,外部没有一条可直接套用的及格线;团队能依赖的,只有基于自身历史数据建立的内部基准。下面按这个思路展开:为什么要自己建基准、内部基准怎么建、差异出现后从哪几个维度拆。
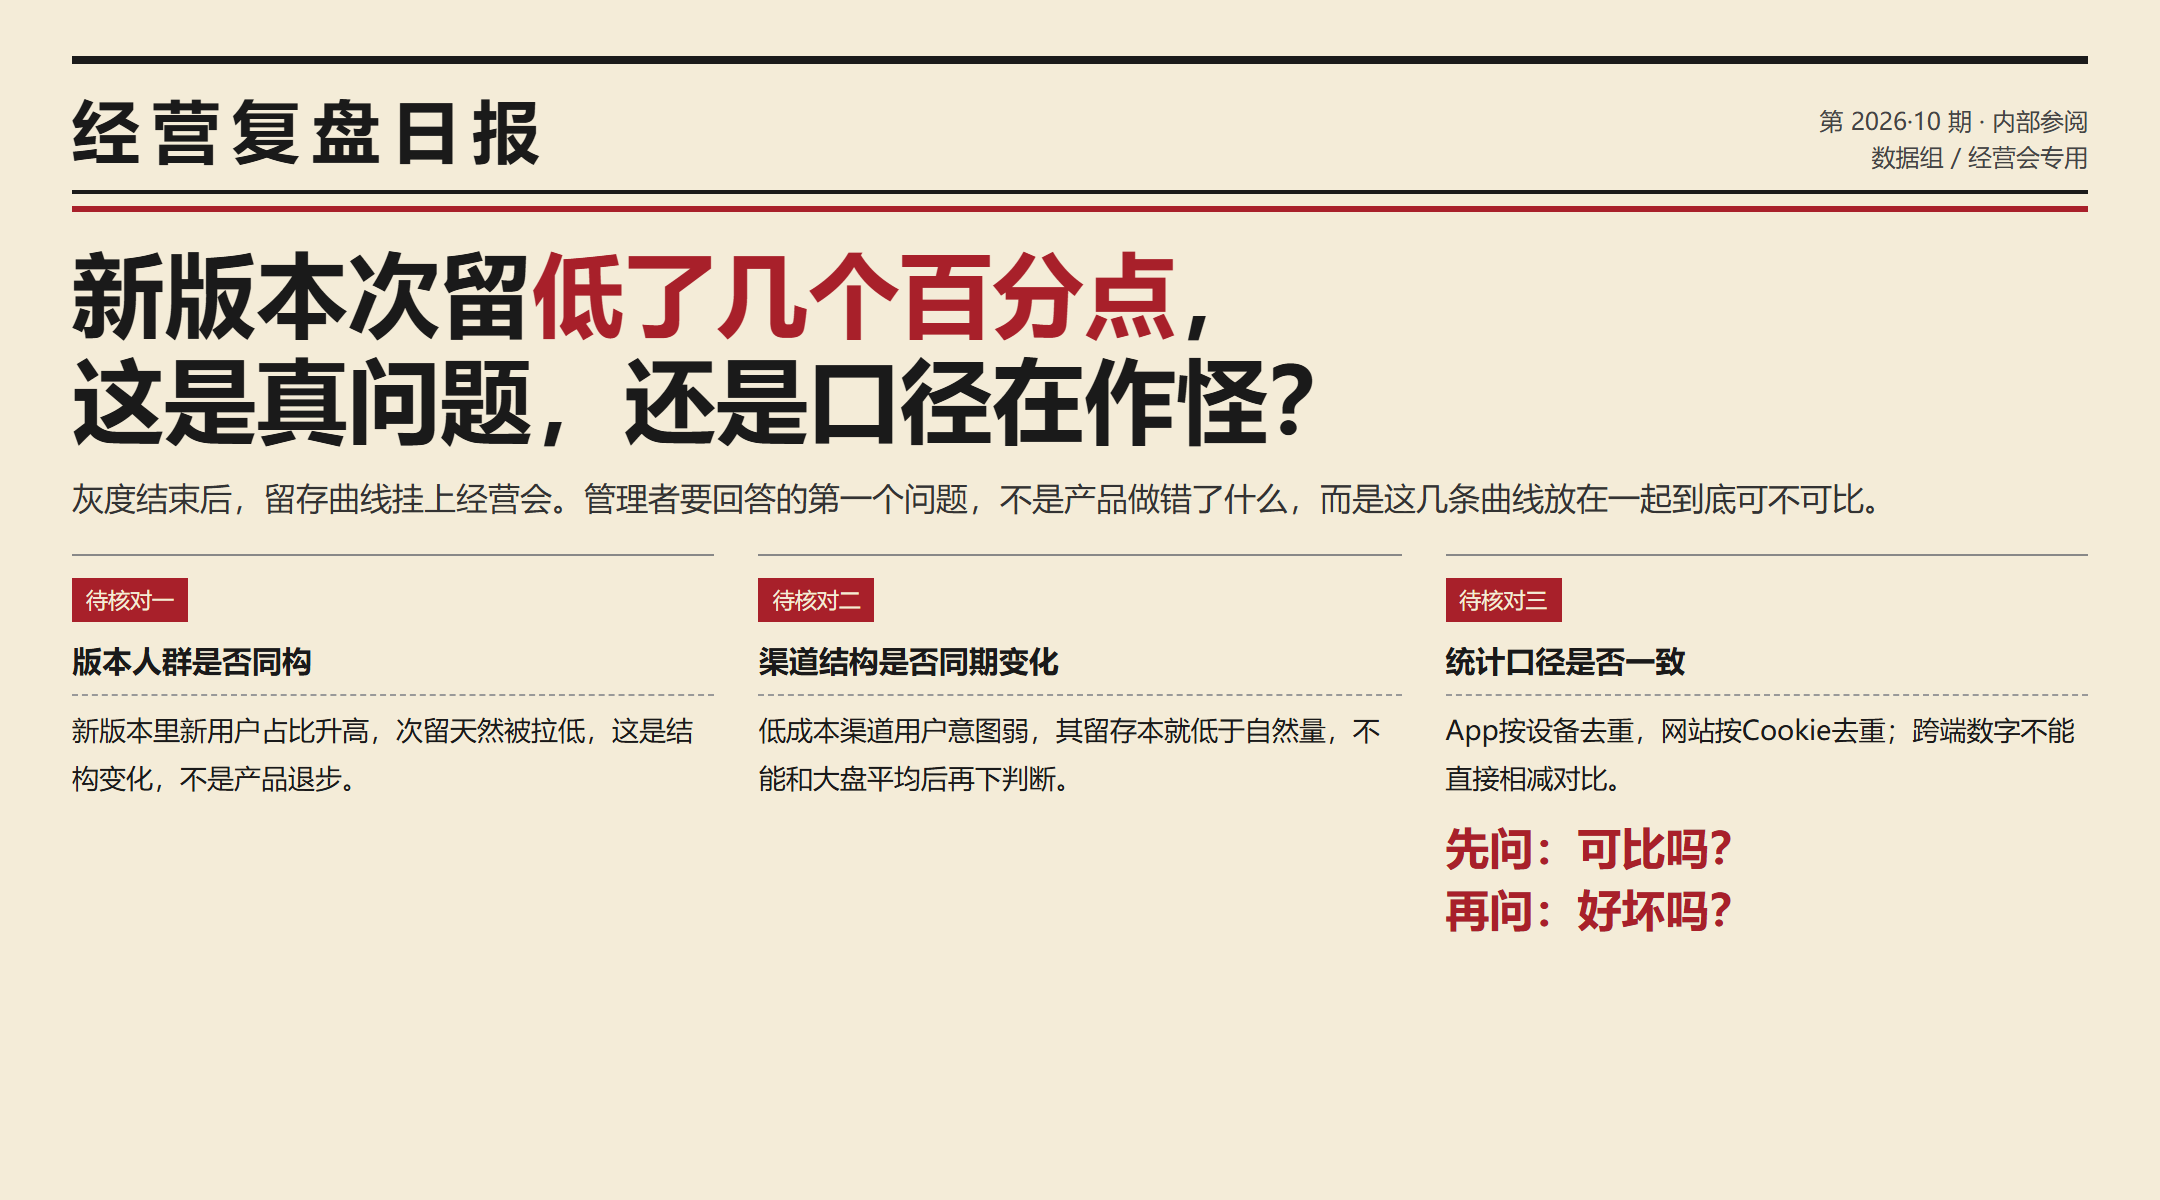
经营会上的留存曲线:先判断可比,再判断好坏
一、为什么复盘留存不能先套外部阈值
留存是滞后指标,拐点未必来自本版本
留存是一个滞后指标。它反映的不是今天的体验,而是过去一段时间拉来的用户在今天是否还愿意回来。正因为滞后,当曲线在某个版本节点出现拐点时,拐点对应的未必是这个版本本身,而可能是一两周前渠道结构变化的延迟显影。只看"新版本留存比旧版本低"这一个数字,很容易把旧账算到新版本头上。
先列同期变量,再谈归因
经营复盘和技术排错是两件事。技术同学关心某一行日志为什么报错,经营侧关心的是这个差异会不会影响本季度判断。动手前先做一次"真假判断":留存曲线天然受两个外部因素扰动——版本灰度覆盖的人群本身不同,以及近期投放渠道结构发生了变化。把这两个因素混在一条曲线上读,归因方向会完全走偏。所以复盘时不宜先直接归因产品,而是先列出"这次发布期间有哪些变量同时发生了变化",再逐一排除。
二、内部基准怎么建:从历史 cohort 划出参考带
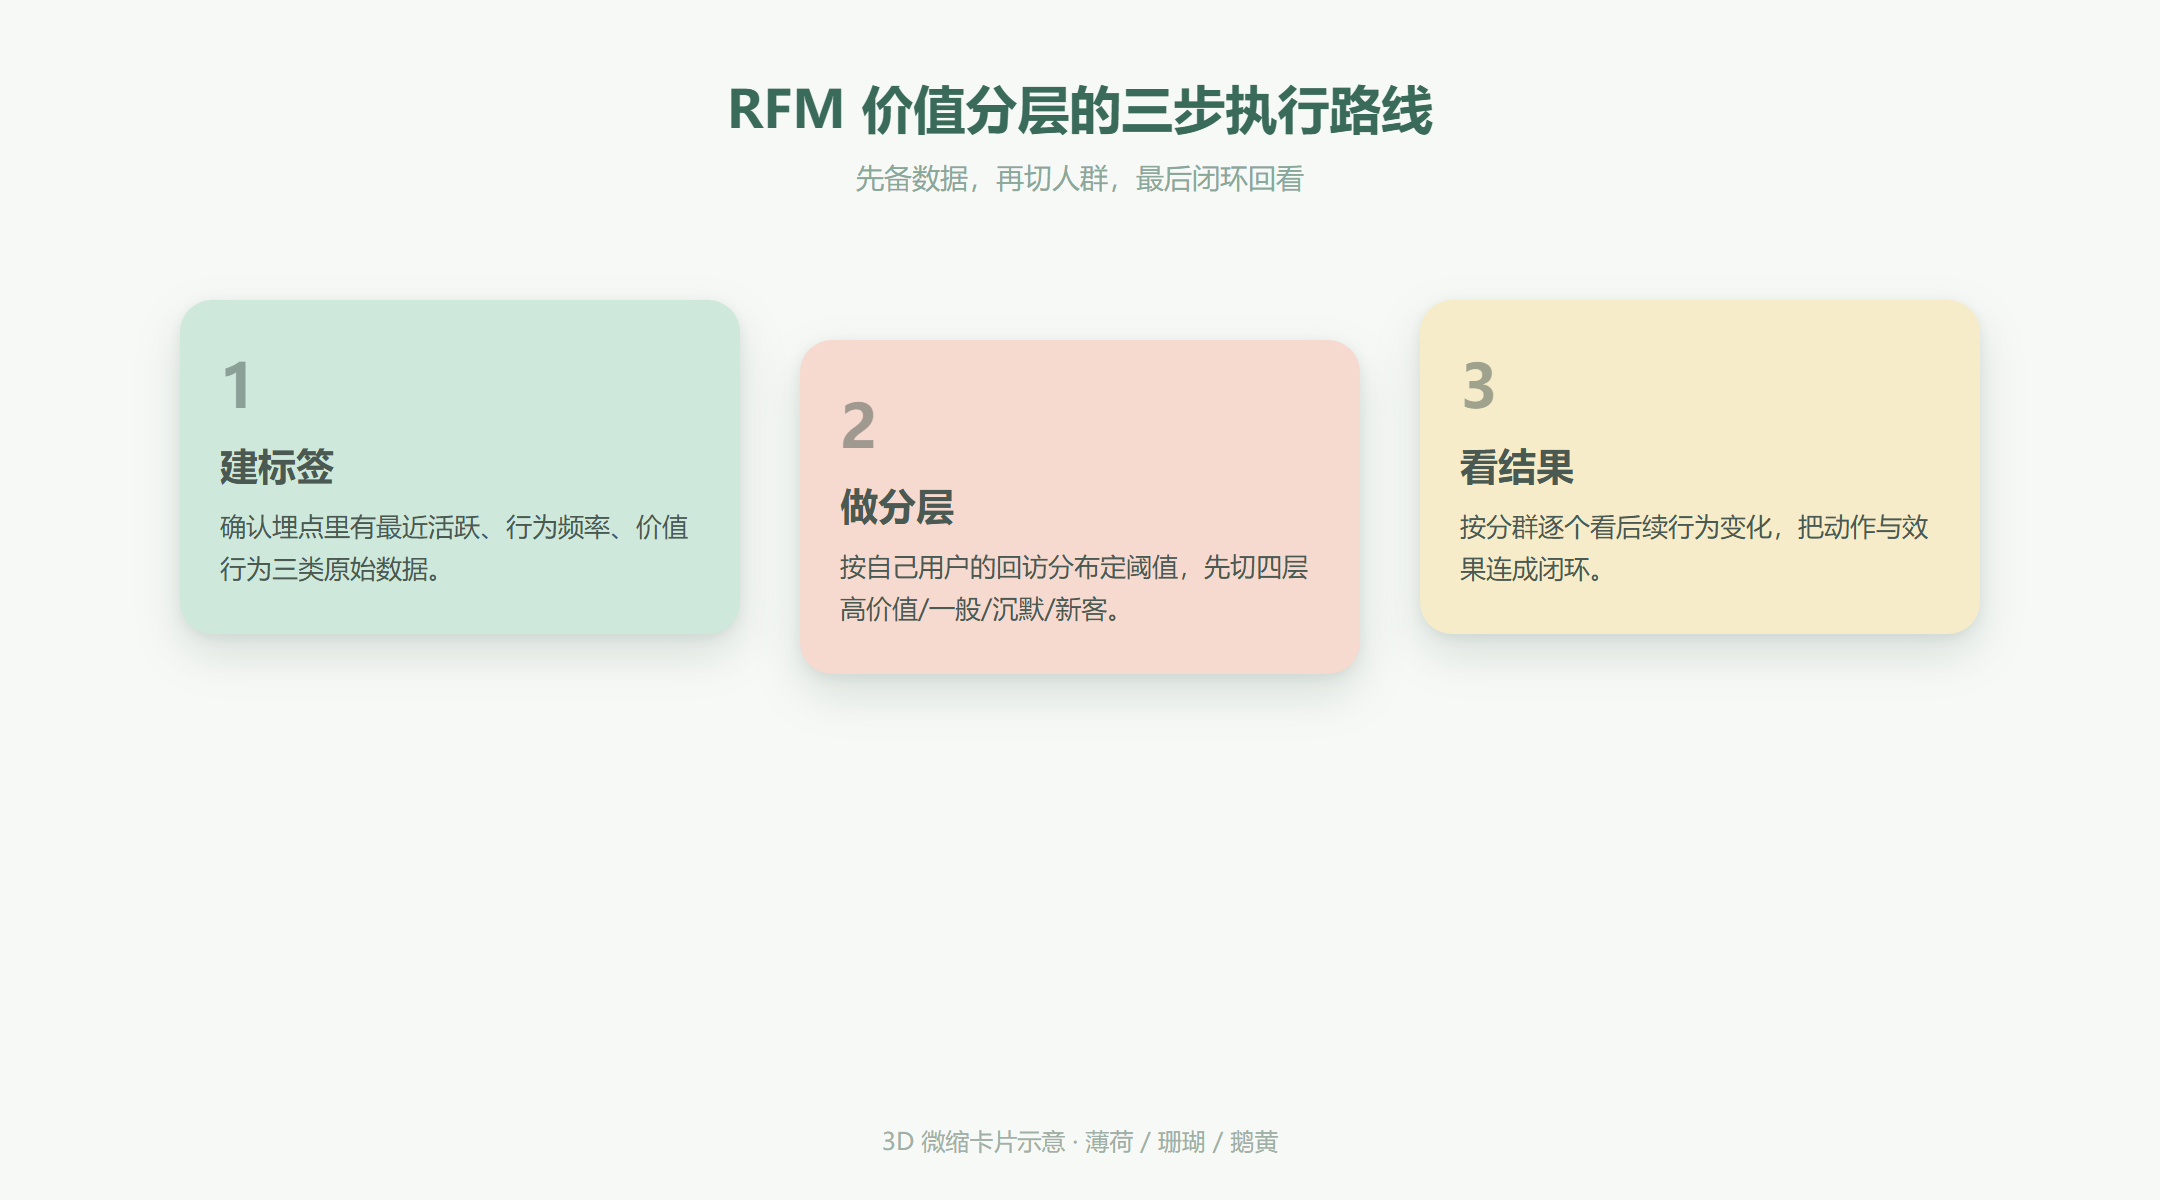
留存没有行业统一线,内部基准应基于自身数据建立。做法是先固定口径、再取一段平稳的历史数据算出分位参考带,下表为可复制的流程:
| 步骤 | 动作 | 说明 |
|---|---|---|
| 1 | 固定口径 | 统一日活跃/周活跃、第N日 vs N日内、首次访问 vs 首次注册,写入复盘模板 |
| 2 | 取基线期 | 选取无重大改版、无投放波峰的连续8~12周,按 App 端实际数据计算各注册日 cohort 的留存 |
| 3 | 算分位 | 对每周 cohort 的 D1/D7/D30 取 P25/P50/P75,作为"偏低/正常/偏高"参考带 |
| 4 | 设阈值 | 低于 P25 触发核查;高于 P75 标记为值得复盘的经验 |
| 5 | 按节奏更新 | 每季度随版本节奏重算基线;重大改版或渠道结构变化时提前重算 |
注意区分周活跃与日活跃:周活跃基线适合看大盘活跃健康度,日活跃(如次留)适合看短期体验变化,二者用途不同,不可互相替代。
三、差异从哪儿拆:版本、渠道、口径、样本
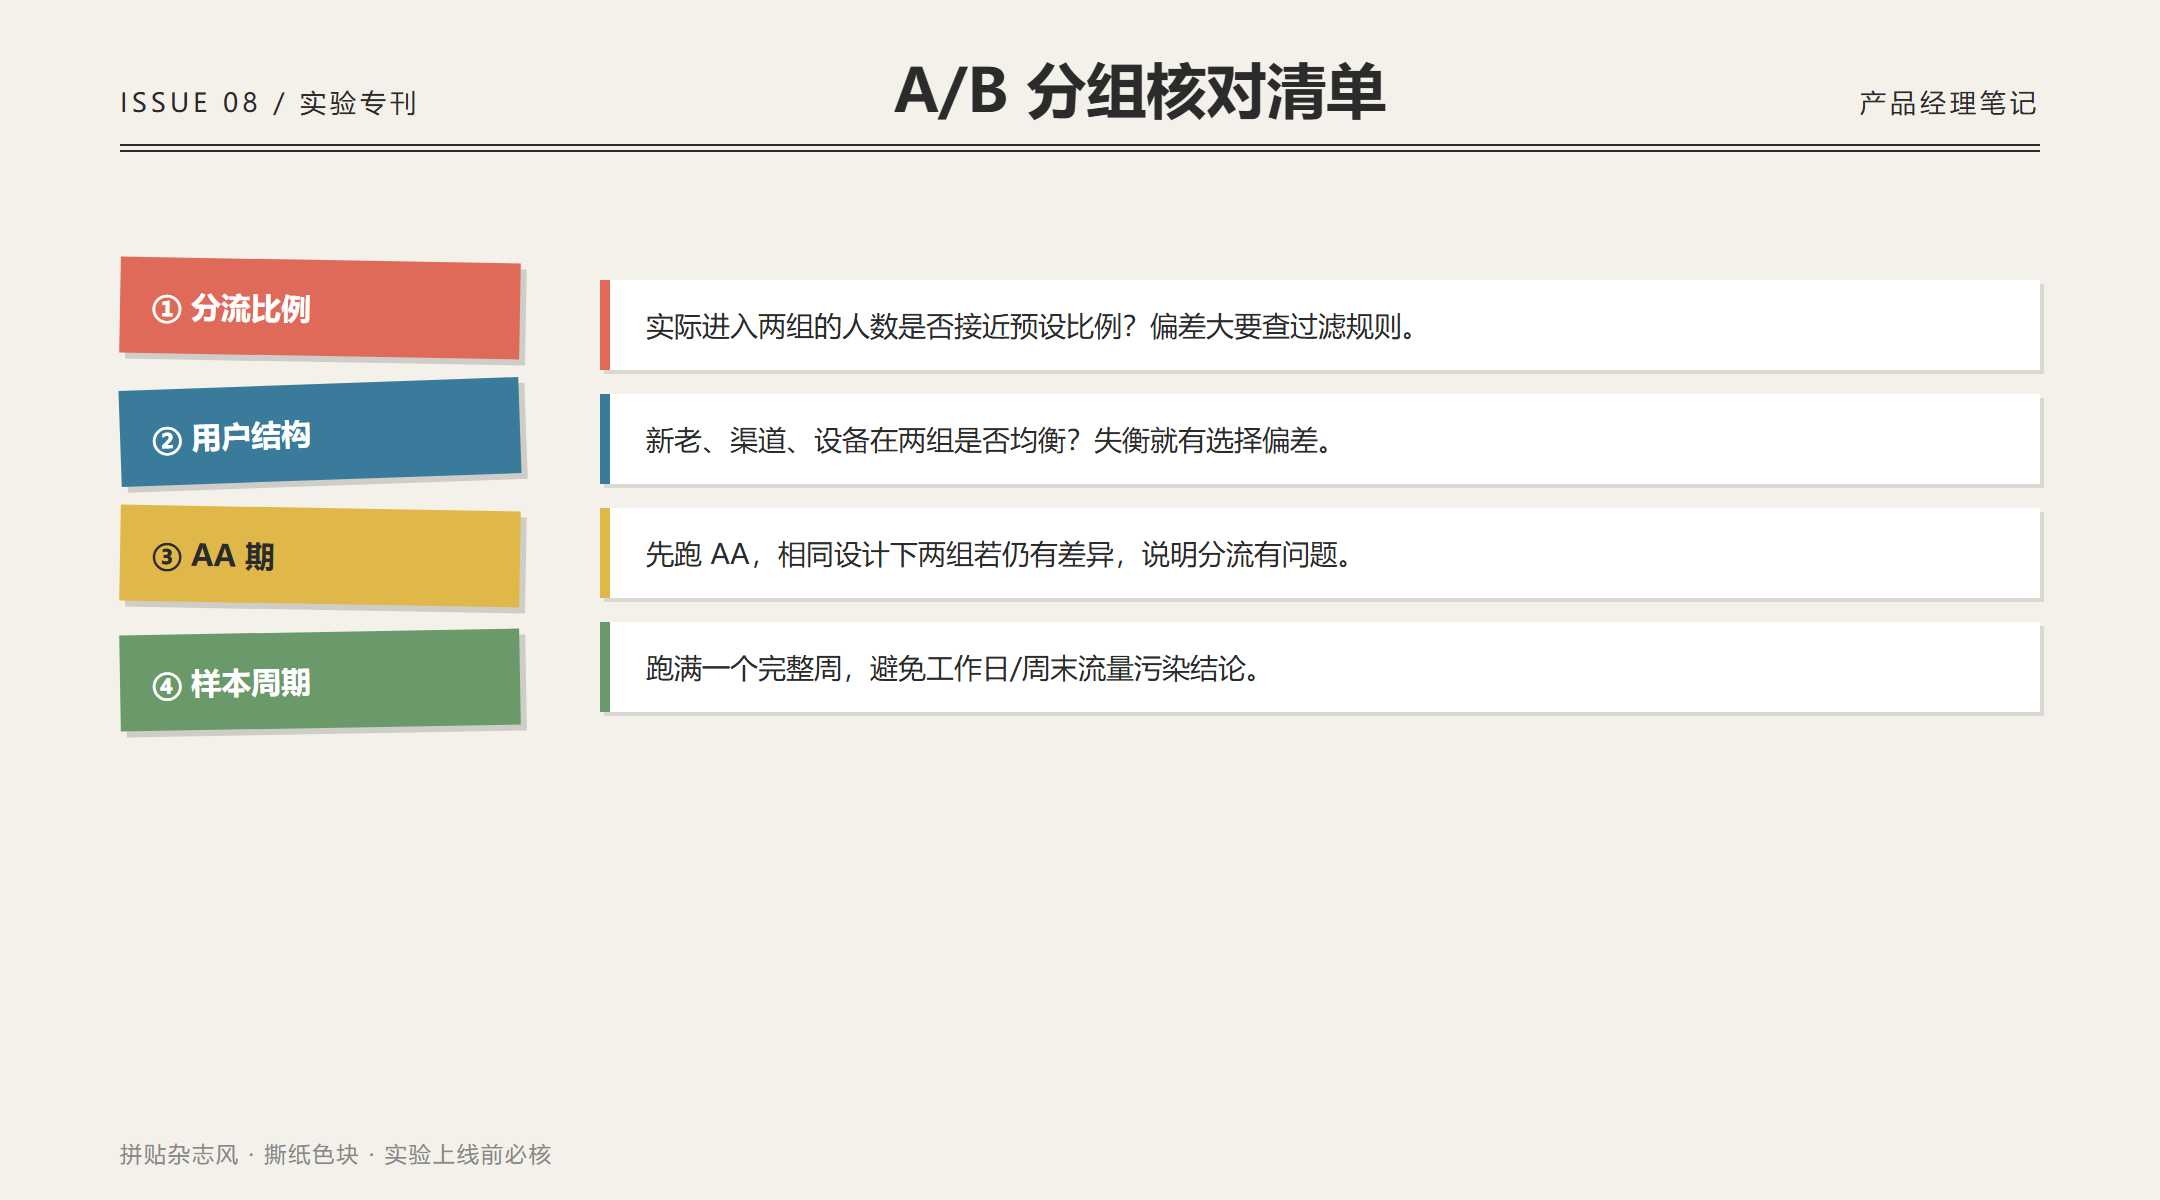
有了参考带之后,曲线偏离参考带时,再按下面四个维度逐项拆开核对,而不是盯着一个大盘留存下结论。
版本与人群:新老用户占比会拉动曲线
App端新用户口径有一个容易被忽略的细节。据官网指标口径文档(指标口径说明,最后更新2026-07-03),新用户数指"首次下载安装并激活App的设备用户;同一设备多次安装多版本,仅在首次安装版本记为新用户"。这条口径意味着,新版本灰度时进入的设备里既有真实新用户,也有从旧版本升级过来的老用户。灰度期间恰逢投放放量,新版本里新用户占比就会升高;新用户的次留天然低于老用户,曲线看起来就会"被拉低"。这不是产品退步,而是人群结构变化。
因此版本对比时要按版本号拆开看,而不是看一个大盘留存。版本分析支持按版本对比活跃与留存,渠道分析支持按来源拆分,终端分析支持按设备品牌、型号、操作系统下钻。下表把复盘时要核对的变量整理出来。
| 核对维度 | 为什么会影响留存曲线 | 在App分析中如何查看 |
|---|---|---|
| 版本号 | 不同版本覆盖的人群构成不同,新老用户占比差异会拉低或抬高曲线 | 版本分析按版本对比 |
| 渠道来源 | 买量渠道用户质量参差,低成本渠道用户意图弱 | 渠道分析拆分来源 |
| 终端设备 | 低端机型渲染与兼容性问题会放大体验差异 | 设备品牌、设备型号下钻 |
| 操作系统 | 系统版本差异影响兼容性与性能 | 操作系统维度拆分 |
| 灰度比例 | 小样本下个位数波动会让百分比剧烈摆动 | 先看绝对样本量再看比率 |
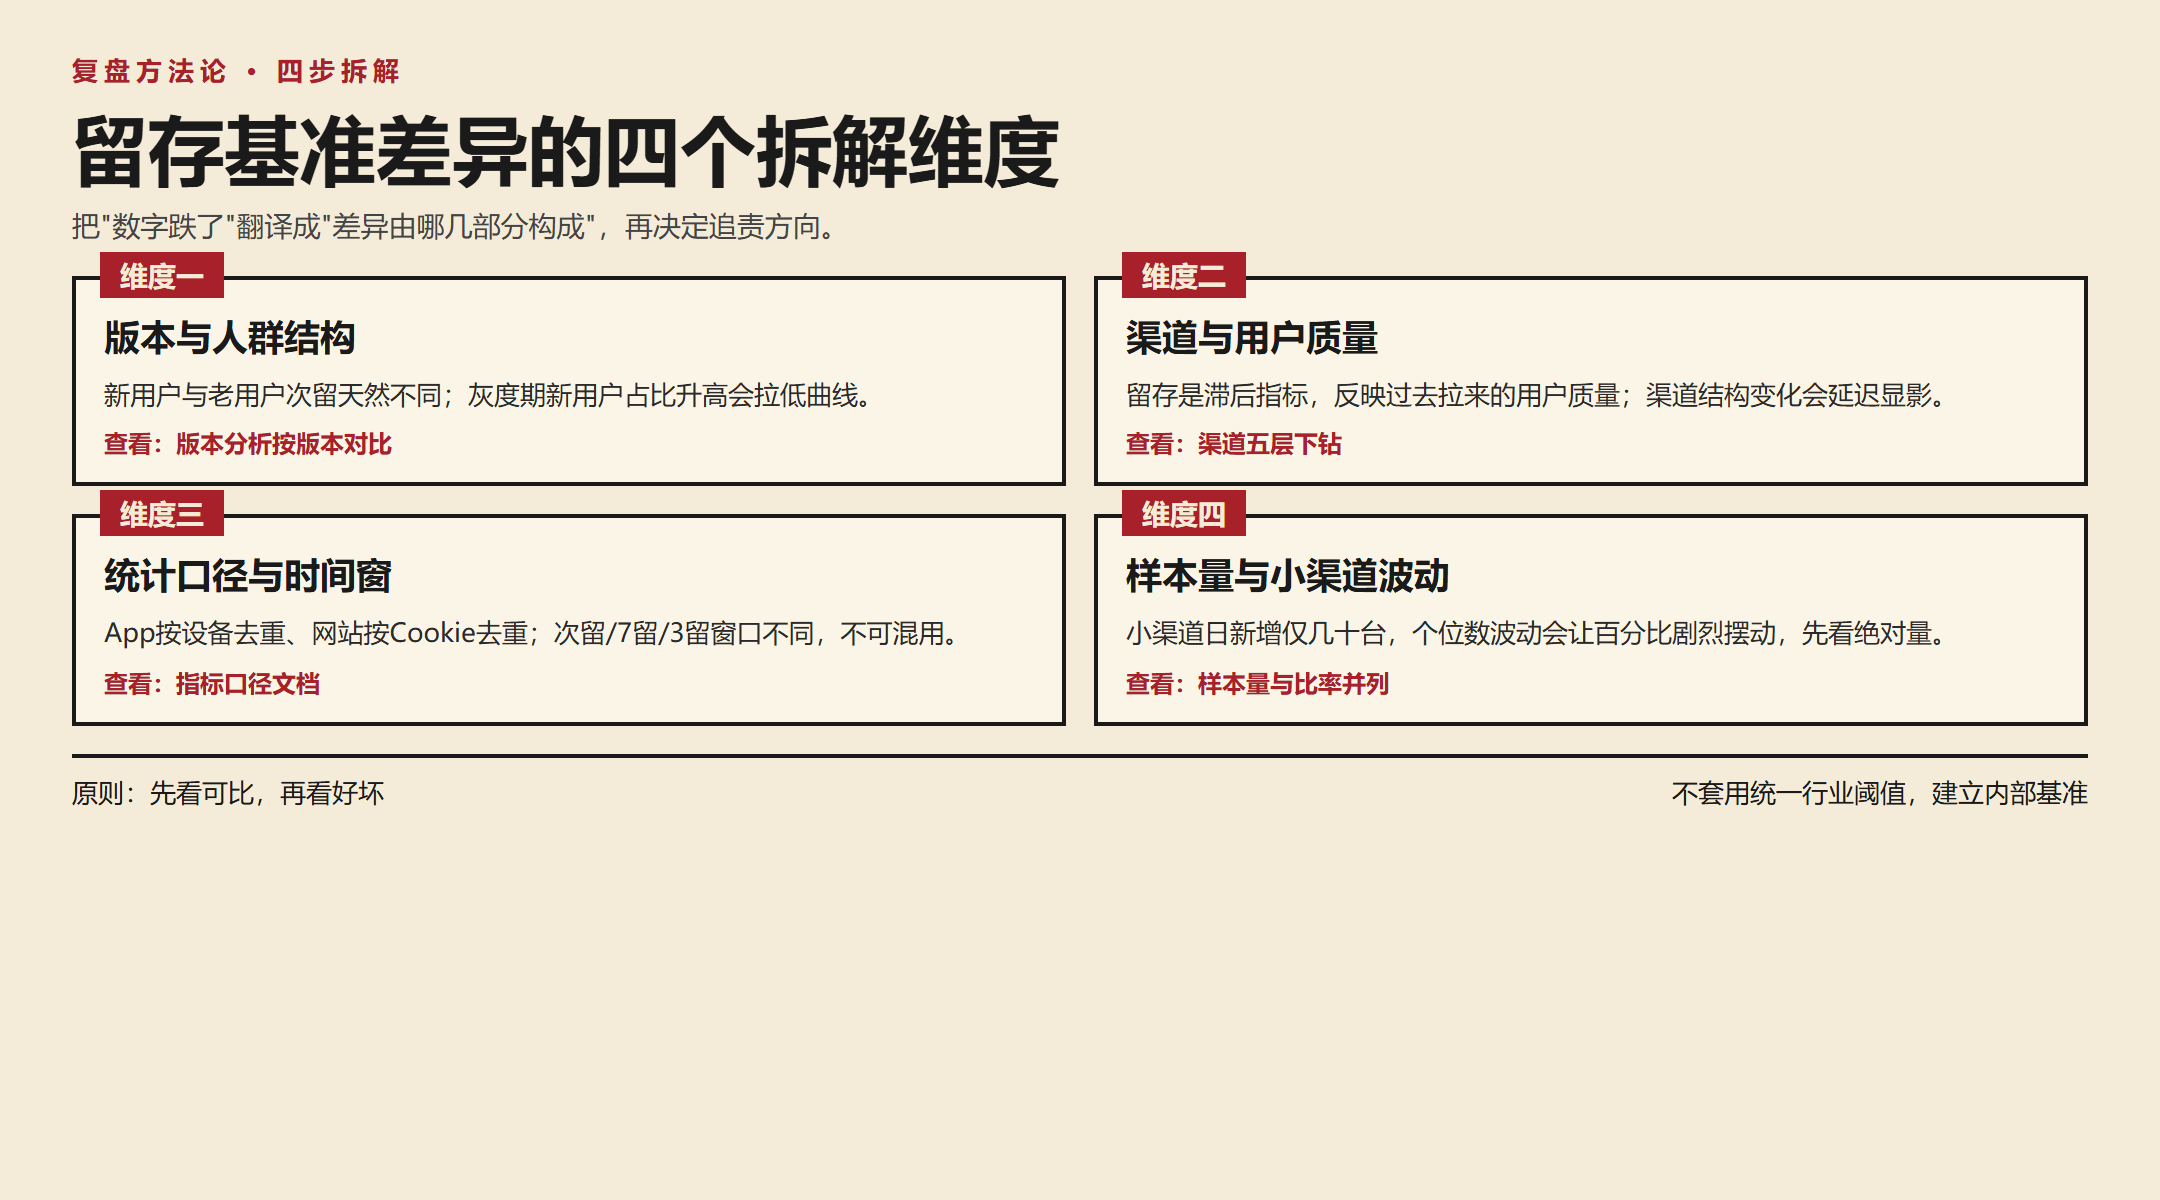
四个维度拆开看,留存差异才不会被一锅端
渠道结构:留存是两周前投放的延迟显影
留存是滞后指标,反映的是过去拉来的用户质量。渠道投放通常先于留存数据两周到一个月显现,所以当次留曲线波动时,要先回看渠道结构是否在同期发生变化。近期新增主要来自某个低成本渠道时,该渠道用户的使用意图本来就弱,留存偏低属于正常现象;把它和自然量用户放在同一条留存曲线上平均,会误判产品体验。
复盘需要的不是一个总留存数,而是按渠道拆开后的分层留存。渠道分析支持渠道、媒介、计划、单元、关键词多层拆分,可以从"整体留存"一路下钻到"某一个投放计划带来的用户是否留得住";不同计划背后的人群画像差异极大,只停留在渠道层,仍然回答不了"钱花得值不值"。
统计口径:设备去重与时间窗
App端留存与网站端留存的去重基础不同。据官网指标口径(指标口径说明),网站访客数以Cookie为依据去重,App端启动用户数按设备去重。这两套口径不能直接互相对比;同一用户在不同端的行为被分别计数,跨端汇报时若不加说明,"App留存比网站留存低"这类结论就失去意义。下表列出App端与留存复盘直接相关的指标口径。
| 指标 | 官方口径 | 复盘时的用途 |
|---|---|---|
| 启动用户数 | 一天内启动过App的独立设备用户数,按设备去重 | 判断活跃盘子大小 |
| 启动次数 | 一天内App被打开启动的总次数,一次启动指从打开到退出的完整过程 | 判断使用频次 |
| 新用户数 | 首次下载安装并激活的设备用户;同设备多次安装多版本仅在首次记新用户 | 判断灰度期新老用户占比 |
| 次均使用时长 | 用户每次打开App的平均使用时长 | 辅助判断留存质量 |
| 次留 / 7留 / 30留 | 首日新增用户在第1、第7、第30日仍回访的比例 | 版本对比须使用同一时间窗 |
比较版本还必须使用同一时间窗。次留、7日留存、30日留存的观察窗口长度不同,窗口长度本身会改变留存率的形态;用新版本的次留去比旧版本的30留,结论必然失真。复盘材料里应同时标注观察窗口与起始日期,避免跨版本、跨时期的数字被直接相减。
| 对比项 | 口径A | 口径B | 混用后果 |
|---|---|---|---|
| 活跃口径 | 日活跃(当日启动过App的设备数) | 周活跃(7天内至少启动过1次的设备数) | 周活跃数值为日活跃的数倍,直接相减无意义 |
| 留存区间 | 第N日回访(D7=第7天当天回访) | N日内回访(D7=7天内至少回访1次) | 区间口径数值明显更高,跨口径对比失真 |
| cohort 起点 | 首次访问日分组 | 首次注册日分组 | 注册日 cohort 排除了未注册访客,两者人群不同 |
复盘材料必须写明用的是哪一种口径;跨版本、跨时期对比时口径保持一致。
样本量:先看分母再看比率
小渠道的日新增可能只有几十台设备,个位数的回访波动就会让留存百分比剧烈摆动。百分比在小样本下不稳定,复盘时要先看绝对样本量、再看比率;可以要求数据组把样本量和留存率并列呈现,避免"曲线很好看但分母只有几百"。
由此引出一条边界:某渠道样本量过小时,其留存曲线不具备和大盘对比的资格。小样本波动会被误读为"渠道质量好"或"渠道质量差",进而误导下一期预算分配;正确做法是等样本积累到足够量级后再下判断,在此之前只做观察、不做结论。
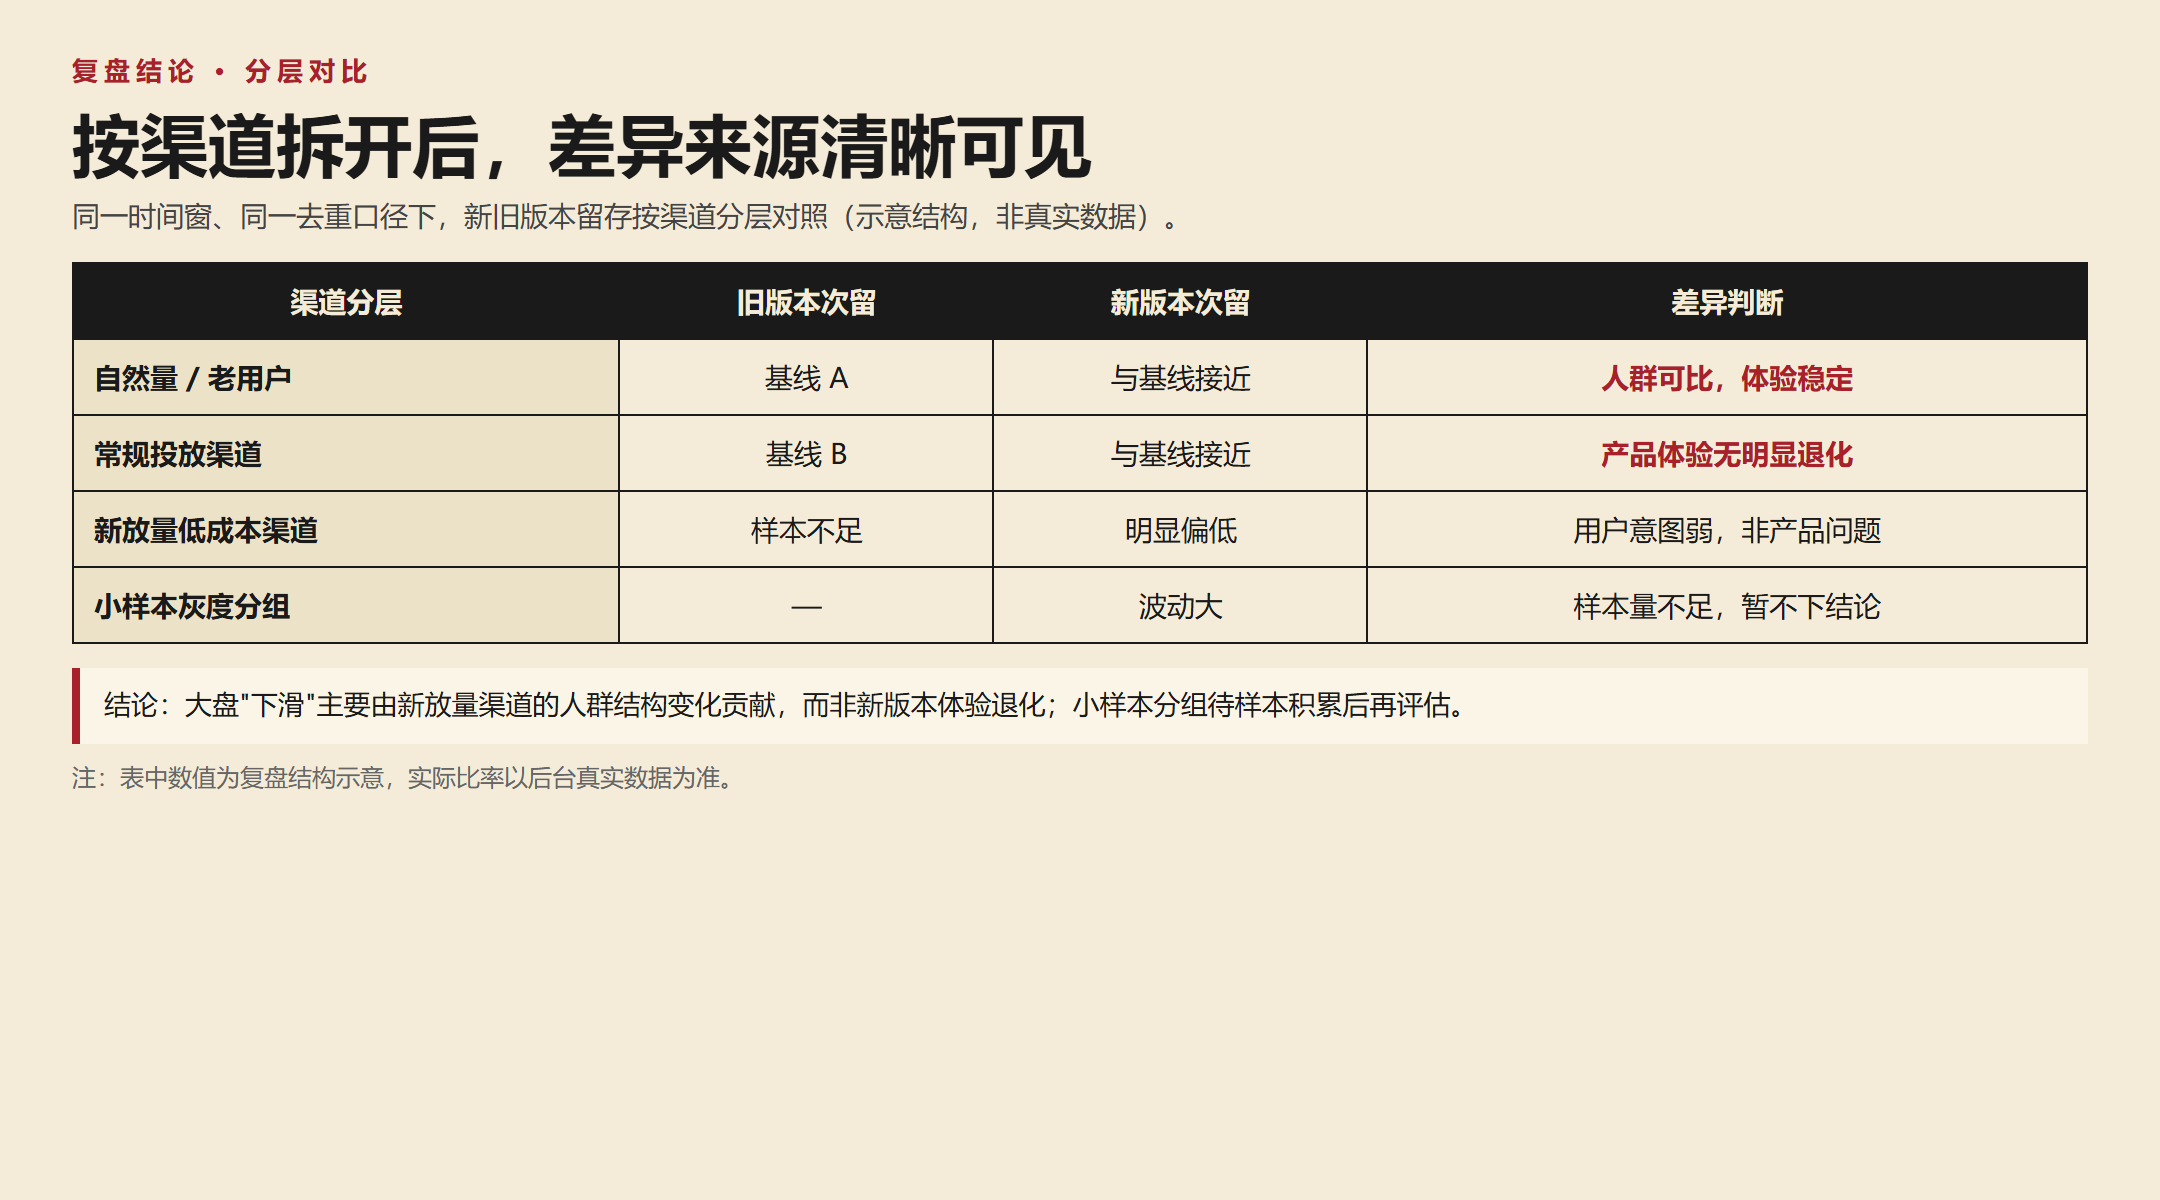
分层对比后,差异来源清晰可见
四、算例与平台边界
一个逐日 cohort 算例(示例数据)
cohort 留存的核心是"以注册日为组,观察同一批人",而不是每天换一批人。以下用 10 名新用户演示从明细到留存率的计算步骤(示例数据,不代表任何真实站点):
| 步骤 | 动作 | 结果(示例) |
|---|---|---|
| 1 | 定义 cohort:以注册日为组,取10月1日注册的10名新用户 | cohort 人数=10 |
| 2 | 逐日核对同一批人:10月2日(D1)有4人回访 | D1=4/10=40% |
| 3 | 10月8日(D7)有2人回访 | D7=2/10=20% |
| 4 | 10月31日(D30)有1人回访 | D30=1/10=10% |
| 5 | 横向比较:与9月24日、9月25日注册的 cohort 用同口径对比 | 形成留存曲线,再判断差异是否真实 |
两个容易出错的地方:一是把后来新增的用户混入同一 cohort——cohort 人数一旦增加,比率就不再代表同一批人;二是注册日 cohort 与首次访问日 cohort 是不同人群,必须先约定用哪一个。
平台能帮上什么,边界在哪
做这类留存复盘,需要版本对比、渠道拆分、设备下钻这几件事在同一个平台完成,而不是分别导出三份报表再手工对齐。选择平台时,可先核对三件事:是否覆盖你所用的端(网站/App/小程序)、版本分析与渠道拆分是否可用、留存 cohort 等高级分析能力在哪个档位开放——具体以所选工具官网定价对比表与后台功能清单为准(核验日期2026-10-09)。把业务数据与性能数据放在同一处的平台,还有助于区分"用户不想用"和"页面打不开"这两类性质完全不同的问题。
工具选择上,常见分析工具大致分三类:基础流量统计类以百度统计、51LA为代表,主要回答"有多少人来、从哪里来";深度行为分析类以神策数据、GrowingIO为代表,回答"用户来了之后做了什么、为什么流失";多端整合类以友盟+为代表,强调把网站、App、小程序放进同一看板。这些工具之间更多是"能力侧重不同",而不是简单的替代关系;具体选择仍应结合业务需求、数据规模、团队能力和预算判断。
落到复盘节奏上,建议先用自身8~12周历史数据划出 P25/P50/P75 参考带,再拿新版本曲线对照,而不是拿一个外部数字当及格线。这套办法仍有两点没有解决:一是内部基线只在样本量足够时才稳,新渠道、新市场冷启动期 cohort 太小,参考带本身不可信;二是跨公司的行业对标基准库官方未公开,"行业次留水平"目前无法从平台直接获取,跨公司对比只能靠团队自行收集样本(待补充资料)。