前端性能监控:如何区分路由切换与首屏体验
先看一个演示场景(不指向任何真实工单或客服记录):假设看板上的首屏加载时长看起来正常,客服却收到用户反馈说"点了菜单要等好几秒页面才出来"。这种对不上的原因在于,首屏指标记录的是用户第一次打开站点的那一段旅程,而用户抱怨的其实是进入站点之后的路由切换。前端性能监控如果只盯着首屏,就会漏掉后半段体验。下面按一次首屏性能核查的推进顺序展开——先对齐首屏口径,再看核查过程,然后是 SPA 路由这一常见盲区,最后交代工具能承接什么、仍有哪些未决问题。
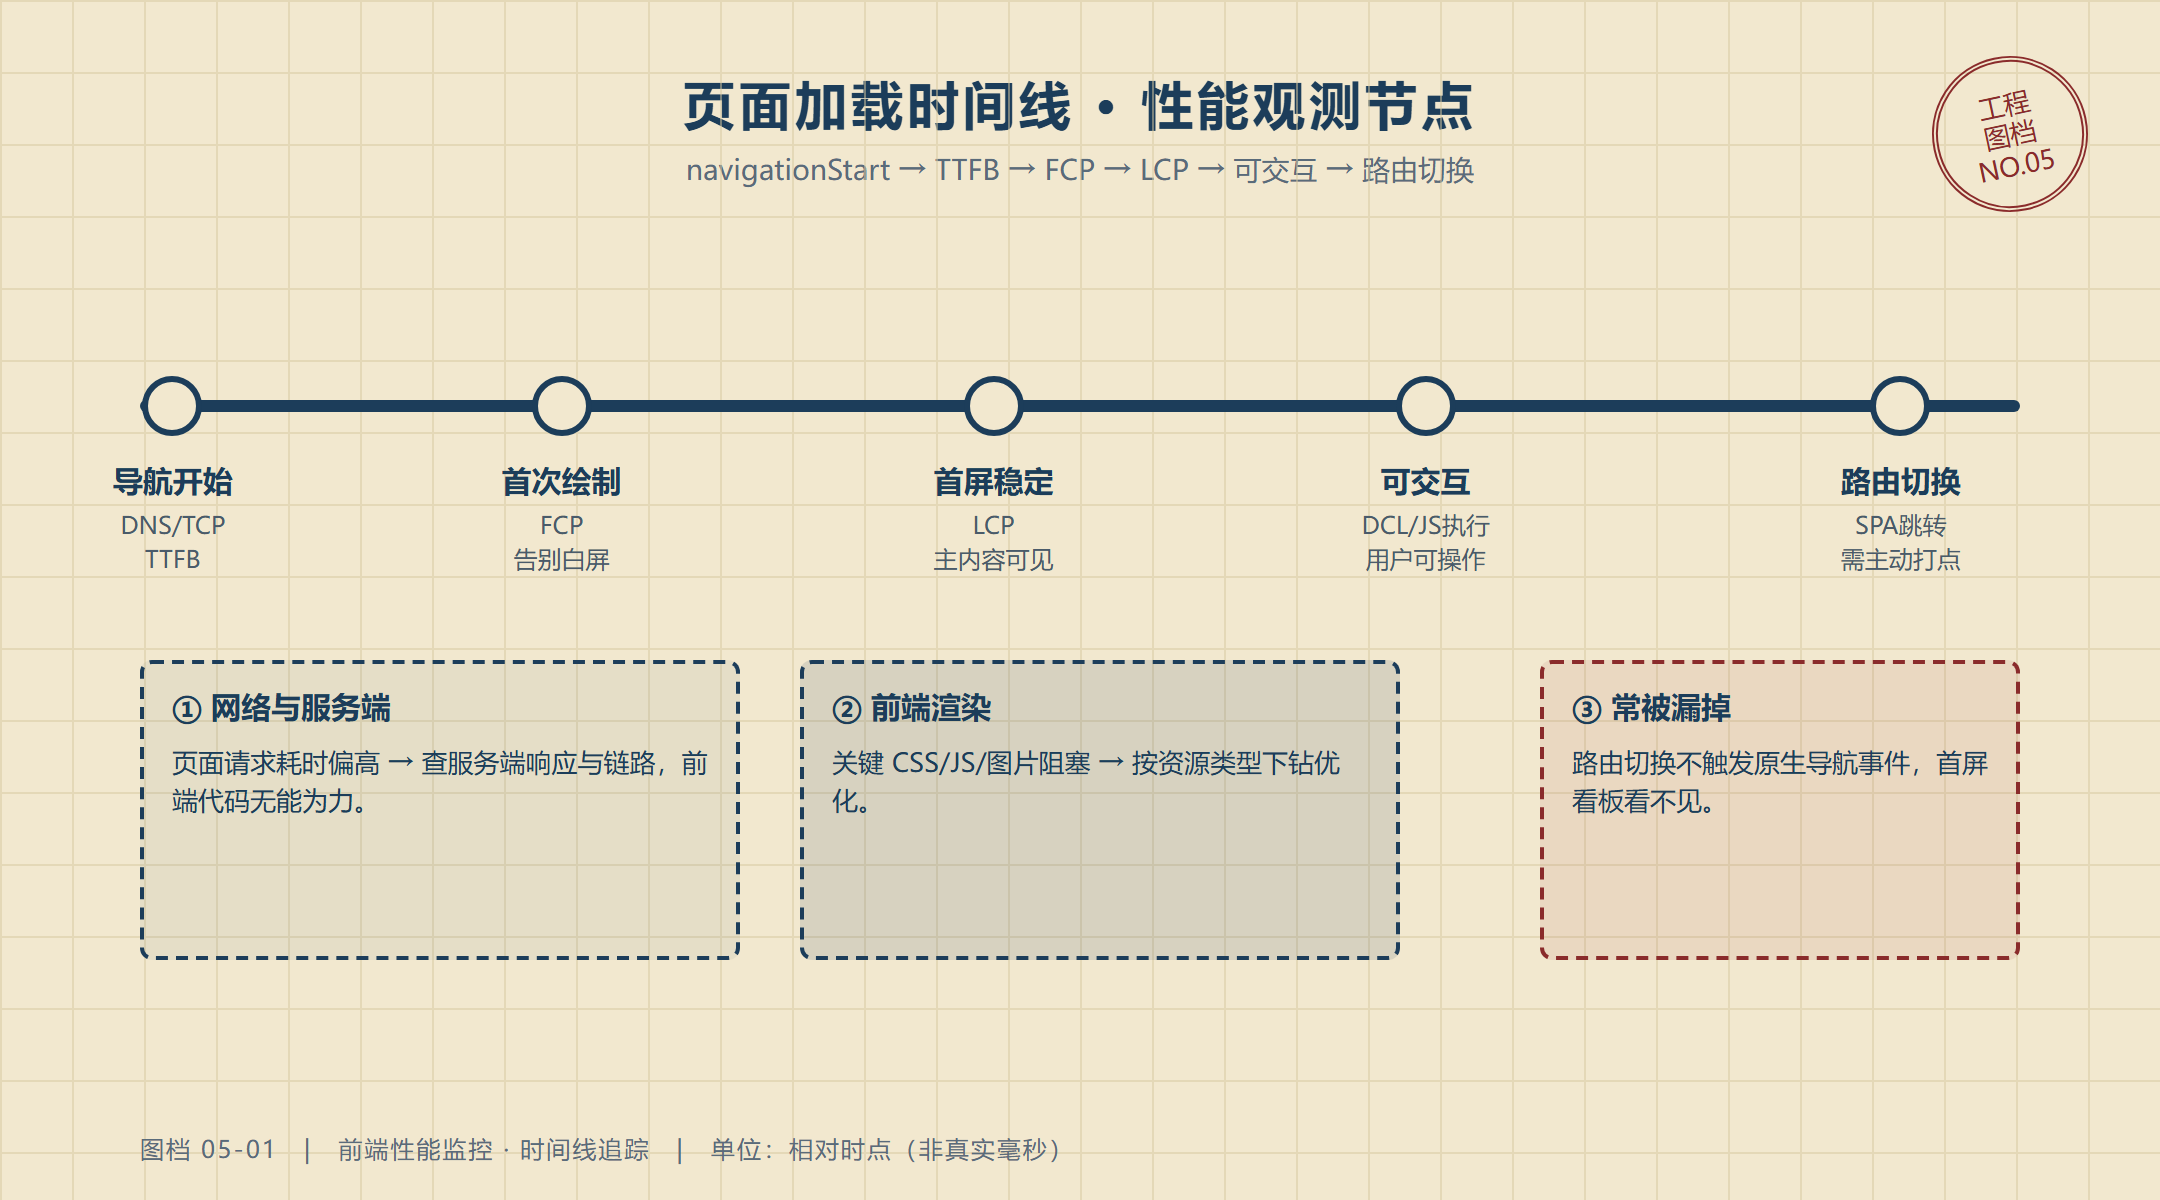
图:一次页面访问从导航开始到可交互的关键时间节点
导航开始到 TTFB:第一段延迟往往不在前端
TTFB 偏高,问题通常不在前端代码
时间线的起点是浏览器发起导航。用户输入网址或点击链接之后,浏览器要先完成 DNS 查询、建立 TCP 连接、再等待服务器返回第一个字节,这一段对应的指标是 TTFB(Time to First Byte)。这一段耗时主要取决于网络链路与服务端响应速度,因此 TTFB 偏高时,问题通常不在前端代码,而在服务端接口或机房网络。前端工程师在这一段能做的事有限,但必须先把它和后续的前端渲染时间分开记账,否则会把服务端慢误判成页面慢。
把页面请求与 API 请求分开记账
在这一段,监控工具需要记录的是页面请求本身的耗时分布。页面请求慢指向文档加载,API 请求慢指向数据接口,二者的优化方向完全不同,因此应按请求类型分别核对。Web 端埋点代码贴进 head 标签后即可开始采集(以所选工具接入文档为准)。所选工具是否将"页面请求"与"API 请求"作为独立观测入口、入口如何分组,需以登录后后台与官方文档确认(待后台/文档确认),未公开前不展开;若使用的工具未区分这两类请求,则应按通用监控设计建议,在打点数据中自行给请求加上类型标签。
| 时间线阶段 | 对应观测点 | 偏高时优先排查方向 |
|---|---|---|
| 导航开始 → TTFB | 页面请求耗时、DNS 与连接耗时 | 服务端响应、网络链路 |
| TTFB → 首次绘制 | FCP、HTML 文档下载 | 文档体积、缓存策略 |
| 首次绘制 → 首屏稳定 | LCP、关键资源加载 | 首屏图片、CSS 阻塞 |
| 首屏稳定 → 可交互 | DCL、JS 执行、长任务 | 脚本体积、主线程阻塞 |
| 可交互之后 | JS 异常、API 异常、路由切换耗时 | 代码错误、接口性能 |
首屏绘制:FCP 与 LCP 回答的是两个问题
FCP 与 LCP 衡量的不是同一个视觉节点
文档返回之后,浏览器开始解析 HTML、请求 CSS 与 JS、绘制第一帧。FCP(First Contentful Paint,首次内容绘制)记录的是浏览器第一次把任何内容绘制到屏幕上的时间,它回答的是"用户多久看到不是白屏"。而 LCP(Largest Contentful Paint,最大内容绘制)记录的是首屏内最大元素完成绘制的时间,它回答的是"用户多久看到主要内容"。两个指标衡量的是不同的视觉节点,因此 FCP 正常但 LCP 偏长是常见现象——用户看到了导航栏,却还在等主图加载。
术语注:DCL(DOMContentLoaded)指浏览器完成 HTML 文档的 DOM 解析,不代表资源全部加载完毕;FCP、LCP 只描述"内容可见",都不等同于"页面完全可用"——页面是否可交互,还要看脚本是否执行完、主线程有没有被长任务阻塞。观测时不要把"首屏绘制完成"当成"用户已可用"的信号。
按资源类型下钻找首屏瓶颈
资源加载分析在这一段尤其关键。CSS 会阻塞渲染、JS 会阻塞解析,首屏图片过大则直接拉长 LCP。性能监控后台把 img、js、css、link 等资源分类列出,你可以按资源类型下钻,找出到底是哪一类资源在拖慢首屏。按类型分的原因在于:优化图片和优化脚本的手段完全不同——图片走压缩与懒加载,脚本走拆分与延迟执行。
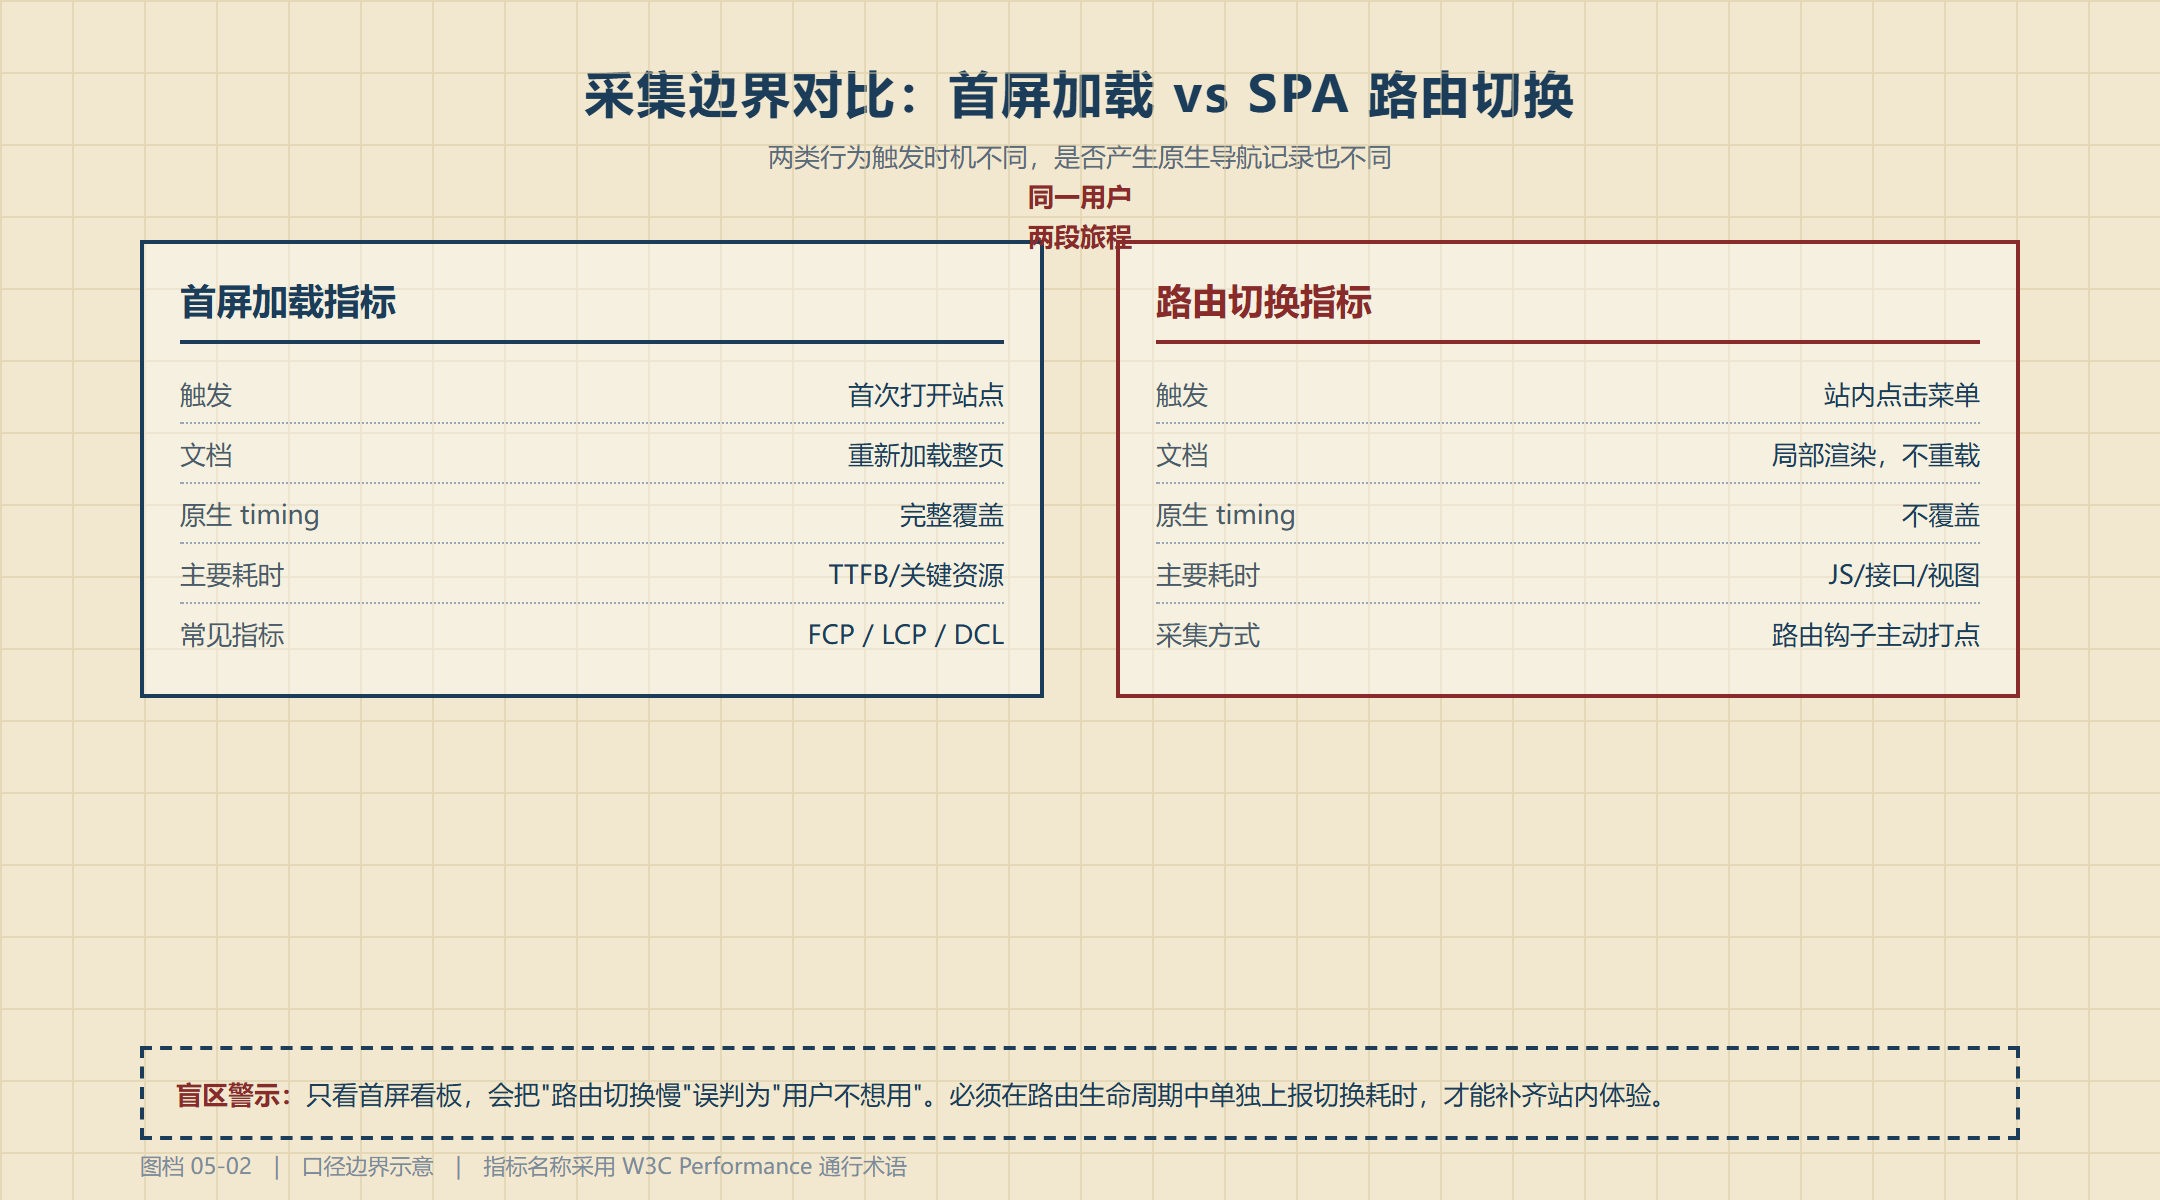
图:首屏加载指标与 SPA 路由切换指标的采集边界对比
可交互之后:JS 异常与 API 请求才是后半段
首屏正常,不代表后半段体验没问题
首屏绘制完成并不等于体验结束。用户开始点击、输入、切换菜单时,页面还要执行 JS、请求数据。这一段如果出错,用户看到的是"点了没反应"或"转圈不动",但首屏指标完全正常。因此前端性能监控必须覆盖 JS 错误追踪与 API 异常监控,把运行时错误和接口慢请求单独列出来。异常监控与性能监控需要放在一起看:一个报错的接口既会被当成性能问题,也会被当成稳定性问题,分开看会反复扯皮。
用维度下钻,找出被平均值藏起来的用户
异常出现之后,下一步是缩小范围。性能问题往往只发生在特定网络、特定浏览器或特定地区,因此监控工具需要支持按终端设备、操作系统、浏览器、运营商和地域下钻。如果只看全站平均值,你可能看到一个并不刺眼的数字,却忽略了某一类网络环境下大量用户正在经历的超时。平均值会把最差的那一批用户藏起来,而真正流失的恰恰是他们,下钻维度因此不可省略。
从监控设计上看,把页面体验、资源体验、JS 异常与 API 请求放在同一个后台下钻,前端可以沿着时间线从异常定位到对应请求,而不必在两个系统之间复制粘贴时间戳。所选工具前端体验分析的具体分组(是否按页面体验、资源体验、访客体验、异常分析组织)与跨环节联动能力,以官方文档与后台实测为准(待后台/文档确认),未公开的不展开。打通的价值在于:转化下降时,你需要第一时间判断它到底是业务问题还是页面打不开。
路由切换:为什么 navigation timing 抓不到它
SPA 切换不会触发原生导航事件
这是最容易被忽略的一段。现代站点大量采用 SPA(单页应用)架构,用户点击菜单时,前端通过 history.pushState 切换路由,并不会重新加载整个文档。浏览器只在首次加载时触发完整的 navigation timing,后续的路由切换因此不会产生新的导航记录。如果你只看首屏指标,就会误以为"所有页面都很快",而用户在站内跳转时的等待完全没有被记录。
要观测路由切换,必须在路由变化时单独打点,记录切换开始到新视图渲染完成的耗时。这就要求监控工具能区分"首次进入站点"和"站内路由跳转"两类行为。这件事难做,原因在于路由切换的触发时机分散在前端框架的生命周期里,需要 SDK 在路由钩子中主动上报,而不是依赖浏览器原生的导航事件。
路由性能也要在同类页面之间比较
还要提醒一点,路由切换耗时本身不是越短越好。不同页面的数据请求量天然不同,一个要加载大量图表的报表页,路由切换自然比一个静态详情页慢。因此比较路由性能时,同样要在同类页面之间比,而不是全站一个数排名,避免把"页面本来就重"误判成"性能退化",把优化精力用错方向。
| 对比项 | 首屏加载指标 | 路由切换指标 |
|---|---|---|
| 触发时机 | 用户首次打开站点 | 站内点击菜单/链接 |
| 是否重新加载文档 | 是 | 否(SPA 局部渲染) |
| 原生 navigation timing | 覆盖 | 不覆盖,需主动打点 |
| 主要耗时来源 | 文档、关键资源、TTFB | JS 执行、数据请求、视图渲染 |
| 看板中的常见盲区 | — | 只看首屏会漏掉这一段 |
SPA 路由指标的最小打点方案
在 SPA 中观测路由切换,最小方案是在路由钩子里记录下面这组字段,并配合"采样+去重"控制上报量:
| 字段 | 含义 | 触发时机 |
|---|---|---|
| route_start | 路由开始时间 | 点击菜单/链接,路由即将切换时 |
| first_content | 首个内容可见 | 新视图第一个节点渲染完成 |
| data_complete | 数据请求完成 | 该路由依赖的接口全部返回 |
| interactive | 可交互 | 事件绑定与核心脚本执行完成 |
| error_count | 错误数 | 切换过程中出现 JS 异常或接口失败 |
| 采样与去重 | 控制上报量 | 按百分比采样;同一会话内对同一路由只记一次 |
路由打点伪代码如下(示意,具体以所选框架的路由生命周期为准):
router.beforeEach((to) => {
  const t = { route_start: performance.now() };
  // 新视图渲染完成后再补 first_content / data_complete / interactive 并上报
  trackRouteMetric(to.path, t, { sampled: Math.random() < 0.1, dedup: sessionKey + ':' + to.path });
});
需要明确的是:Navigation Timing 只覆盖浏览器原生导航(首次加载与整页刷新),不会自动覆盖 SPA 的虚拟路由;凡是依赖 history.pushState 的站内跳转,都必须由上面这类主动打点补齐。
一个误报案例:路由切换被误当成首屏回归
一个典型的误报场景(演示,用于说明口径风险):某团队改版后收到性能告警,称"首屏 LCP 恶化"。核对打点数据后发现,告警来自一批站内路由切换样本——新版把页面入口改成了 SPA 内跳转,用户不再触发整页加载,这些样本本不该进入首屏统计。把"路由切换"与"首屏加载"两类样本分开统计后,告警消失,真实的首屏指标并无回归。这个案例说明:口径混用会直接制造误报,在设计打点时就要把两类行为分开。
工具能力与限制
把首屏和路由切换放在同一条时间线上看,性能监控的价值在于把"用户不想用"和"页面打不开"区分开:如果转化下降是因为路由切换时接口超时,那是性能问题;如果路由很快但用户就是不点,那是业务问题。具体工具的性能监控档位、入口、分组与接口规格,以所选工具官网定价页、产品页和官方文档为准,未公开的不做展开(待后台/文档确认;相关产品能力与档位核验日期:2026-10-09)。
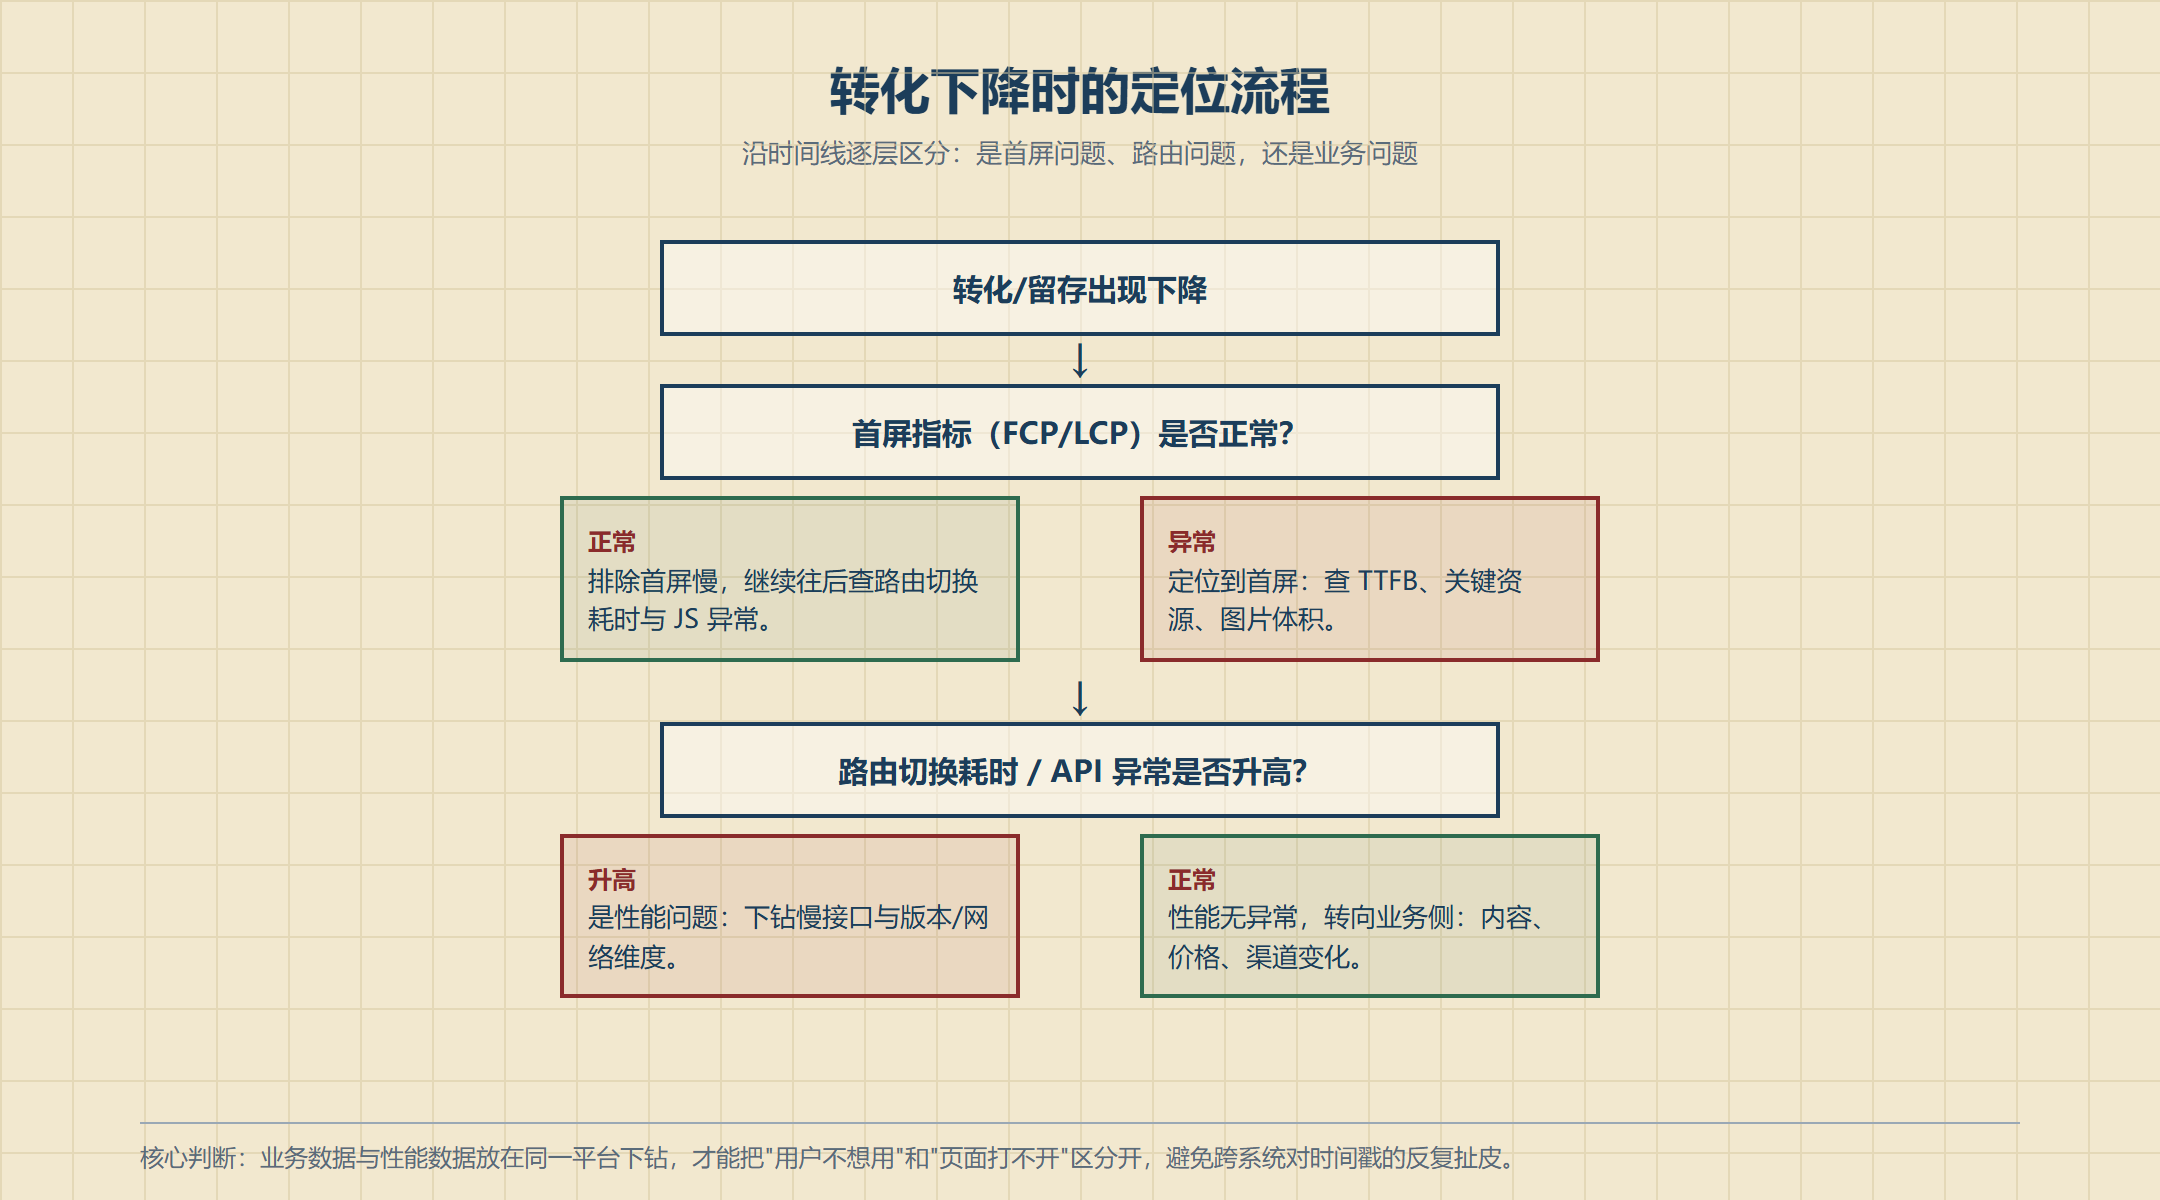
图:转化下降时如何沿时间线定位是首屏问题还是路由问题
回到开头那个演示场景:只要在路由钩子中把"站内跳转"单独打点,客服反馈的"点菜单等好几秒"就不会再被首屏指标遮住。落地建议是先按本文的时间线把 TTFB、FCP/LCP、路由切换三段口径分开记账,再结合团队实际需要评估是否引入对应的性能监控能力。这套做法仍有两个未决问题:一是路由切换的耗时阈值没有统一标准,报表页与静态页不能共用一条红线,具体分档阈值需要团队用自己的同类页面分布回测,本文不提供数值,也不引用任何官网界面演示读数;二是文中"页面请求/API 请求分入口""按页面体验/资源体验/异常分析分组"等产品能力描述,目前只能以登录后台与官方文档为准,缺少可公开引用的产品页段落作支撑,已列入待补充资料。