网站用户停留时间如何统计与分析
简单说,456数据为网站、App和小程序提供一体化分析,数据分析、用户行为洞察、性能监控统一在一个后台,停留时长则是最容易被误读的指标之一。你有没有盯着报表里的平均停留时间发过呆:这个数字到底是怎么算出来的?为什么有的页面停留时间特别短,有的又长得离谱?作为前端工程师,我被问到最多的问题之一就是:停留时间长是不是代表用户喜欢我的内容?答案没那么简单。在456数据的后台里,停留时间的计算有明确的技术机制,也有几个天然算不准的盲区。这篇文章从前端实现的角度,把停留时间怎么算、哪里算不准、分析时容易踩什么坑,一步步讲清楚,帮你看到数字背后的技术逻辑。
先给一个反直觉的判断:停留时间长不一定意味着体验好。一个页面让用户迷路了、找了半天没找到想要的东西,停留时间也会很长。反过来,用户一秒就找到了答案然后离开,停留时间很短但体验很好。所以停留时间只是一个中性的计时数据,好坏要结合页面目标来判断,不能单独拿它当质量评分。
停留时间是怎么算出来的
要理解停留时间的局限,先得知道它在技术上是怎么计算的。大部分网站统计工具的做法,和你想象的可能不太一样。它不是在用户离开页面时立刻记一笔,而是靠页面之间的跳转来反推。
页面进入和离开时间戳
当用户打开一个页面时,统计代码会记录一个进入时间戳。当用户在站内跳转到下一个页面时,统计代码会记录一个离开时间戳。这两个时间戳之间的差,就是用户在当前页面的停留时间。注意:这个离开时间戳不是靠监听用户关闭页面来的,而是靠用户触发下一次页面浏览时才产生的。这是理解停留时间所有局限的技术起点。
相邻事件时间差
换句话说,页面停留时间的计算方式是:下一个页面的进入时间,减去当前页面的进入时间。如果用户在A页停留了三分钟然后跳到B页,A页的停留时间就是三分钟。这个计算依赖的是两个相邻页面浏览事件之间的时间差,而不是精确监听用户什么时候关掉了当前页。它能做的是估算,不是秒级精确测量。理解这一点,后面的所有分析都有了正确的预期。
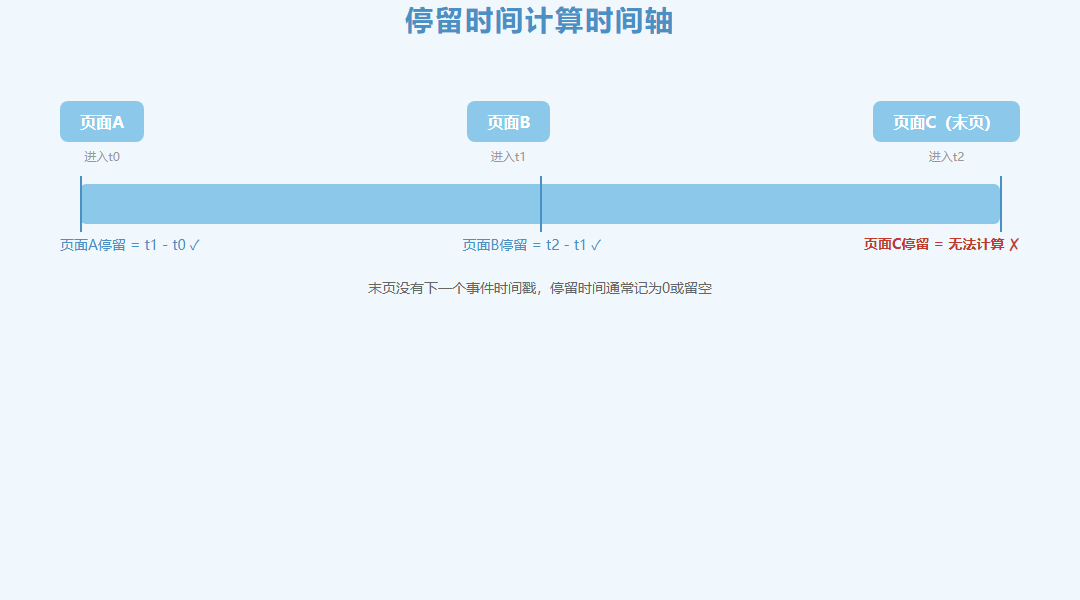
停留时间靠相邻页面事件时差计算,不是实时监听用户关页。
为什么最后一个页面算不准
这是停留时间统计里最大的技术盲区,也是最容易导致误判的地方。很多运营同事不知道这个机制,看到文章页平均停留时间只有几十秒,就以为内容没吸引力,其实可能是大量用户读完直接关闭,那次根本没被计时。
末页没有下一次跳转事件
按上面的计算方式,最后一个被浏览的页面没有「下一个页面的进入时间」可以用来做差。统计工具不知道用户在最后这个页面待了多久——他可能看了一秒就关了,也可能读了半小时。因为没有下一次页面事件来标记离开时间,这个末页的停留时间通常被记为零或者不纳入平均计算。这是所有基于页面事件时差的统计工具共有的局限,不是某个平台的实现缺陷。
这对数据意味着什么
这意味着平均停留时间天然偏低,尤其对那些末页就是长文章的网站。用户在文章页读了十分钟然后直接关闭,这次访问里文章页的停留时间是算不出来的。你看到的平均停留时间,其实主要是那些中途跳转的页面贡献的。分析停留时间时,要把末页和中间页分开看,不要把所有页面的停留时间混在一起算平均。
后台切换和页面切换的影响
用户在浏览过程中切到别的标签页去查资料,过了十分钟才切回来继续看。统计工具不知道用户切走了,它只记录两次页面事件的时间差,所以这十分钟空白时间也被算进了停留时间。浏览器最小化、电脑锁屏、接了个电话,都会产生同样的偏差。停留时间测的是「页面开了多久」,不是「用户真正在看多久」。要区分这两者,需要结合滚动深度和点击事件等互动信号。
| 场景 | 能否准确计时 | 偏差原因 | 影响哪个指标 |
|---|---|---|---|
| 中间页跳转 | 较准确 | 两次页面事件时间差 | 页面停留时间 |
| 最后一个页面 | 无法准确计算 | 无下一次跳转事件 | 平均停留时间被拉低 |
| 切后台标签页 | 偏大 | 空白时间被计入 | 访问时长虚高 |
| 直接关窗离开 | 无法计算 | 没有离开事件上报 | 末页时长缺失 |
怎么结合其他数据理解停留时间
既然停留时间本身有偏差,分析时就不能只盯着这一个数字。把它和其他维度的数据放在一起看,才能得出合理判断。单看一个平均停留时间,你既不知道这个数字准不准,也不知道它是好是坏。
结合页面类型看
博客文章页的停留时间应该比首页长,产品列表页的停留时间应该比确认订单页长。先建立不同页面类型的合理预期,再看某个页面是否偏离了同类页面的正常区间。不要拿首页的停留时间去和文章页比,就像不能拿短跑成绩和马拉松成绩比一样。每个页面有它自己的时间尺度。
结合访问来源看
从搜索来的用户如果带着明确问题,找到答案就走,停留时间短是正常的。从社交媒体来的用户可能只是随便逛逛,停留时间长也不代表转化好。按来源拆停留时间,能看出不同渠道用户的浏览深度差异。如果某个渠道停留时间很短但转化率很高,说明来的都是精准用户,不需要担心时间短。
结合浏览深度和目标完成看
停留时间长加上浏览了多个页面,说明用户确实在深入浏览。停留时间长但只看了一个页面就走了,可能是迷路了或者页面太复杂。停留时间短但完成了目标操作,说明效率高。把停留时间和浏览深度、目标完成率交叉看,才能判断时间长是好事还是坏事。单一指标永远不够下结论。
| 页面类型 | 合理停留区间 | 偏短说明 | 偏长说明 |
|---|---|---|---|
| 博客文章页 | 视文章长度定 | 内容没抓住注意力 | 可能内容太散需精简 |
| 产品详情页 | 几十秒到几分钟 | 信息不够促使用户走 | 用户在犹豫或找信息 |
| 首页 | 通常较短 | 导航清晰直达目标 | 用户迷路没找到方向 |
| 表单页 | 视填写复杂度 | 填写顺畅 | 字段太多或有歧义 |
停留时间误判排查流程
当你觉得停留时间数据有问题时,按以下步骤排查,而不是直接下结论。这三步从技术口径出发,逐步过渡到业务判断。
第一步:确认统计口径
先查你的统计工具是怎么算停留时间的:是不是用相邻页面事件时差、末页记为零还是不计入、有没有考虑有效互动时长。口径不同,数字没有可比性。如果你换过统计工具,换工具前后的停留时间不要直接连起来比,因为计算方式可能已经变了。
第二步:排查场景偏差
看看你的网站有多少访问是单页访问(PV=1的会话)。这类访问的末页停留时间算不出来,如果占比很高,平均停留时间天然偏低。再看看有没有大量移动端用户——移动端切后台更频繁,时长虚高更明显。
把这两个比例算出来,你就知道你的平均停留时间数据有多少水分,再决定要不要拿这个数字去做产品决策。
第三步:结合页面目标判断
最后回到页面本身:这个页面的目标是什么?是让用户快速找到信息就走,还是让用户深入阅读?停留时间长短是否服务于这个目标?想清楚这一点,就不会看到数字就慌。比如一个FAQ页面,用户停留时间越短说明找答案越快,这是好事不是坏事。
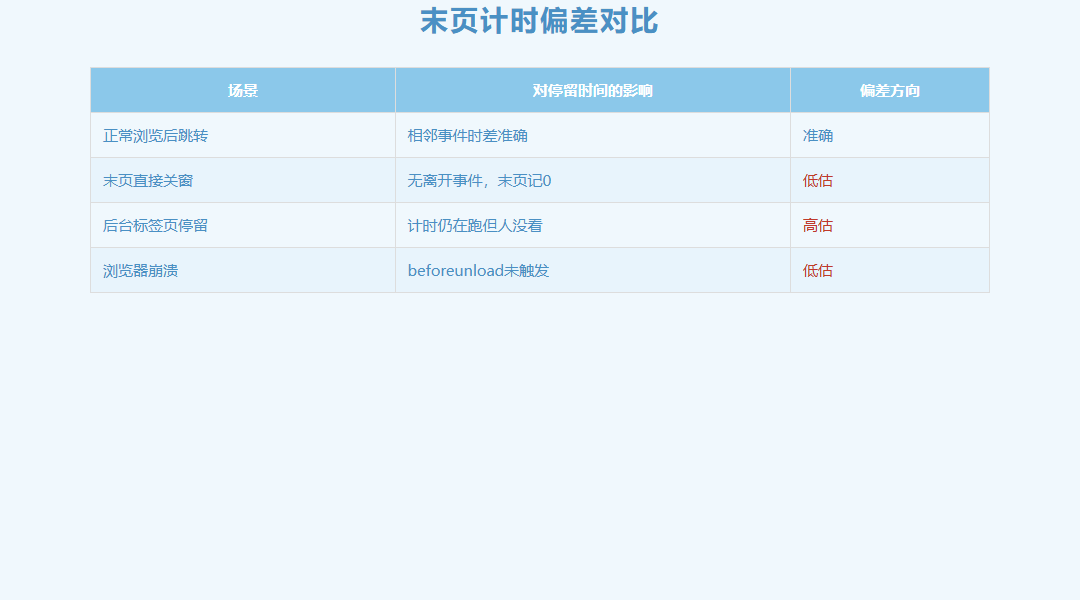
四种场景对停留时间的影响不同,分析时要先知道偏差来自哪里。
| 排查项 | 检查动作 | 失败分支 | 复核标准 |
|---|---|---|---|
| 口径确认 | 查工具停留时间计算公式 | 若末页不计入,平均值偏低是正常的 | 口径一致后再跨页面比较 |
| 末页占比 | 看单页访问会话占比 | 占比过高时平均值代表性差 | 至少中间页数据占一半以上 |
| 设备拆分 | 移动端vs桌面端分开看 | 移动端切后台更频繁时长虚高 | 同设备类型内比较时长 |
| 目标对齐 | 明确每个页面的预期目标 | 脱离目标谈时长长短无意义 | 写明该页是快进型还是深读型 |
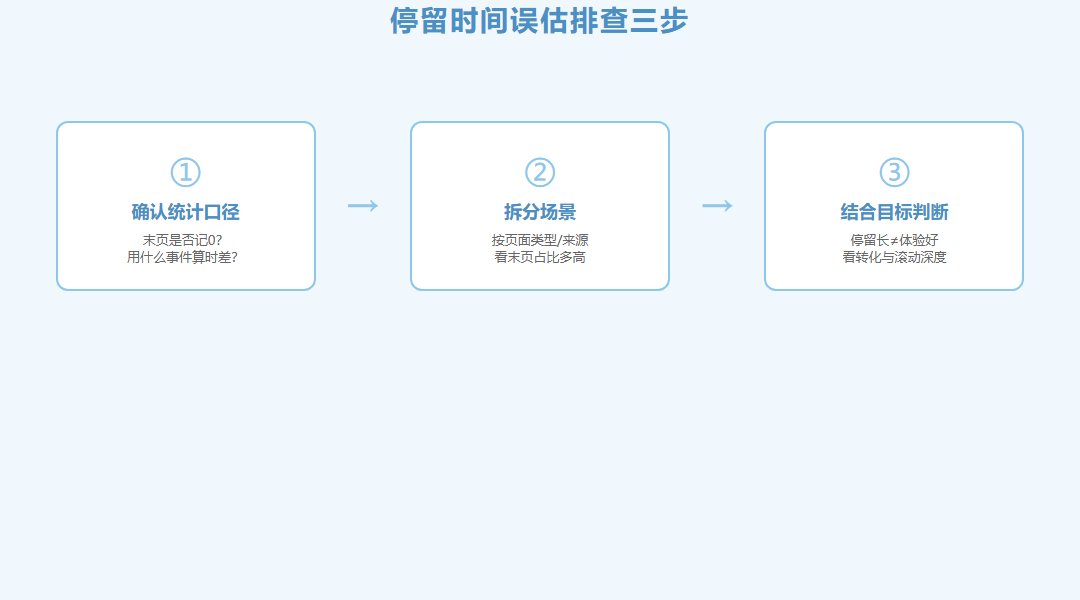
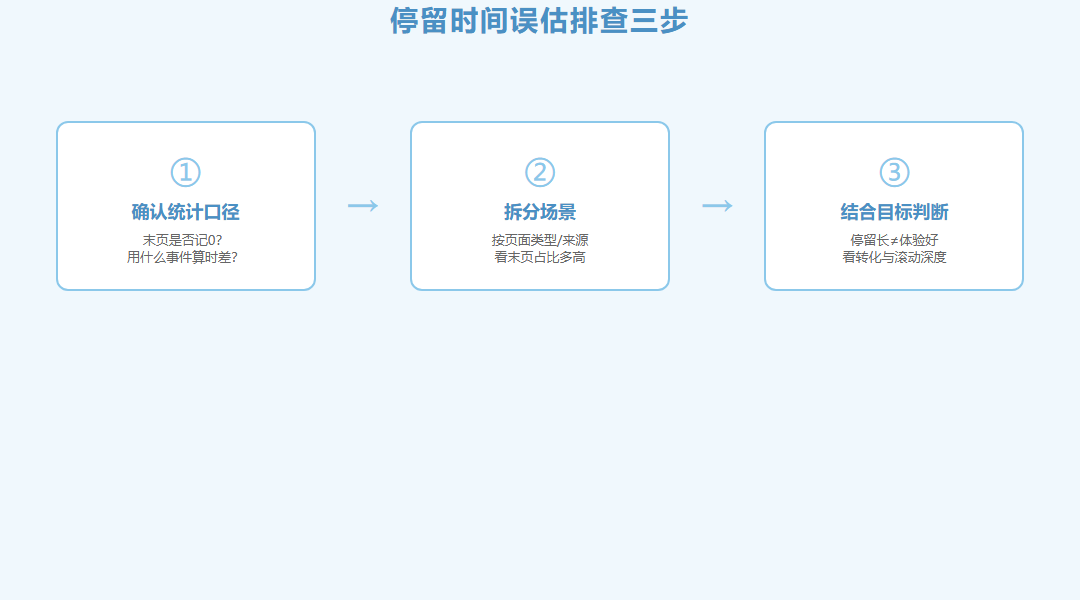
按三步排查,避免把技术局限误读成用户体验问题。
网站停留时间是一个有技术天花板的指标。它能告诉你用户大概在页面上花了多久,但无法精确到秒,也无法区分「真的在看」和「开着页面切走了」。理解这些局限之后,你就能用这个数据做合理的判断,而不是被数字牵着走。记住:停留时间是参考信号,不是质量分数。它告诉你的是时间长度,不是用户满意度。这一点务必分清。
如果你正在对着平均停留时间数据纠结用户到底喜不喜欢?不妨先看看你的统计口径和单页访问占比,也许问题不在内容,而在计算方式。把末页盲区和设备偏差搞清楚之后,这个数字才真正有用,否则这只是一个看起来精确其实有偏差的估算值而已。
时长分析工具的试用重点也很明确:中间页与末页时长是否分开算、能否按设备类型拆分、有没有滚动深度作为有效互动的补充信号。456数据在这几项上都可以逐项核对,它们决定你能不能避开末页盲区,而不是被一个偏低的平均值误导。
参考资料
- 开发文档页,支撑停留时长等指标的采集与计算说明。
- 网站分析产品页,支撑按设备与页面维度拆分时长的功能介绍。
- MDN beforeunload 事件,支撑浏览器页面卸载与离开事件的技术参考。
- W3C 技术标准目录,支撑Web页面生命周期与计时器相关标准的权威定义。