归因模型怎么选?先看你的转化周期
渠道预算复盘会上,投放说搜索渠道贡献了60%转化,内容说自然流量才是主力,两边用的都是同一份数据,结论却相反。问题出在归因模型:不同模型把功劳分配给不同渠道。这篇把归因模型的选择逻辑讲清楚。
一、归因模型是什么
1.1 归因的定义
归因指把一次转化(下单、注册、付费)的功劳,按规则分配给转化路径上的各个渠道触点。因为用户从首次接触到最终转化,中间可能经过搜索、广告、内容、直接访问等多个触点,所以"功劳归谁"需要一套规则来裁定。归因模型就是这套规则。理解归因模型,先理解"触点"这个概念:用户每次与渠道的接触都是一个触点。
1.2 为什么归因结论会打架
归因结论打架的根源是模型不同:末次点击归因把功劳全给转化前的最后一个触点,首次点击归因把功劳全给第一个触点,两者得出的"主力渠道"可能完全不同。因为每种归因模型回答的问题不同(末次点击回答"临门一脚是谁",首次点击回答"谁把用户带进来"),所以用错模型,结论自然打架。这不是数据问题,是规则问题。
1.3 归因回答什么问题
归因模型回答三个问题:哪个渠道真正驱动转化、预算应该往哪投、不同渠道扮演什么角色。因为投放预算的分配依赖归因结论,所以归因模型的选择直接影响真金白银的投放决策,不是纯理论问题。把归因模型选对,预算分配才有依据。
1.4 归因与转化周期的关系
归因模型的选择与转化周期强相关:转化路径短(一两个触点),简单模型就够;转化路径长(五六个触点),需要多触点模型。因为路径越长,触点越多,功劳分配越复杂,所以选择归因模型前先画出自己的转化路径,路径长度决定模型复杂度。
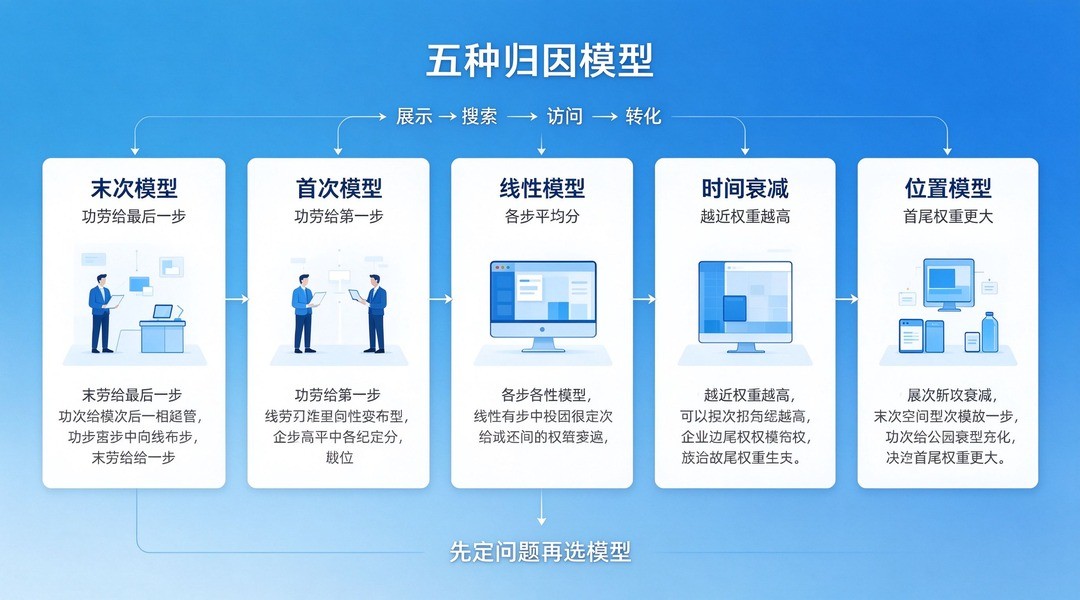
图1 五种归因模型看什么的概念与结构示意
二、五种归因模型看什么
2.1 末次点击归因
末次点击归因把全部转化功劳给转化前的最后一个触点。因为末次点击模型简单直观、口径统一,所以它是最常用的默认模型,适合转化路径短、决策快的业务。它的局限是忽视前期触点:用户可能被内容种草后,通过搜索关键词下单,功劳全给了搜索,内容的贡献被抹掉。选择归因模型时,末次点击是默认起点。
2.2 首次点击归因
首次点击归因把全部功劳给用户第一次触达的渠道。因为它回答"谁把用户带进来"的问题,所以适合评估拉新渠道(广告、内容、社交)的贡献。它的局限是忽视后期的转化推动:首次触达渠道获得了所有功劳,但真正促成转化的是后续触点。评估拉新效果时,首次点击归因最合适。
2.3 线性归因
线性归因把功劳平均分配给路径上的所有触点。因为它不偏袒任何位置,所以适合触点数量中等、各环节都重要的业务。它的局限是平均分配不等于真实贡献,高频触点可能被高估或低估。线性归因是"不预设立场"的选择,适合还没有明确判断的业务。
2.4 时间衰减归因
时间衰减归因按触点距转化的时间分配权重:越接近转化的触点权重越高。因为它符合"临门一脚更重要"的直觉,所以适合转化路径较长的业务。它的局限是衰减系数需要业务校准,系数不同结论不同。选择时间衰减归因时,把衰减速度作为参数调优项。
2.5 位置归因
位置归因给首次触点与末次触点较高权重,中间触点分享剩余权重。因为它兼顾"引入"与"促成"两端,所以适合同时重视拉新与转化的业务。它的局限是权重分配带有主观设定,需要业务团队认可。位置归因是"折中方案",适合首尾都重要的业务。
2.6 五模型对照表
下表汇总五种归因模型的逻辑与适用场景:
| 模型 | 功劳分配 | 适用场景 | 主要局限 |
|---|---|---|---|
| 末次点击 | 全部给末次触点 | 短决策路径 | 忽视前期触点 |
| 首次点击 | 全部给首次触点 | 拉新评估 | 忽视转化推动 |
| 线性 | 平均分配 | 触点均衡 | 平均不等于真实 |
| 时间衰减 | 按时间加权 | 长转化路径 | 系数需校准 |
| 位置 | 首末高权重 | 拉新+转化并重 | 权重偏主观 |
因为五种模型的结论可能完全不同,所以选择归因模型前先明确要回答的问题,再选模型。
三、怎么做:一次归因选择的四步
3.1 第一步:判断转化周期
选择归因模型的第一步,是判断业务的转化周期:用户从首次接触到转化通常经过几天、几个触点。因为转化周期决定路径复杂度(短周期一两个触点、长周期五六个触点),所以先画出典型的用户转化路径,再选择模型。路径图可以手工画:把用户从首次触达到转化的每一步列出来。
3.2 第二步:明确要回答的问题
第二步明确问题:评估拉新用首次点击,评估成交用末次点击,评估整体贡献用线性或位置。因为模型与问题一一对应,所以先写下"这笔预算要回答什么",再选归因模型,顺序不能反。预算问题的类型,直接决定归因模型的选择。
3.3 第三步:多模型对比验证
第三步用多个模型跑同一份数据,对比结论差异。因为单一模型的结论可能失真,多模型对比能看到"结论是否依赖模型",所以预算决策前至少跑末次点击与线性两种模型,差异大时说明路径复杂,需要进一步分析。归因模型的选择,用对比代替拍脑袋。
3.4 第四步:固定口径持续追踪
第四步固定模型与口径,持续追踪趋势。因为归因口径一旦频繁更换,历史数据不可比,所以选定归因模型后至少稳定一个季度,再根据业务变化评估是否调整。稳定的口径,是归因分析积累趋势的前提。
3.5 归因结论的使用纪律
归因结论的使用要守住一条纪律:只用于分配方向,不用于精确核算。因为归因是规则性分配,不是真实贡献的精确测量,所以预算决策看"相对权重"而不是"绝对数值"。归因模型给出方向,业务判断给最终答案。
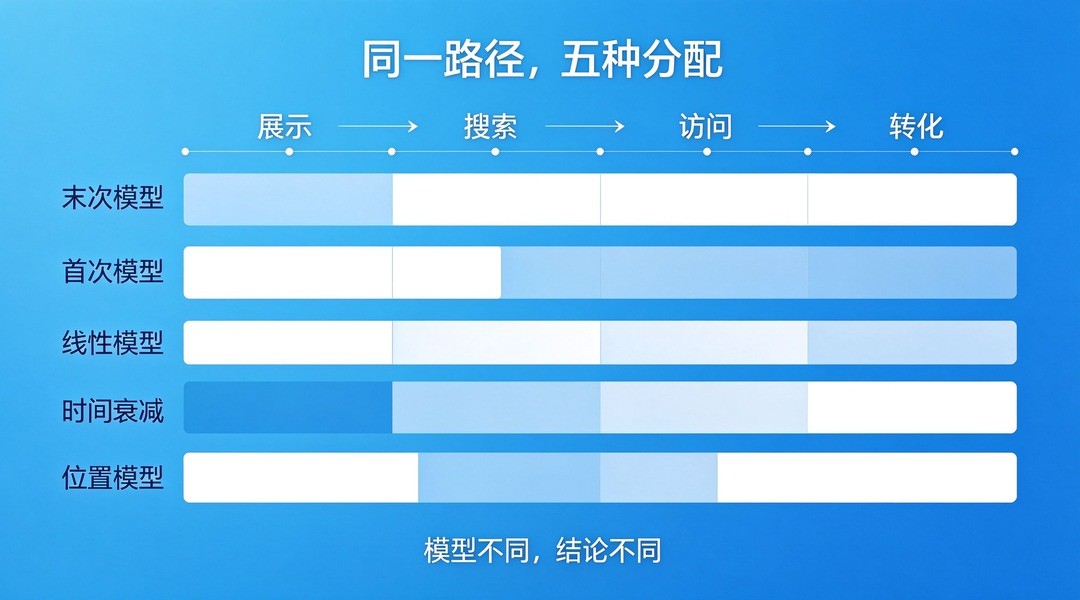
图2 五种归因模型对同一转化路径的功劳分配差异示意
图3 本文误区与边界的关键对比
四、误区与边界
4.1 误区:一个模型通用所有场景
没有一种归因模型通用所有场景。因为业务阶段与转化路径在变化(新品期看拉新、成熟期看成单),所以模型要随问题切换,而不是固定一个用到底。归因模型的"正确",永远是"对当前问题正确"。
4.2 误区:把归因结论当精确事实
归因结论是"按规则分配"的结果,不是精确事实。因为真实贡献受跨设备、跨触点与数据缺失影响,所以归因用于"分配方向"而非"精确到元的功劳",解读时保留这一前提。把归因结论当精确事实,预算决策会被规则误差带偏。
4.3 误区:所有渠道都要归因
不是所有渠道都适合归因:品牌曝光类渠道(无法追踪点击)与线下渠道(无触点数据)在数字归因里天然吃亏。因为归因模型依赖触点数据,所以对无法追踪的渠道,用增量测试等方法补充评估,而不是强行归因。
4.4 边界:归因需要触点数据支撑
归因依赖完整的触点数据:渠道标记、落地页、时间戳。因为触点数据缺失时归因结果会失真,所以接入统计工具时把渠道参数配置完整,归因才有数据基础。
4.5 边界:归因不替代渠道质量分析
归因看功劳分配,渠道质量看转化率与用户价值。因为高功劳渠道可能转化率低但量大,低功劳渠道可能转化率高但量小,所以分配预算时把归因结论与转化率、用户价值结合,不单独依赖归因。
4.6 工具能力与数据基础
归因模型的落地,离不开统计工具的支持:确认工具支持哪些归因模型、能否自定义触点窗口、数据导出是否完整。因为归因模型的选择最终要靠工具实现,所以评估工具时把归因能力列入清单,用真实路径数据验证。很多工具默认只提供末次点击,多模型需求要先确认是否支持。数据基础同样重要:触点数据完整(渠道标记、时间戳、用户标识)是归因准确的前提。因为触点缺失时归因会把功劳错误归给可见渠道,所以接入统计工具时把渠道参数配置完整,归因结论才可信。
4.7 季度复盘与结论留档
归因模型的结论要定期复盘:每季度重跑一次历史数据,看主力渠道排序是否稳定。因为用户行为与投放环境在变化,归因结论可能漂移,所以定期复盘能发现"渠道角色变了"的信号,及时调整预算结构。结论要写进投放复盘文档:因为归因结论是经验的沉淀,留档后下次投放可以直接对照,避免每次从头判断。
4.8 本文未覆盖的边界
本文未覆盖数据驱动归因、算法归因等高级模型的实现细节,也不展开跨设备归因(同一用户多设备触达)的识别机制。因为这类内容依赖工具能力与数据条件,所以需要时查阅官方文档与行业实践。
结尾
归因模型的选择逻辑是:先判断转化周期,再明确要回答的问题,然后多模型对比验证,最后固定口径持续追踪。回到预算复盘会上搜索与内容的争论,答案不是"谁对谁错",而是"你们在回答不同的问题"——一个用末次点击,一个用首次点击。把问题对齐,归因模型自然对齐。记住归因使用的纪律:模型给方向,业务做判断。