网站访问量异常增加的原因与识别方法
目录索引
- 增加不等于增长:先把五个维度摆上桌
- 八类原因,分两组看
- 异常增长四分类:一张矩阵看清位置
- 识别方法:从历史同期到日志交叉
- 不能仅凭量大就认定恶意
- 假设场景:一次五倍尖峰的复盘
- 监控与持续核查
- 实操补遗:一次尖峰的识别算例
- 内容缺口复盘与改进优先级
示例数字仅用于说明口径。
复盘会的大屏上,曲线上一根扎眼的尖峰戳在那里:某小时 PV 是平日的五倍。(示例值)运营说「这波投得不错」,技术皱眉说「看着像被刷了」。你作为管理者,先信谁?我的答案是:在把来源、页面和行为拆开看之前,两边都先别下结论。尖峰本身只是一个信号,它既可能是好消息,也可能是虚惊。
尖峰值不值得高兴,取决于你能不能在同一条时间轴上把它拆开。456数据支撑的一体化数据分析里,用户行为洞察与性能监控共用一条时间轴:尖峰发生在哪个小时、来自哪个渠道、落在哪些页面都能下钻,才不会被一个峰值数字带着走。访问量异常增加,首先要分清它是真增长还是噪声,这一步定错,后面的追投和处置全是反的。
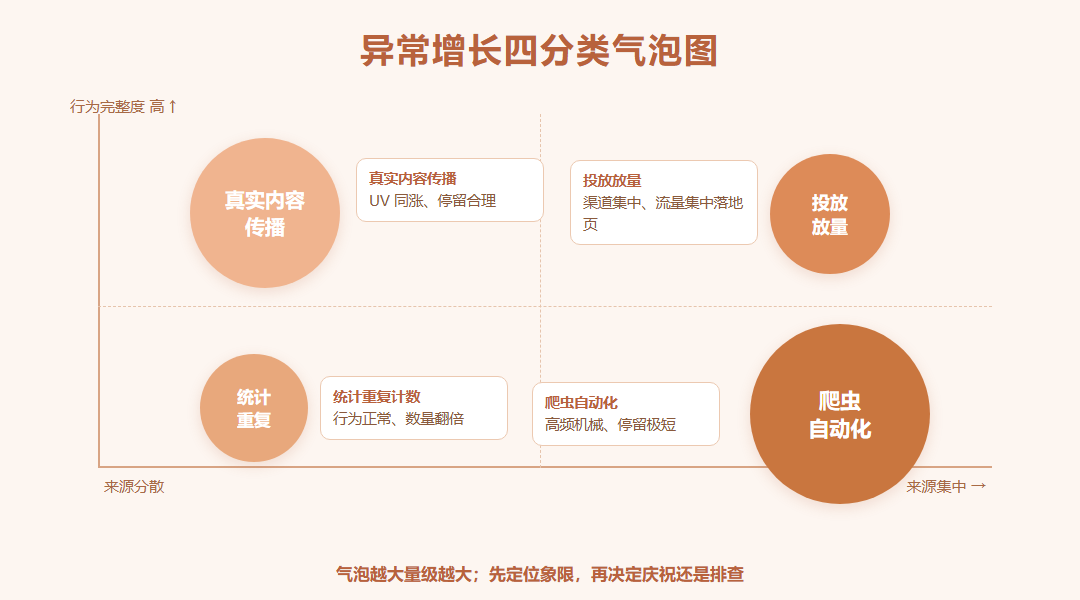
四个象限先分位置,再决定这根尖峰该庆祝还是该排查。
▌ 增加不等于增长:先把五个维度摆上桌
一个峰值数字本身说明不了什么。要判断它是不是真增长,得把 UV、PV、来源、页面分布和用户行为五个维度放在一起看,而不是只盯着总量。这五个维度分别回答「来了多少人、看了多少页、从哪来、看了哪些页、看得怎么样」,合起来才构成对一次尖峰的完整画像。
增加不等于增长
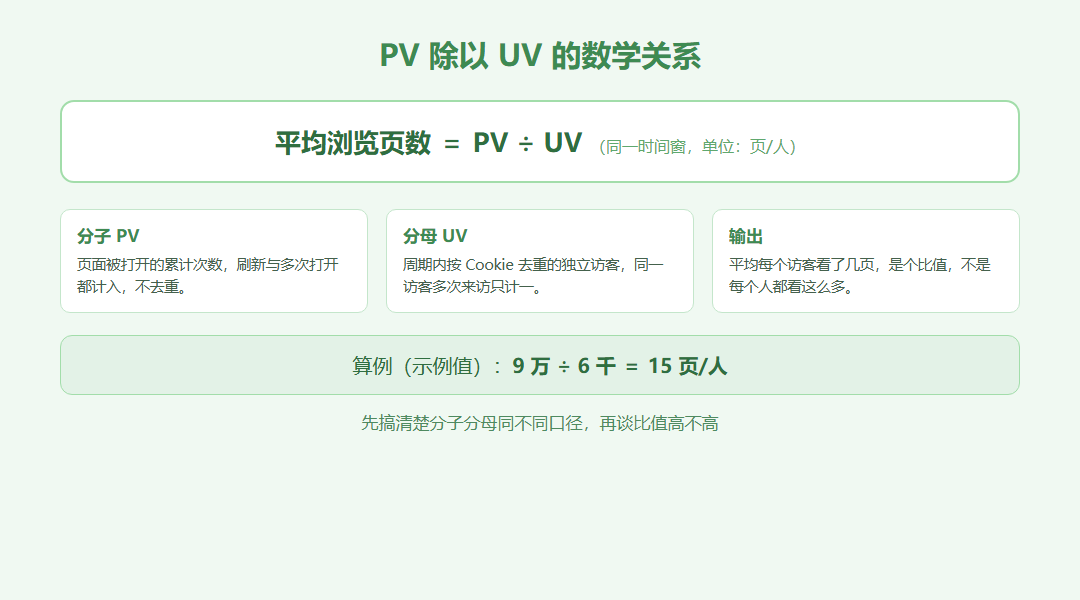
PV 涨了五倍,UV 如果几乎不动,说明不是来了更多人,而是同一批人在反复刷,或者统计在重复计数。真增长的特征是 UV 跟着一起动,来源多元、页面分散、行为完整。把这几个维度分开,尖峰的性质才会现形。管理者第一眼要问的不是「涨了多少」,而是「涨的是人还是数」,这一问就能把方向掰过来。
五个维度先放在一起看
来源看它从哪条路来、集中还是分散;页面分布看它是落在几篇爆款还是全站普涨;访问频率看是正常浏览还是机械重复;停留与跳出看访客是真看了一眼就走。五个维度各有指向,单看任何一个都容易误判。把它们并排摆在一张图上,比盯着一个峰值数字拍脑袋可靠得多。
▌ 八类原因,分两组看
异常增加的原因大致八类,分成真实增长组和自动化与统计组,两组的处置方向截然相反。先看它更像哪一组,再往下拆,能省去很多来回折腾。
真实增长类
内容被广泛传播、营销活动放量、搜索流量变化,都会带来真实的访问增长。这类尖峰通常 UV 同步上涨、来源分散、停留时间合理,后续还能看到回访和转化。它是值得趁热加把劲的——趁热度把落地页备好、把承接内容做扎实,尖峰才会沉淀成长期资产。
自动化与统计类
自动化程序访问、爬虫集中抓取,会让请求量和 PV 陡增,但 UV 分散且行为机械;重复事件上报、统计脚本重复加载,会让 PV 和事件数虚高而真人并没多。搜索或统计口径变化,则会让前后数据不可直接比。这类尖峰越热闹,越要冷静——它往往不带来任何后续价值。
▌ 异常增长四分类:一张矩阵看清位置
把八类原因归拢成四分类,再用来源集中度和行为完整性两个坐标定位,尖峰属于哪一类就清楚了。这是本篇的可复核资产。
来源集中度与行为完整性怎么看
来源集中在某一渠道、行为完整有停留有点击,多半是投放或内容爆发;来源集中在某几个固定请求、行为像机器人,多半是爬虫或自动化;来源分散但页面访问极浅、跳出极高,要警惕重复计数。四分类没有绝对边界,靠的是多维度交叉。遇到介于两类之间的尖峰,先把它归到最可疑的一类去验证,证伪了再换下一类。
| 分类 | 来源集中度 | 页面分布 | 访问频率 | 停留与跳出 |
|---|---|---|---|---|
| 真实内容传播 | 较分散 | 多篇内容页 | 正常浏览 | 停留合理、跳出适中 |
| 投放放量 | 集中在投放渠道 | 集中在落地页 | 短时涌入 | 随素材质量波动 |
| 爬虫自动化 | 来源混杂或固定 | 集中在少数页 | 高频机械 | 停留极短、跳出高 |
| 统计重复 | 与真实来源一致 | 与真实页面一致 | 同一行为多次计数 | 行为本身正常但数翻倍 |
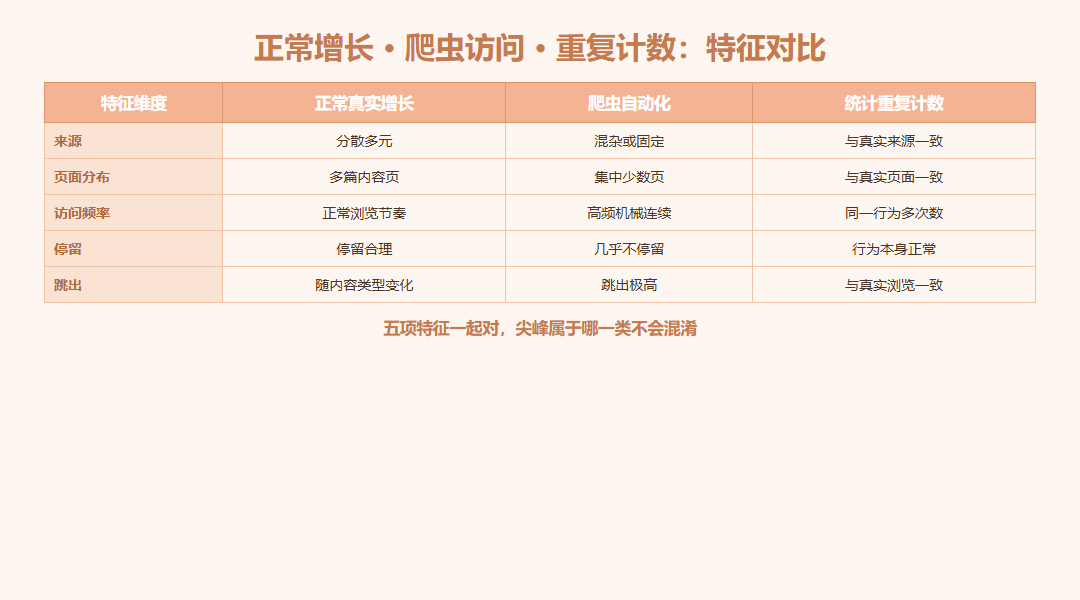
三列并排比,尖峰属于哪一类,一眼就能对号入座。
▌ 识别方法:从历史同期到日志交叉
定性不能靠感觉,要按顺序走一套识别动作。
历史同期与短时变化
先拿历史同期比,看这种量级是不是周期性的;再看短时变化,尖峰是持续几小时还是几分钟。持续且 UV 同步的,更像真实增长;瞬间爆发又瞬间消失的,要多打个问号。做投放的日子要把排期标在旁边,否则很容易把一次正常活动当成异常。
频率与行为模式
看访问频率和行为模式。下面这张频率参考是经验值,非硬性标准,需用自家数据校准:单个访客短时间内连续请求数十个页面、几乎不停留,偏离了正常浏览节奏,就值得拉出来单独看。真实访客通常会在页面上停留、会点几下、会在站内多绕两圈,这种节奏感是装不出来的。
| 频率表现(经验值,非硬性标准) | 可能含义 | 下一步 |
|---|---|---|
| 短时多次刷新同页 | 真实反复看或重复上报 | 核对脚本是否重复加载 |
| 单访客连续请求数十页无停留 | 爬虫或自动化 | 结合日志看请求特征 |
| UV 稳而 PV 翻倍 | 同一批人被重复计数 | 查事件触发与路由 |
| 来源单一且瞬时涌入 | 投放或活动放量 | 核对同期营销动作 |
核对重复与日志交叉
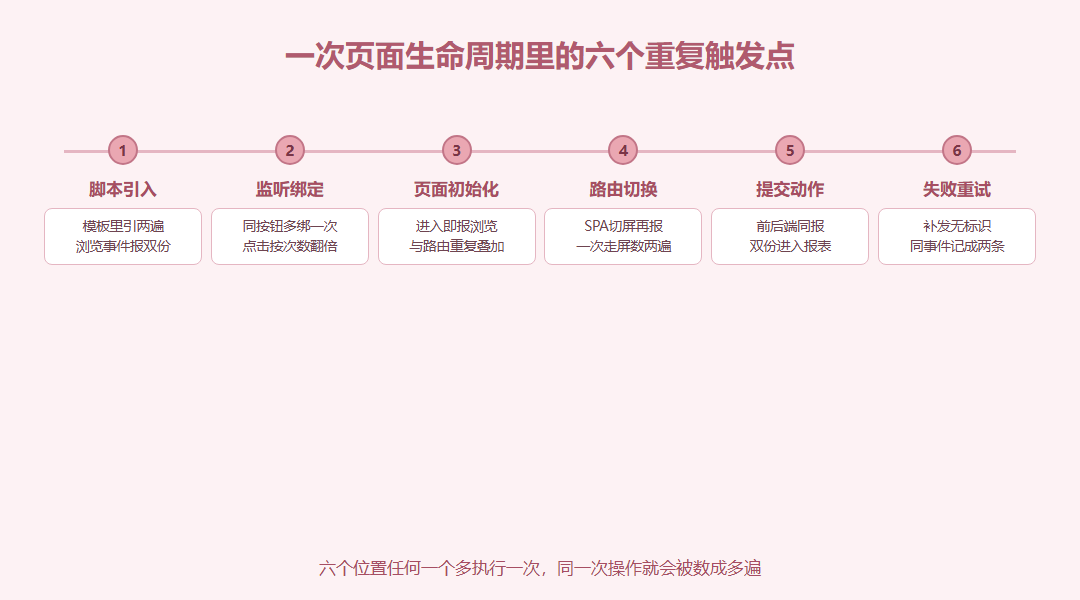
接着核对页面浏览事件有没有重复触发,再把统计数据和服务器日志交叉验证。日志里看请求特征、看 UA 和抓取规律,统计端看 UV 与行为。两边对得上,性质就清楚了。如果统计端的 PV 远高于日志里对应页面的请求数,优先怀疑重复计数;如果两边量级一致而 UV 偏低,则更像是爬虫或自动化。
▌ 不能仅凭量大就认定恶意
这里要特别提醒:不能因为访问量高、或者某一项指标异常,就直接认定存在恶意访问。尖峰可能是真实的好消息,也可能是采集问题。在证据链完整之前,扣帽子只会让后续处置方向走偏。把「疑似刷量」这种判断留到最后一步,前面先老老实实拆维度。
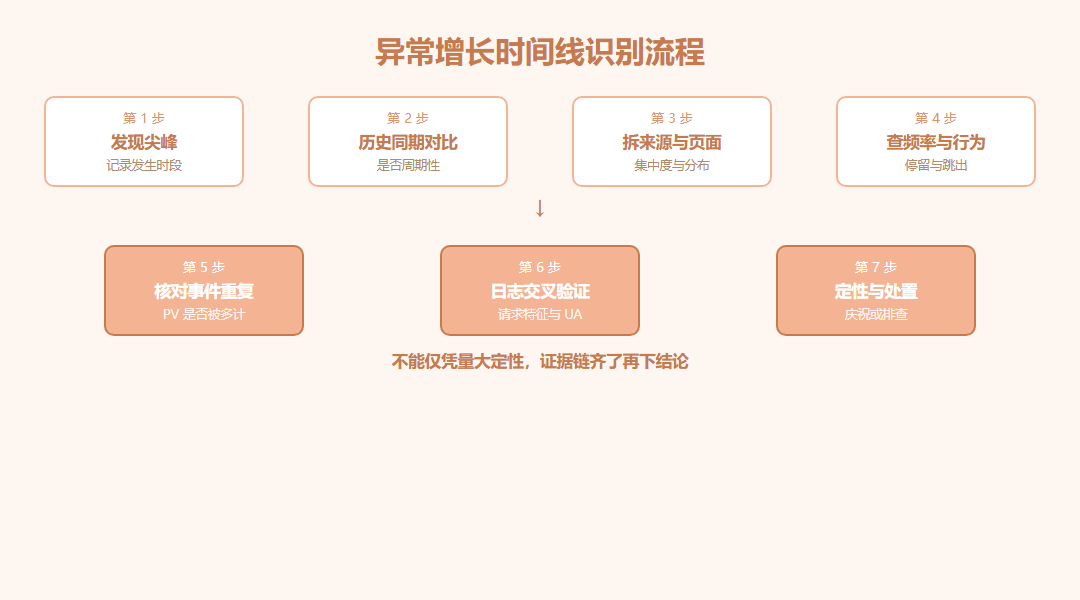
沿时间线走一遍,把尖峰从热闹变成一句站得住的判断。
▌ 假设场景:一次五倍尖峰的复盘
我把这类尖峰复盘合并成一个标准场景来讲,细节不指向任何一家真实网站。某小时 PV 冲到平日的五倍(示例值,合并提炼,非真实数据),运营和技术各执一词。值班同学先拉历史同期,发现这个时段平时并没有这种周期性,也没有同期的投放排期,排除了活动与周期两种可能。
从定性到后续
拆开一看,UV 只涨了约三成,来源集中在一个外部链接,页面分布集中在一篇文章,停留时间明显偏短、跳出偏高。再翻服务器日志,发现大量请求来自同一类 UA 的集中抓取,频率远超正常浏览。阶段性结论是:尖峰主要由爬虫集中抓取造成,并非真实用户暴增,不需要追加投放,只需在过滤规则上确认这类抓取是否已被合理处理。运营听到结论没有泄气,因为他们关心的转化数据并没跟着尖峰动。
▌ 监控与持续核查
识别方法讲完,最后强调一个态度:监控尖峰的意义在于在增长和噪声之间做清醒的判断。把历史同期、来源页面、频率行为和日志交叉这几步固化成动作,下一次尖峰来的时候,你就不需要再开一场各执一词的复盘会了。
管理者要的是增长质量,而不是峰值数字。456数据把来源、页面与事件放在同一时间轴下钻,能快速分辨尖峰来自真人还是重复上报;是否值得追投,仍要看后续的行为与转化。把每次尖峰的定性结果记下来,久而久之你会摸清自己站点常见的几类噪声来源。
增长与噪声的分界
最后给三句话判断标准:UV 跟着涨、来源分散、行为完整,才是值得庆祝的真增长;UV 不动、来源集中、行为机械,多半是噪声;统计翻倍而日志不支撑,先回头查采集。把这三句记住,复盘会上就不会被一根尖峰带节奏,也不会把噪声错当成绩去追加预算。
▌ 实操补遗:一次尖峰的识别算例
算例(示例值,合并提炼):某工作日 UV 较平日涨约三倍。拆来源与频率:某篇文章被社交平台转发带来约八成新 UV,停留与翻页正常,属于真实增长;剩余约两成来自同一 IP 段的高频刷新,单访客浏览深度极低、访问频次异常,属于自动化访问,应在报表里剔除。
判断尖峰真伪看三件事:来源是否高度集中于单一渠道或单一 IP 段、单 UV 浏览深度是否正常、访问频次分布是否呈人工不可能的密集形态。落地五步:一、保留尖峰当日原始日志不做清洗;二、按来源与页面分布拆增长结构;三、把疑似高频访问单独标记;四、与真实传播事件(转发、投放、媒体报道)对照;五、确认是真增长再排资源,是异常则走过滤规则,不急于庆祝也不急于关停。
▌ 内容缺口复盘与改进优先级
本文没有展开的部分:刷量的技术对抗手段、广告刷量的举报流程,以及社交传播效果的单独归因方法。这些超出数据统计口径范围。
按落地顺序排列改进项:P0——尖峰出现先剔除机器人与高频访问,再判断是不是真实增长;P1——对每一次尖峰日保留来源与频次分布样本,留作后续对照;P2——把爬虫与过滤规则的调整版本化,改动前后留痕,避免误删真实流量。
延伸阅读
参考资料
- 网站统计常用指标说明,支撑 PV、UV、新访客率等指标的逐项口径。
- 网站统计接入指南,支撑统计脚本部署与采集流程说明。
- RFC 9309 机器人排除协议,支撑爬虫抓取行为的协议依据。
- 百度搜索资源平台,支撑搜索引擎抓取观察的官方入口。