网站统计数据延迟的原因与排查步骤
目录索引
- 延迟长什么样
- 先把数据经过的五个环节想清楚
- 七类常见原因
- 延迟和失败是两回事
- 怎么一步步排查
- 假设场景:是没更新还是没采到
- 延迟预期管理:一页纸
- 想清楚实时和汇总的分工
- 实操补遗:一次延迟的分段计时算例
- 内容缺口复盘与改进优先级
示例数字仅用于说明口径。
周会上刚有人问出一连串问题:刚刚才发生的一次访问,为什么报表里还看不到?到底要等多久才出来?等不到是不是就丢了?为什么别的指标已经刷新了,唯独这个没动?这种情况到底要不要紧?做企业管理的人听到这五连问,第一反应不是急着查代码,而是先把「延迟」和「丢了」这两件事分开——它们长得像,处理方向却完全相反。等错了对象,要么白等一场,要么半夜把技术叫起来修一段根本没坏的链路。
要回答「数为什么还没出来」,先得看清数据走过哪条链路。456数据上的一体化数据分析,访问记录、用户行为洞察、性能监控共用同一套采集链路;数据在哪个环节慢下来,才值得顺着链路一段段看。这篇文章用一段对话还原的方式,把延迟的成因、环节、排查步骤和应对节奏讲清楚,让你下次再被问到这五个问题时,能稳稳答上来,也能带着团队少一点无谓的紧张。
▌ 延迟长什么样
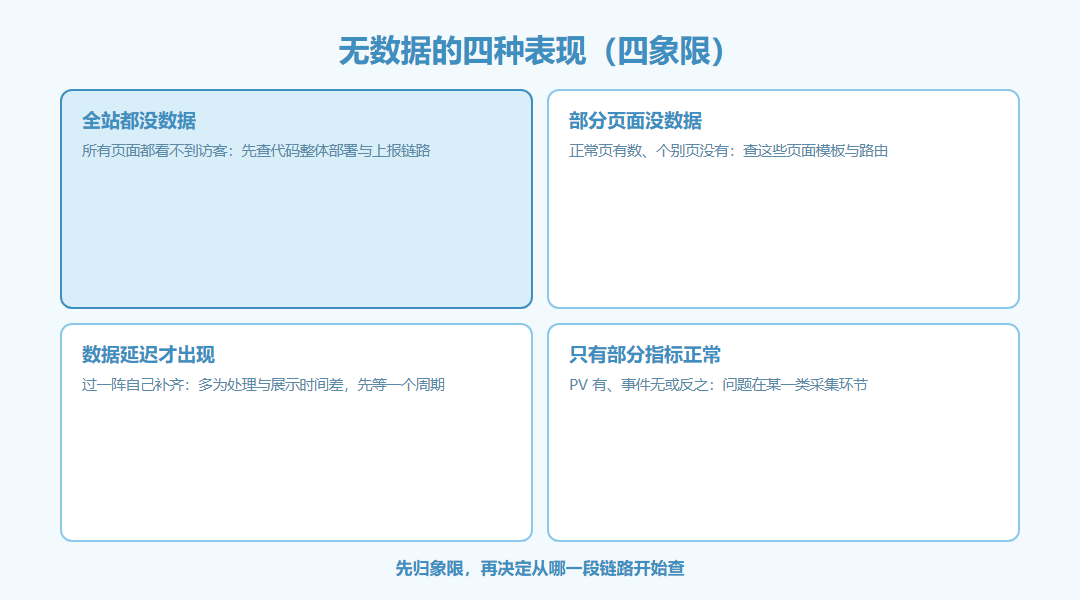
在回答要不要紧之前,先把延迟的几种表现认出来,别把所有「看不到数」都当成同一回事。认错了表现,后面的排查方向就全错,白忙一场。
访问发生后报表没有立刻更新
最常见的一种:你刚点完页面,转头去看报表,这条记录还没出现。这不代表它丢了,只是它还在链路上的某一段排队。绝大多数统计工具的汇总报表都不是逐笔实时刷新的,刚发生的访问要等下一个汇总批次才会被算进去,这个间隔从几分钟到更久不等,不同工具差异很大。
实时数据和汇总报表对不上
第二种:实时访客里刚刚还能看到这次访问,汇总报表里却暂时没有。两边数字有差距,是因为它们用的是不同的更新节奏,而不是一边错了。实时记录贴近采集端,汇总报表贴近计算端,中间隔着批次,有差距很正常。
部分指标比别的更晚出来
第三种:PV 已经出来了,某个事件或来源占比却晚一截才更新。不同指标走的计算路径不一样,出来的时间自然有先后,这本身是正常节奏的一部分。看到别的指标先动、唯独它没动,不必立刻认定它坏了,先记下来,过阵子再看。
▌ 先把数据经过的五个环节想清楚
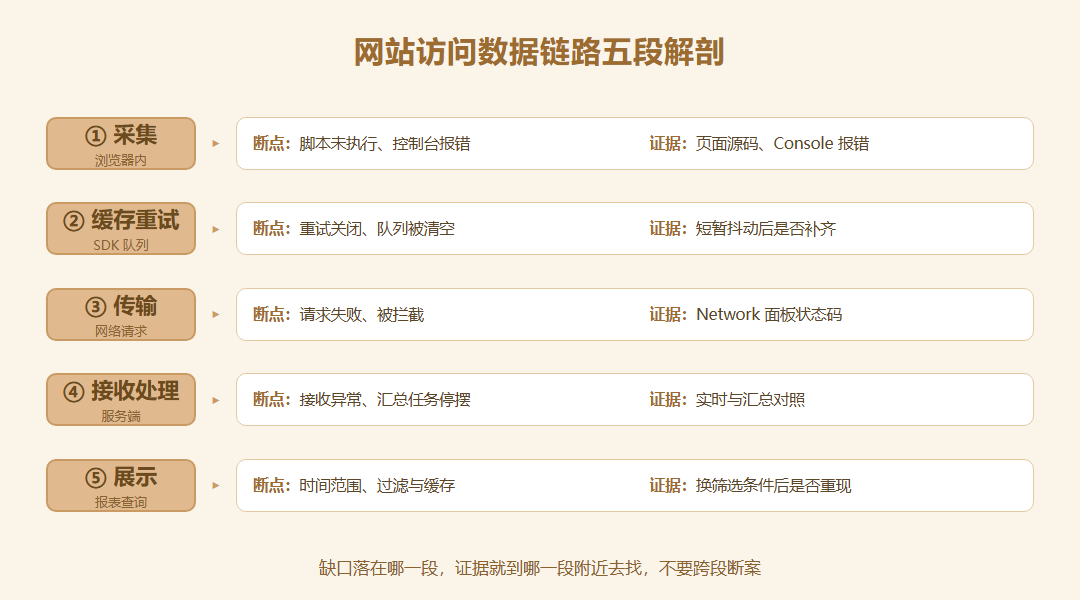
一条访问记录从发生到出现在报表里,要过五个环节。延迟不是凭空冒出来的,它是这五段里某一段慢了。先把这五段在脑子里排好队,后面排查时才不会东一榔头西一棒子。
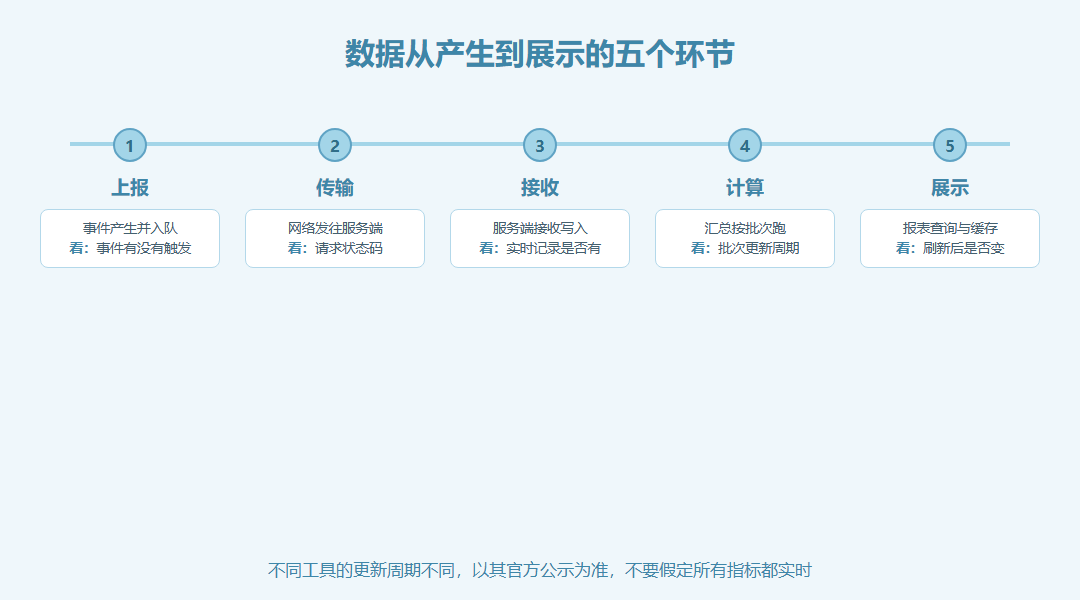
数据在五个环节之间流动,任何一段慢一点,你看到的就是「延迟」。
上报与传输
前两段在浏览器和网络里:事件被产生、排队,再通过网络发出去。页面关闭时的数据上报常常借助浏览器的 sendBeacon 这类能力,尽量在页面卸载前送达。网络不稳时,这段就会拉长;用户刚关页面就断网,这次上报还可能留到下次联网时再补。
接收与计算
中间两段在服务端:请求被接收、校验,再经过汇总计算变成指标。汇总不是逐笔进行的,它通常按批次跑,批次与批次之间就存在时间差。不同工具的更新周期不同,以其官方公示为准。你看到的「还没更新」,多半就卡在这两段之间。
展示与更新周期
最后一段在报表:你看到的数字受报表缓存和查询周期影响。有时候数据已经算好了,只是页面还没刷新到最新那一版。多等一等、手动刷新一下,数字就冒出来了,这种延迟最虚惊一场,也最常见。
▌ 七类常见原因
把常见原因归到浏览器、网络和平台三侧,排查时按侧下手,就不会在五段链路里绕圈子。
浏览器与网络侧
事件还没成功上报、网络连接时断时续、页面关闭时上报没发完,都会让数据晚到。这一侧的证据在浏览器的网络面板里:请求发没发、状态码是什么、有没有报错,一眼就能看到。
平台处理与展示侧
数据汇总存在时间差、报表有缓存、平台有自己的更新周期、过滤与计算流程需要时间,再加上本地时间、时区和统计日期设置不一致,都会让「该出的数」晚出来。这一侧的特征是:它最终会自己补齐,你要做的不是修代码,而是耐着性子等一个周期。
| 原因 | 所在侧 | 典型信号 |
|---|---|---|
| 事件尚未成功上报 | 浏览器 | 网络面板里看不到请求 |
| 网络连接不稳定 | 浏览器与网络 | 请求时快时慢、偶发失败 |
| 汇总计算有时间差 | 平台 | 实时有、汇总晚一截 |
| 报表缓存 | 平台展示 | 刷新页面后数字才变 |
| 平台更新周期 | 平台 | 固定间隔后整批更新 |
| 过滤与计算流程 | 平台 | 部分指标比别的更晚 |
| 时区与统计日期 | 展示设置 | 换时区后数字整体平移 |
▌ 延迟和失败是两回事
这是全篇最该记住的一张对照:延迟会自己补齐,失败不会。把两者混为一谈,要么白等一场,要么虚惊一场。延迟是数据在路上堵了一会儿,失败是这条路根本没通;前者给时间就好,后者必须动手修。
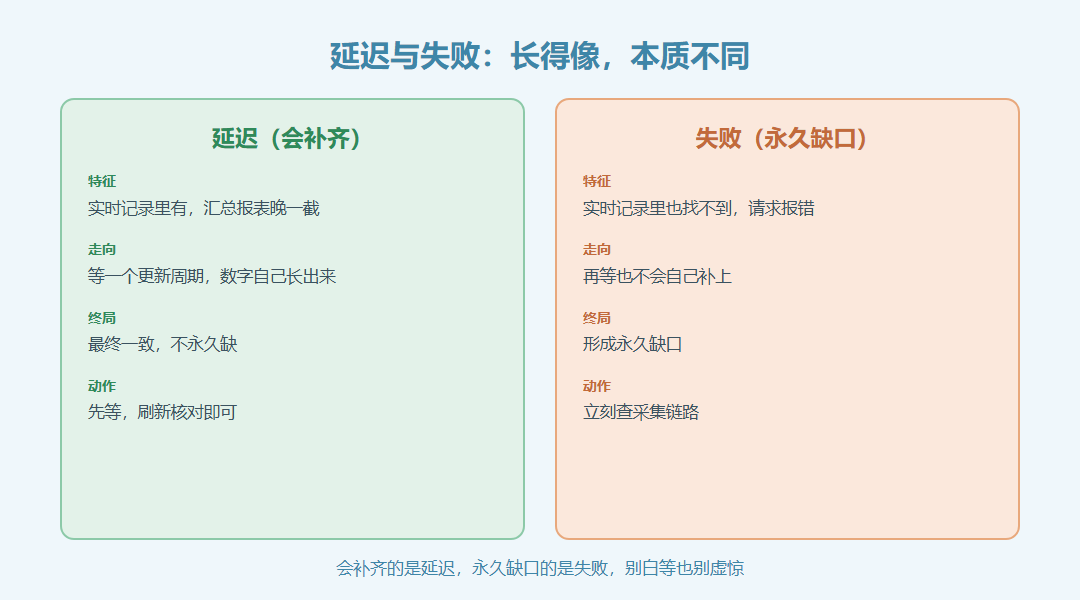
延迟的终点是补齐,失败的终点是缺口,两者处置完全不同。
▌ 怎么一步步排查
确认到底是延迟还是失败,按下面的顺序走,不要跳。跳步最常见的后果,是把一次正常的批次等待,误当成了采集故障去反复改代码。
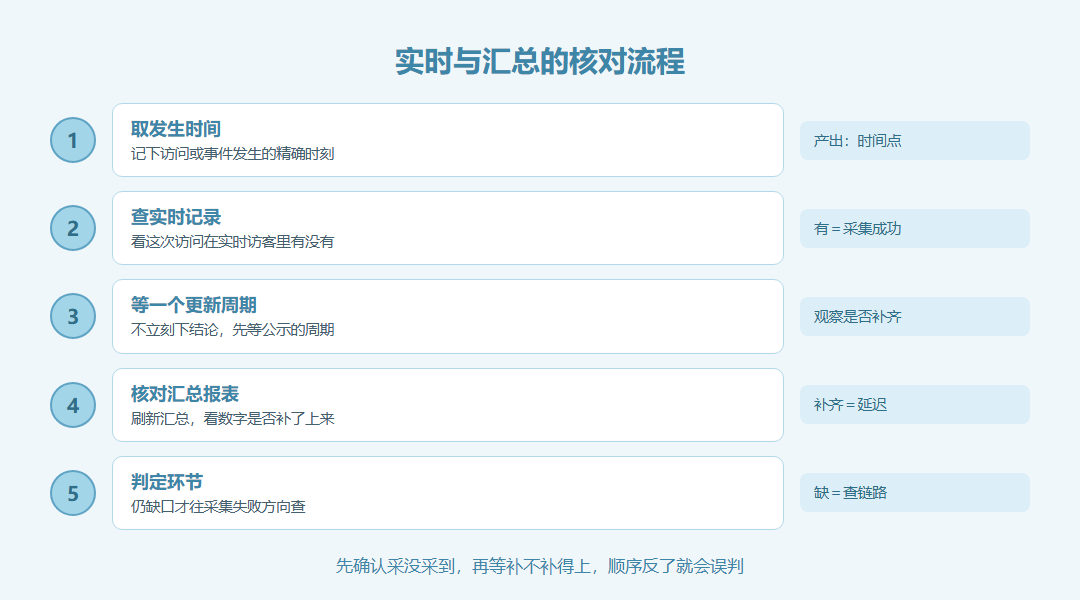
先看实时访客,再等周期,不要上来就怀疑采集挂掉。
第一步:用实时访客做快速自检
自己访问一次页面,看实时访客里面有没有这条记录。如果实时立刻出现,说明上报链路是通的,问题落在后面的计算、缓存、更新周期,大概率属于延迟,不是丢失。如果实时里面完全没有,再回头查浏览器上报请求。
第二步:核对时间与时区
确认报表选择的时间范围、时区和事件真实发生的时间是否匹配。时区错位会把访问记录切到另一天,看起来就像没数据。
第三步:等待一个完整更新周期再复核
汇总报表是批次化运算,不是毫秒级刷新。不要访问完立刻看汇总,等平台公示的更新周期结束,再打开报表刷新对比。到时间后数据出现,就是正常延迟;依然空白,才进入故障排查。
▌ 假设场景:是没更新还是没采到
下面还原一个值班时经常遇到的真实场景,数字全部为示例,不对应真实业务。测试人员在14点22分访问测试页面,立刻去看日汇总报表,看不到刚刚的访问记录。
排查过程
第一步打开实时访客,刚刚14点22分的访问记录清晰可见,证明上报链路完全正常;第二步核对时区为北京时间无误;第三步等待平台汇总周期结束,刷新汇总报表,这条访问记录正常出现。结论:只是汇总批次带来的数据延迟,采集没有故障,不需要修改任何代码。
▌ 延迟预期管理:一页纸
团队内部最好把预期写在一页纸上,避免每次有人看到报表没刷新就紧张。
- 实时访客:贴近上报时间,用来快速判断采集链路死活,不做业务统计依据。
- 汇总报表:按平台批次周期更新,不要拿刚发生的访问立刻校验汇总报表。
- 跨天数据:以平台处理完成之后的结果为准,不要凌晨刚过就去评判全天指标。
- 判断标准:实时有记录,到期汇总会补齐,归为延迟;实时无记录,到期依然空白,归为采集故障。
▌ 想清楚实时和汇总的分工
实时访客是故障自检工具,不是正式统计报表。456数据设计实时访客的定位就是:发生异常告警时快速判断「采集链路还活着吗」;正式业务复盘、指标统计,要使用经过批次汇总的报表。把两者分工搞混,就会反复被延迟现象惊扰。实时看链路死活,汇总拿业务结果,各司其职。
▌ 实操补遗:一次延迟的分段计时算例
算例(示例值,合并提炼):15:02:10 用户完成页面访问;15:02:12上报请求抵达平台,实时访客立刻出现记录;汇总批次每10分钟跑一次,下一批次在15:10执行;15:10之后刷新汇总报表,该访问的PV正式出现在指标内。
落地判断:15:03‑15:10之间看汇总报表会看不到这条记录,不属于丢失。落地三步:①有疑问优先打开实时访客;②核对时区与统计时间;③等待完整汇总周期,到期再校验业务报表。
▌ 内容缺口复盘与改进优先级
本文没有展开部分:大数据批处理任务调度细节、不同存储引擎的延迟特征、浏览器离线重试的底层实现,这些属于平台工程层面。
按落地顺序排列改进项:P0——区分实时自检工具与正式汇总报表,不拿刚发生的访问校验汇总指标;P1——团队内部明确更新周期预期,减少无效告警;P2——把「先查实时访客」写入数据异常排查第一步。
延伸阅读
参考资料
- 网站统计常用指标说明,PV、UV指标口径。
- 网站统计接入指南,采集上报流程。
- MDN Navigator.sendBeacon文档,页面卸载上报机制。