网站数据统计不完整如何检查与修复
目录索引
- 不完整长什么样
- 把完整性拆成四块拼图
- 覆盖率怎么算
- 八类常见原因
- 怎么一步步查和修
- 假设场景:38 页只回 21 页
- 覆盖度回归清单
- 把完整性当成日常验收项
- 实操补遗:一次完整性盘点算例
- 内容缺口复盘与改进优先级
示例数字仅用于说明口径。
打开自己维护的网站,把页面从头到尾数一遍:一共 38 个页面,你心里给每个页面都打了一个勾——首页、列表页、详情页、文章页、表单提交成功页,一个不少。可等你翻到统计报表,按页面去对,却发现报表里只回得出 21 个页面的访问记录。差的那 17 个页面去哪了?是没人访问,还是统计根本没采到?做产品经理的人遇到这种「清单和报表对不上」,第一反应就是动手盘完整性,而不是先猜访客是不是突然变少了。
完整性这件事,靠的是拼图而不是感觉。456数据上的一体化数据分析把页面访问、用户行为洞察、性能监控放在同一套采集里,哪一块缺了、缺在哪一层,就顺着页面、事件、来源、转化四块拼图一块块对。这篇文章给你一套可照做的检查与修复路径,再配上覆盖率公式和一份回归清单,让你下次对着一份对不上的清单,知道从哪下手。
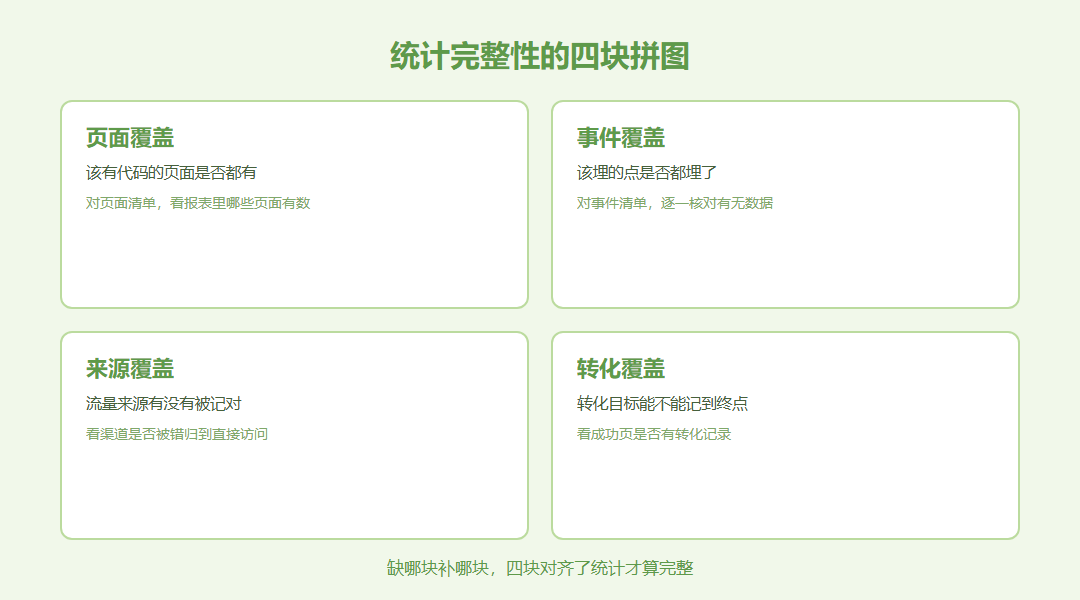
页面、事件、来源、转化四块拼齐了,统计才算完整。
▌ 不完整长什么样
「数据不对」和「数据不完整」是两回事。前者是数错了,后者是该有的数没齐。数错了要追口径,数没齐要追覆盖,两条路走岔了就会白忙半天还修错地方、越修越乱。先把不完整的几种样子认出来。
页面清单和报表对不上
最直观的一种:你心里有一份完整的页面清单,报表里却只有一部分页面有数据。要么是某些页面根本没装统计代码,要么是装了但上报失败,要么是代码加载顺序出了问题。后两种尤其隐蔽,因为页面能正常打开,肉眼根本看不出来。
事件漏记
按钮点击、表单提交、视频播放这些本应埋点的事件,报表里时有时无。表现为某个事件在某些页面有、在另一些页面完全没有,像是被谁悄悄抽走了一块。这种缺不是随机的,往往集中在某一类页面或某一次改版之后,顺着改版记录查,常常能很快找到。
来源或转化断了
该来的来源没被正确记录,转化目标也数不全。比如某个推广渠道进来的访客,在报表里被归进了「直接访问」;又比如支付成功这一步,永远统计不到。这两块不直接报错,最容易被当成「本来就这样」而放过,等真要算渠道效果和转化时才发现缺口已经不小。
▌ 把完整性拆成四块拼图
不完整不是一整块模糊的感觉,它可以被拆成四块清晰的拼图:页面、事件、来源、转化。缺哪一块,就去查哪一块。抱着「整个数据都不对」的念头发呆,不如先问自己缺的是这四块里的哪一块,再顺着那块往下钻。
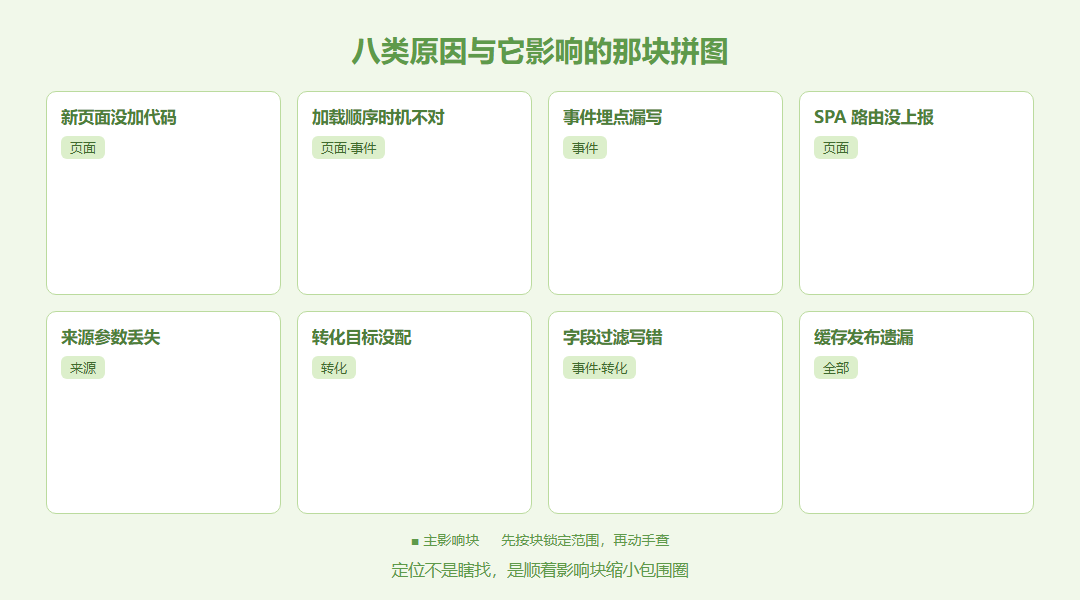
每类原因都有它主要影响的那一块,定位时先按块锁定范围。
页面覆盖
第一块是页面:该有统计代码的页面是不是都有了。把网站实际页面列成清单,再去报表里看哪些页面有访问记录,两边一对比,缺的页面就浮出来了。这份清单要跟着网站改版随时更新,不然它本身就先不完整。
事件覆盖
第二块是事件:该埋的点是不是都埋了、埋了是不是都上报了。把产品计划里要跟踪的事件列成清单,逐一到报表里核对有没有对应的事件数据。对不上的,再去看代码里那个事件到底有没有真正发出去。
来源与转化
后两块是来源和转化:流量从哪来、走到哪一步转化,有没有被正确记下来。这两块最隐蔽,因为它们不报错,只是悄悄地把数据归错地方或干脆漏掉。要靠拿已知的来源和已知的转化去对,才对得出来。
▌ 覆盖率怎么算
光说「不完整」太含糊,得用一个数把它量化出来,才好判断严重程度,也好在修复前后对比,证明这次修复到底起没起作用、补回了多少。
页面覆盖率公式
页面覆盖率=已验证有数据的页面数÷应覆盖页面数×100%。应覆盖页面数来自你整理的完整页面清单,已验证有数据的页面数来自报表里确实出现过访问记录的页面。两个数一除,就知道现在盖住了几成,也知道离全覆盖还差多少。
事件覆盖率算例
事件也用同样的思路。假设计划里要埋 24 个关键事件(示例值,合并提炼,非真实数据),逐一到报表里核对后,确认有数据的是 18 个。事件覆盖率就是 18÷24×100%=75%。剩下 25% 的事件,就是这次要去补的范围;补完再算一次,看覆盖率涨了多少。
▌ 八类常见原因
把常见原因归成八类,每类都对应到它影响的那块拼图,排查时按图索骥,就不会在网站里东翻西翻却抓不到重点。
| 原因 | 主要影响块 | 怎么发现 |
|---|---|---|
| 新页面没加统计代码 | 页面 | 报表里查无此页 |
| 代码加载顺序或时机不对 | 页面与事件 | 首屏快加载完却没数 |
| 事件埋点漏写 | 事件 | 计划有、报表无 |
| SPA 路由切换没上报 | 页面 | 首页有、内页无 |
| 来源参数丢失 | 来源 | 渠道被归进直接访问 |
| 转化目标配置缺失 | 转化 | 成功页无转化记录 |
| 字段被过滤或写错 | 事件与转化 | 上报了却对不上 |
| 缓存或发布遗漏 | 全部 | 本地有、线上无 |
▌ 怎么一步步查和修
查到不完整,不等于马上就能补回历史。修复是一条「抽查、修复、回归」的循环,下面这张图把它画成闭环。带着「修完就万事大吉」的想法,往往下一个版本又漏,漏得还不知不觉。
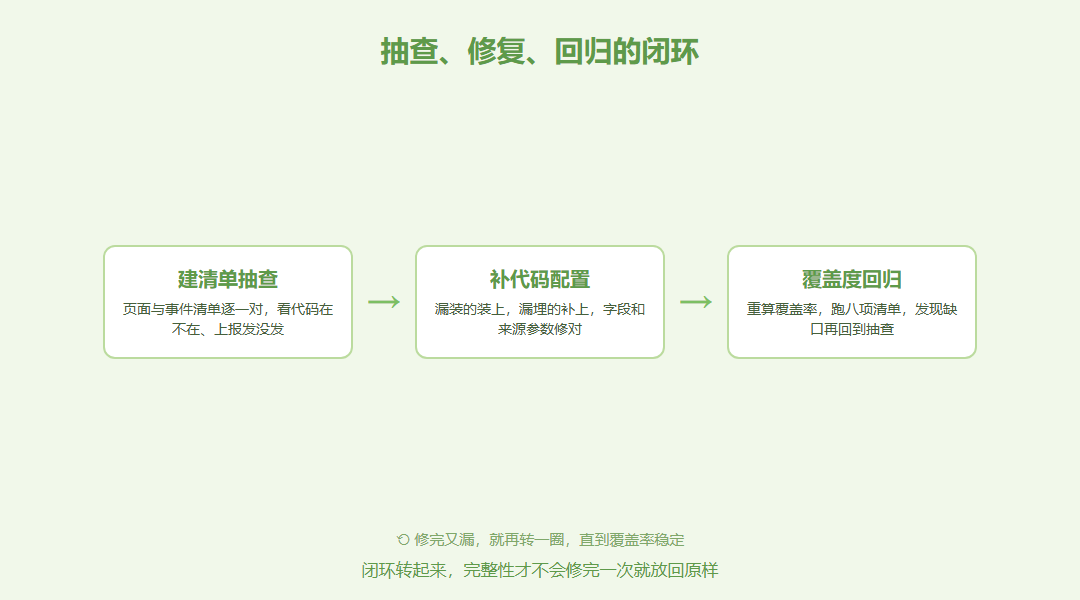
抽查、修复、回归三个环节转起来,完整性才不会修完又漏。
建清单与抽查
先把页面清单和事件清单建出来,这是一切的基准。再按清单抽查:打开一个页面看统计代码在不在,点一个事件看上报有没有发出来,前后对比报表里的数字。抽查不必全量,但要覆盖到不同类型的页面和关键事件,别只挑首页这种本来就有数的页面,那样查了也是完全白忙活一场。
修复后的边界
补好代码和配置后,要记住一条边界:修复统计机制不代表历史缺失必然可恢复,能否补齐取决于是否保留原始记录或其他可核验数据。机制修好了,只能保证今后的数据完整,过去缺的那部分,没有留证就找不回来。这一点必须在心里先有数,免得修完还对着历史缺口空等。
▌ 假设场景:38 页只回 21 页
接下来把这次盘点与修复完整走一遍,场景合并自多个项目,不指向任何真实网站。它把前面的覆盖率、抽查和回归串成一次完整的现场,先方便你照着核对一遍自己的网站。
一次回归的现场
产品经理盘点后发现(示例值,合并提炼,非真实数据):网站共 38 个页面,报表只回得出 21 页。先算页面覆盖率:21÷38×100%≈55%,刚过一半,离全覆盖差得远。接着按清单逐页抽查,发现 12 个 SPA 内页没在路由切换时上报,5 个新建页面压根没加代码。补完这两处后再等一个更新周期,报表里回来的页面涨到 36 个,覆盖率升到约 95%。剩下 2 个页面因为历史上从未成功采集,没有原始记录可补,只能认下这个缺口,今后靠监控盯住,不让它继续扩大。
▌ 覆盖度回归清单
每次发版或改完统计,照着下面八个勾走一遍,完整性就能守住。漏勾一项,就等于给下一次不完整悄悄留了个口子,口子多了,报表就真的不敢信了。
| 序号 | 回归勾选项 |
|---|---|
| 1 | 新发布页面都加了统计代码 |
| 2 | 代码在页面加载早期就执行 |
| 3 | SPA 路由切换会重新上报页面 |
| 4 | 计划内事件都能在报表看到 |
| 5 | 点击、提交、支付事件上报成功 |
| 6 | 来源参数没有被中途丢掉 |
| 7 | 转化目标能记到成功那一步 |
| 8 | 修复后页面覆盖率有提升 |
▌ 把完整性当成日常验收项
数据不完整最怕的不是修,而是修完没人再看,下一次发版又漏。把页面覆盖率和事件覆盖率做成每次发版前的固定验收项,456数据的实时记录可以帮你快速确认某个页面或事件有没有真正上报。工具只是把验证这件事变得顺手,真正守住完整性的,是把这张回归清单长期挂在发布流程里。要不要立刻开始盘你自己那份页面清单,由你按节奏决定;但从现在起,别再把「报表里有数」误当成「全都采到了」。
▌ 实操补遗:一次完整性盘点算例
算例(示例值,合并提炼):按「应采集清单」抽查 50 个 URL 的上报情况:42 个正常上报、5 个页面无脚本、3 个事件名与字典不一致。缺口不在数量而在分布——漏的 5 个恰好是本月新上线的活动页。修复顺序:先补页面覆盖,再统一事件命名,最后补缺失的业务属性,一次只改一类,避免新改新错。
落地四步:一、列出本站应采集的页面与事件清单(基线);二、按清单逐一对照实际上报;三、把缺口分成「缺页面、缺事件、缺属性」三类;四、按影响面排修复顺序并记录每轮修复数量。完整性是巡检出来的,不是感觉出来的——每月一次对照清单,缺口率才能持续下降。
▌ 内容缺口复盘与改进优先级
本文没有展开的部分:埋点管理平台的选型与实施、跨团队事件命名规范的制定流程,以及自动巡检系统的搭建。本文只给盘点方法。
按落地顺序排列改进项:P0——先建立「应采集清单」与「实际上报」的对照表,没有基线就谈不上完整性;P1——按缺口影响面排修复顺序,先补高频页与关键事件;P2——把完整性检查纳入每次上线验收,缺口随版本关闭而不是靠季度补。
延伸阅读
参考资料
- 网站统计常用指标说明,支撑PV、UV与事件等指标口径的逐字依据。
- 网站统计接入指南,支撑统计代码部署与数据上报流程的说明。
- 网站事件与转化配置说明,支撑事件和转化目标配置的依据。
- MDN History API 文档,支撑单页应用路由切换的技术依据。
- MDN Page Visibility 文档,支撑页面可见性状态判断的技术依据。