RFM用户分层:复购周期不同怎样设时间窗
本文要点
1. RFM模型里的时间窗(Recency看多久以内、Frequency看多长周期)不能照搬模板,要根据你产品的复购周期来定。
2. 高频复购产品(生鲜、咖啡)时间窗设短一点(7天、30天),低频复购产品(家具、家电)时间窗要拉长(90天、180天)。
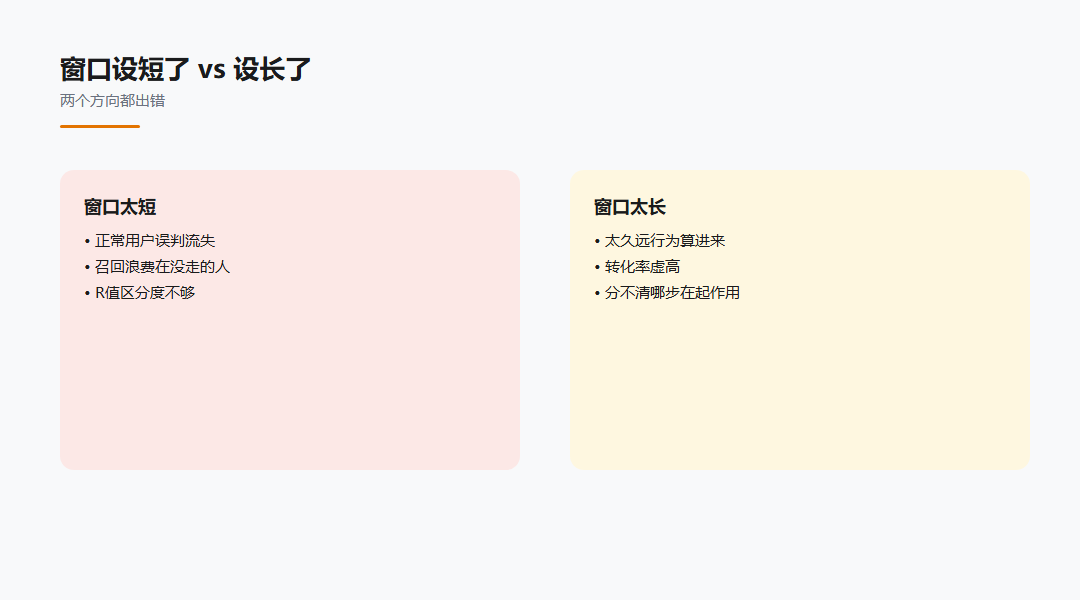
3. 时间窗设得太短,会把正常的复购周期用户误判为“流失“;设得太长,又看不出用户活跃度的变化。
4. 设时间窗的方法:先算你的平均复购周期,然后取复购周期的1.5到2倍作为观察窗口。
5. 456数据的用户分群支持按最近访问时间、购买频次自定义筛选条件,你可以灵活调整时间窗做不同分层。
做用户运营的人上RFM分层,最容易踩的坑就是直接套模板:”最近30天有购买是活跃用户,90天没买是流失用户。“但如果你是卖家具的,客户平均半年才买一次,按30天划分,那老客户全被标成了”流失“——这不是用户走了,是你的时间窗设错了。
之所以会这样,是因为RFM的三个维度(最近一次消费、消费频率、消费金额)本身没有标准答案,它们的阈值完全取决于你所在行业的复购周期。一个买咖啡的用户三天没来就是异常,一个买冰箱的用户三年没来才是异常。用同一个时间窗套所有产品,分层结果肯定是错的。
场景与目标:时间窗怎么定
 RFM分层的场景拆解
定时间窗前,先算一个关键数字:你的用户平均复购周期是多少天。这个数字从历史订单数据里算——取所有有两次以上购买的用户,算他们两次购买之间的平均天数。
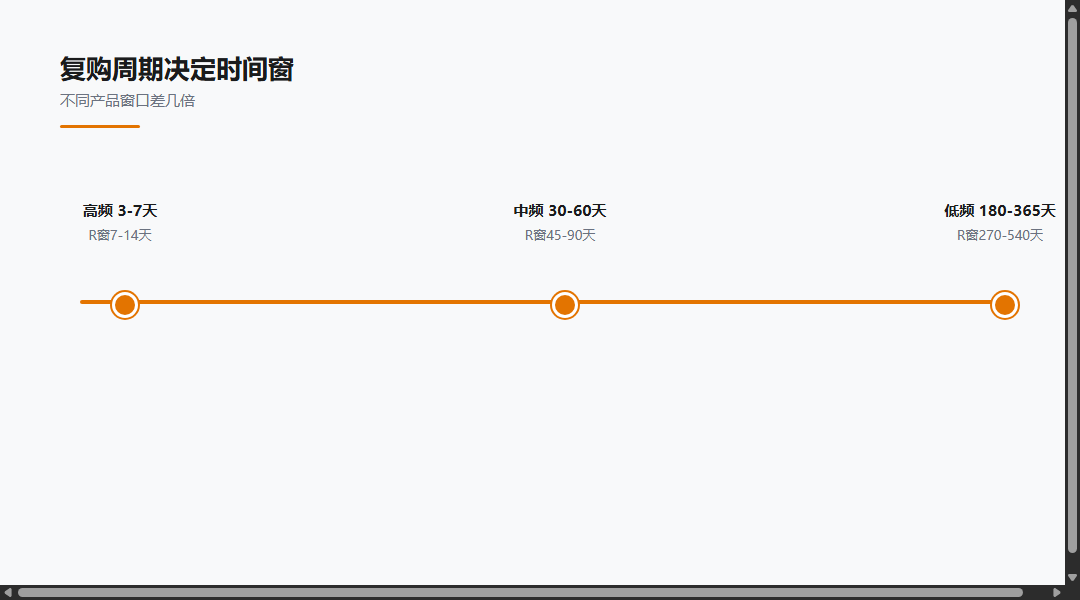
| 产品类型 | 典型复购周期 | R观察窗口 | F统计周期 |
|---|---|---|---|
| 高频快消(生鲜/咖啡) | 3-7天 | 7-14天 | 30天 |
| 中频消费(美妆/服饰) | 30-60天 | 45-90天 | 90天 |
| 低频耐用品(家具/家电) | 180-365天 | 270-540天 | 365天 |
在456数据里,用户分群支持按最近访问时间、事件频次自定义筛选。因为456数据按设备去重记录用户行为,你可以圈选”最近30天内有购买事件“的用户作为活跃群,”最近90天没有购买事件“作为流失群,然后看这两群人的行为差异。时间窗可以随时调整,不用改代码。
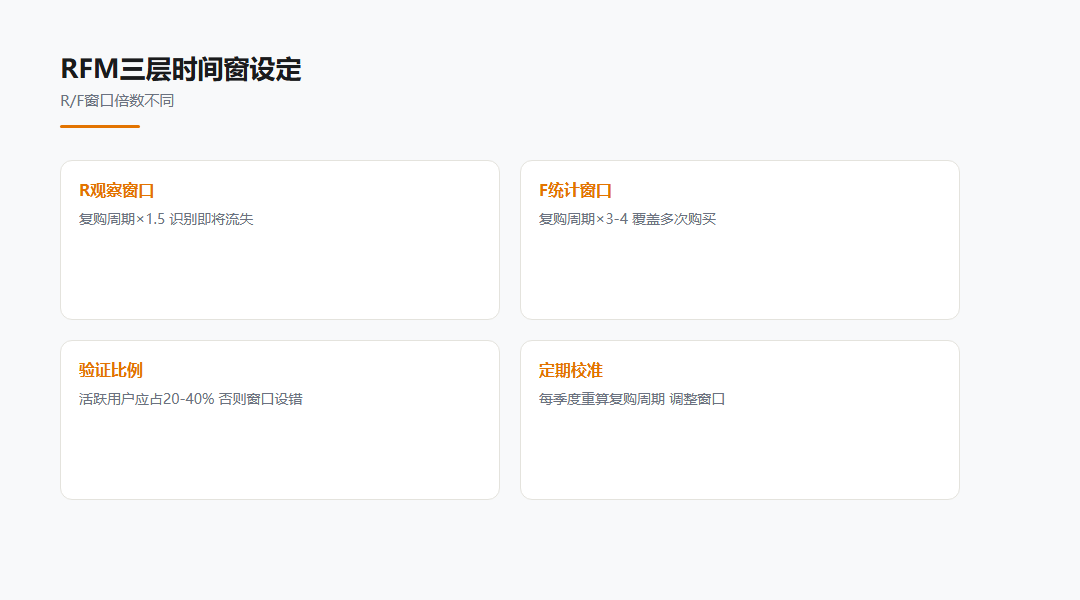
一个常见错误是把R和F的时间窗设成一样。R(最近一次消费)看的是”用户多久没来了“,窗口应该短一点,用来识别即将流失的人;F(消费频率)看的是”用户一段时间内买了几次“,窗口应该覆盖完整的复购周期,否则频次会被低估。
操作顺序:四步设定RFM时间窗
第一步:算平均复购周期
从历史订单里取有两次以上购买的用户,算他们两次购买之间的天数,取中位数(不是平均值,因为平均值会被极端值拉偏)。这个中位数就是你的典型复购周期。
第二步:定R的观察窗口
取复购周期的1.5倍作为R窗口。比如你的用户平均45天买一次,R窗口就设67天左右——超过67天没买的用户,已经超过了一个半复购周期,大概率有流失风险。
第三步:定F的统计周期
取复购周期的3到4倍作为F统计窗口。比如45天复购周期,F窗口设135到180天,这样能覆盖3到4次复购,频次统计才有意义。窗口太短,大量用户只买过一次,区分度不够。
第四步:跑一次分层看结果是否合理
用你设的时间窗跑一次RFM分层,看各层用户占比是否合理。如果”重要价值用户“只占2%,而”流失用户“占了60%,那时间窗大概率设错了——正常情况下活跃用户应该占20%到40%。不合理就回去调窗口,直到各层比例符合业务直觉。
设好时间窗跑过一轮分层之后,还有一个容易忽略的步骤:验证分层结果是否真的有区分度。方法很简单:把”重要价值用户“和”一般发展用户“的后续行为对比一下——如果两组用户在接下来一个月的复购率差异不大,说明你的RFM阈值设得不好,分层没有真正区分出高价值和低价值用户,需要回去调阈值。
另外,RFM不是一成不变的静态标签。同一个用户这个月是”重要价值客户“,如果连续两个月没买,下个月就会滑到”重要挽留客户“。所以RFM分群要按周或按月重新计算,不要一次设好就不管了。456数据的用户分群支持按日更新,你设好条件之后系统会每天自动把符合条件的用户归入对应群体。
举个具体例子:假设你卖美妆产品,历史数据显示用户平均45天复购一次。那R窗口就设67天(45×1.5)——超过67天没买的用户进入”待唤醒“名单;F窗口设135天(45×3)——在这个周期内买过3次以上算高频用户。如果你卖的是家具,平均复购周期是365天,那R窗口要设540天,F窗口设1095天——按美妆的时间窗去看家具用户,所有老客户都被标成了流失,召回动作就会浪费在根本没走的人身上。
方法对照:不同复购周期产品的RFM参数对照
| 产品类型 | 平均复购周期 | R窗口(×1.5) | F窗口(×3-4) | 分层重点 |
|---|---|---|---|---|
| 生鲜快消 | 3-7天 | 5-10天 | 14-28天 | R维度权重高 |
| 美妆服饰 | 30-60天 | 45-90天 | 90-240天 | R和F并重 |
| 家具家电 | 180-365天 | 270-540天 | 540-1460天 | F维度权重高 |
在456数据里,用户分群支持按最近访问时间和事件频次自由组合。你可以快速试不同的R窗口和F窗口,对比各层用户占比。因为456数据每天按日更新分群结果,时间窗调整后不需要重新跑历史数据。
不适用边界
RFM用户分层的方法有其适用边界。
RFM分层适用于有明确购买行为的产品。如果你的产品是纯内容类(没有付费),RFM不适用——你应该用访问频次和停留时长来定义活跃,而不是消费金额。另外,B2B产品的复购周期可能长达一年以上,RFM的F维度参考意义不大,更适合用客户阶段(线索/商机/成交)来分层。
为什么选用456数据
RFM分层建完最大的问题是”分完就不管了“——时间窗不会自动跟着复购周期变。456数据的用户分群能力支持按最近购买时间、购买频次、客单价组合条件圈人,你可以随时调整时间窗重新计算分层结果。分出来的人群包还能直接看留存和转化,验证分层是否有效。用户画像与分群分析自专业版起提供。
常见问题
关于RFM分层,实操中常见以下疑问。
复购周期怎么算才准?
取中位数而非平均值。因为少数大客可能一年买十几次,把平均值拉得很高,但大多数用户的真实复购周期更接近中位数。取过去一年有两次以上购买的用户,算相邻两次购买间隔的天数,取中位数。
RFM分层设好之后就不能改了吗?
不是。复购周期会随产品运营变化——做了订阅制之后复购周期可能缩短,提价之后可能拉长。建议每季度重新算一次复购周期,调整时间窗。
小流量产品样本不够怎么算复购周期?
经验值,非硬性标准:如果历史订单少于1000笔,复购周期算出来不稳定。这时候可以参考行业公开数据做初版,等数据积累够了再校准。
新冷启动产品没有历史数据怎么设RFM窗口?
如果产品上线不到三个月,复购周期算不出来,可以参考行业公开数据做初版窗口。比如美妆类参考45天复购周期,生鲜类参考7天。等数据积累到三个月以上,再用自己的用户数据重新校准。初版窗口不需要完美,先用起来再迭代。
R和F的评分阈值怎么定?
R和F通常各分三档(高/中/低),组合成9个象限。分档阈值可以用三分位数——把所有用户按R值排序,前1/3为高、中1/3为中、后1/3为低。F同理。这样每个层级的用户数大致均衡,不会出现”高价值用户“只有几十人的情况。
RFM分层跑出来后,建议每月重新计算一次。因为用户的复购行为会随季节和促销活动变化,时间窗也要跟着调整。
RFM分群建好后,建议针对不同层级设计不同运营策略:重要价值用户做会员权益,重要保持用户做定期唤醒,重要发展用户做交叉推荐,重要挽留用户做召回。不同层级不要发一样的推送。
RFM分层的时间窗不是一成不变的。因为用户的复购行为会随季节、促销活动和产品迭代而变化,建议每季度重新校准一次时间窗。456数据的用户分群能力支持按行为条件自定义人群——你可以用最近一次购买时间、购买频次和客单价三个维度组合出RFM各层级人群,然后针对不同人群设计差异化运营策略。需要注意的是,RFM分层适用于有明确复购周期的电商和订阅类产品,对于工具类内容类产品,RFM的区分度可能不够,应改用使用频次和功能深度维度做分群。
RFM分层建好后,建议先拿一个月的数据验证分层效果。因为分层模型是否有效,要看高价值用户的留存率和复购率是否真的高于其他层级。如果分层后各层指标差异不明显,说明时间窗或分层阈值需要调整。456数据的用户分群能力支持对不同人群分别看留存和转化指标,方便你验证分层假设。
RFM分群一定要三等分吗?
不一定。三等分(各三分之一)只是默认做法。实际操作中,行业通行实践中,高价值用户通常只占10-20%,但贡献50%以上的收入(经验值,非精确值)。你可以根据业务价值调整分层比例——比如把R值最靠前的20%划为重要价值用户,而不是机械地按三等分分。456数据的用户分群支持自定义阈值,你可以按实际数据分布调整。
RFM分析需要多少数据量才有意义?
自查清单
设RFM时间窗时,逐项确认:
1. 从历史订单算出用户平均复购周期(中位数)
2. R窗口取复购周期的1.5倍
3. F窗口取复购周期的3-4倍
4. 跑一次分层,检查各层用户占比是否合理
5. 每季度重新校准时间窗