只有特定浏览器报JS错误?按版本下钻的排查路径
周一早上九点十五分,我刚倒上咖啡,告警群就先炸了:JS 错误量在过去四十分钟里翻了三倍。值班群里有人甩来一张监控曲线——报错像被人从底下顶了一下。但奇怪的是,客服侧的用户投诉并没同步上涨,产品同学也说核心下单链路看上去正常。这种“监控在叫、用户没叫”的错位,是前端工程师最熟悉的一种早晨。
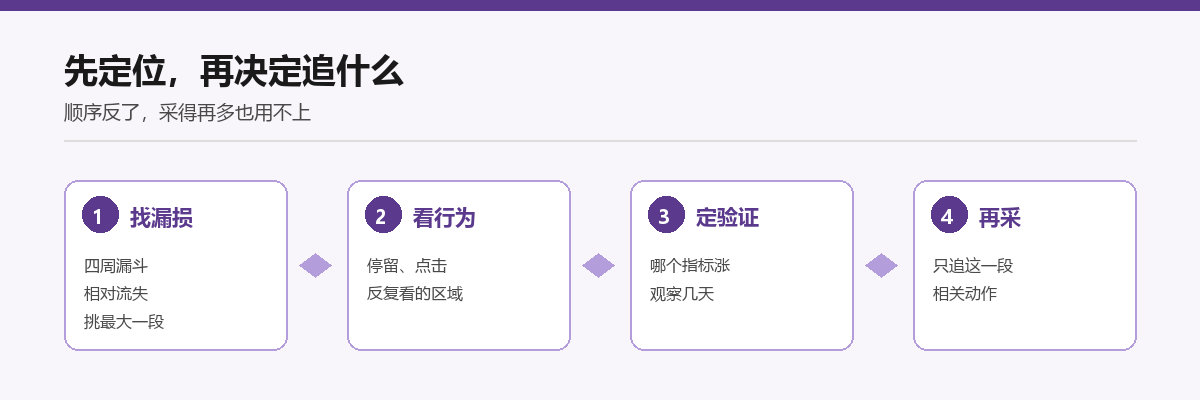
我通常不会这时立刻打开编辑器翻代码。“报错量整体飙升”和“某一类用户在某一类页面集中报错”是两件事:前者往往是一次发布引入的全站问题,后者更可能是某个浏览器版本的兼容问题。方向不同,排查路径完全不同。所以正确的第一步,不是去找代码,而是先把范围缩小。
一、先分清这是“面”还是“点”
面对一条突然抬头的报错曲线,先问两个问题:一是报错有没有跟着某次发布走,二是是不是只落在某几个浏览器里。全站浏览器都在报,大概率是刚发的版本自己出了问题,应当优先考虑回滚;只有某个浏览器版本在报、其他浏览器曲线平稳,更像是兼容性问题,不必回滚全站。之所以先做这个判断,是因为回滚的成本远大于定位一个兼容问题——判断错方向,整支团队的早晨都会被拖垮。
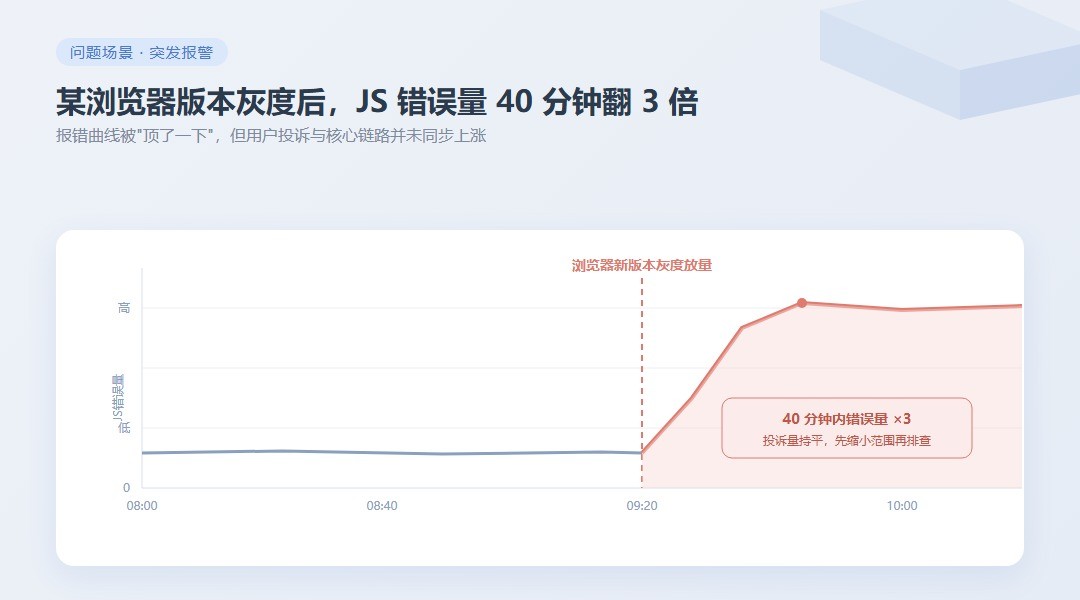 报错量在某浏览器版本灰度放量时段出现尖峰,其他浏览器保持平稳
这里有个小经验:真遇到这种早晨,不要一上来就盯堆栈。堆栈是最后才该看的东西——它告诉你代码在哪,却不告诉你为什么偏偏是这批用户在报错。先看版本分布,五分钟就能判断要不要回滚;先盯堆栈,可能会在一堆压缩后的行列号里耗掉一上午。排查顺序错了,时间就先没了。
二、用三个维度交叉,把“谁在错”切出来
确认是“点”问题之后,下一步就是下钻。我在前端监控里按浏览器版本筛了一下报错,再按三个维度逐层收窄:浏览器及版本、页面 URL、错误堆栈。这三个维度不是并列看一眼,而是层层相交:先圈浏览器版本,再在这个圈里看页面,最后看堆栈。收敛后样本才足够小、足够具体,才值得打开 DevTools 去复现。
1. 浏览器及版本:先看是不是某内核版本引入
先说清采集参数,避免一个常见误会:window.onerror 的回调签名是 (message, source, lineno, colno, error),对应报错信息、源码 URL、行号、列号和 Error 对象——并不是“第一个参数就是 UA”。真正的 UA(用户代理字符串)并不在这个签名里,需要监控脚本另外从 navigator.userAgent 读取,再解析成浏览器与版本号。把版本分布拉出来看一眼,异常往往立刻现出原形:错误是不是集中在某一个版本号上,是不是和该版本的灰度放量时间对齐。报错从 09:20 抬头、新版本灰度也从 09:20 放量——时间一对上,方向就基本锁定。
2. 页面 URL:再看是不是某条路由在错
锁定浏览器版本之后,把样本按页面 URL 聚合。同一段脚本会在很多页面运行,报错通常只集中在某一个路由或 H5 页面上。按页面收敛后,绝大部分报错其实挤在结算页一个页面,其余只是零星波及。这一步把排查面从“全站”压回到“一个页面”。
3. 错误堆栈:最后看是不是同一段代码
同一种报错会被记成很多条日志,却未必是同一处问题。要按 error.stack 做指纹聚类:把堆栈前几帧相同的样本归成一类。收敛后只剩两三类堆栈,说明问题集中在一两段代码;仍是几十种零散堆栈,更像随机的第三方脚本或浏览器扩展注入,方向又要换。
| 下钻维度 | 这一步看什么 | 能排除什么 | 它不做什么 |
|---|---|---|---|
| 浏览器及版本 | 错误在各浏览器版本上的分布与发布时间对齐 | 排除全站发布问题,锁定是否单一内核版本引入 | 不判断是哪个 API 不兼容 |
| 页面 URL | 报错在各路由 / H5 页面上的聚合计数 | 排除无关页面,把范围压到少数页面 | 不指出页面里哪段脚本 |
| 错误堆栈 | 按 error.stack 前几帧指纹聚类 | 区分是一两处代码问题还是多处零散报错 | 不自动映射回源码行号 |
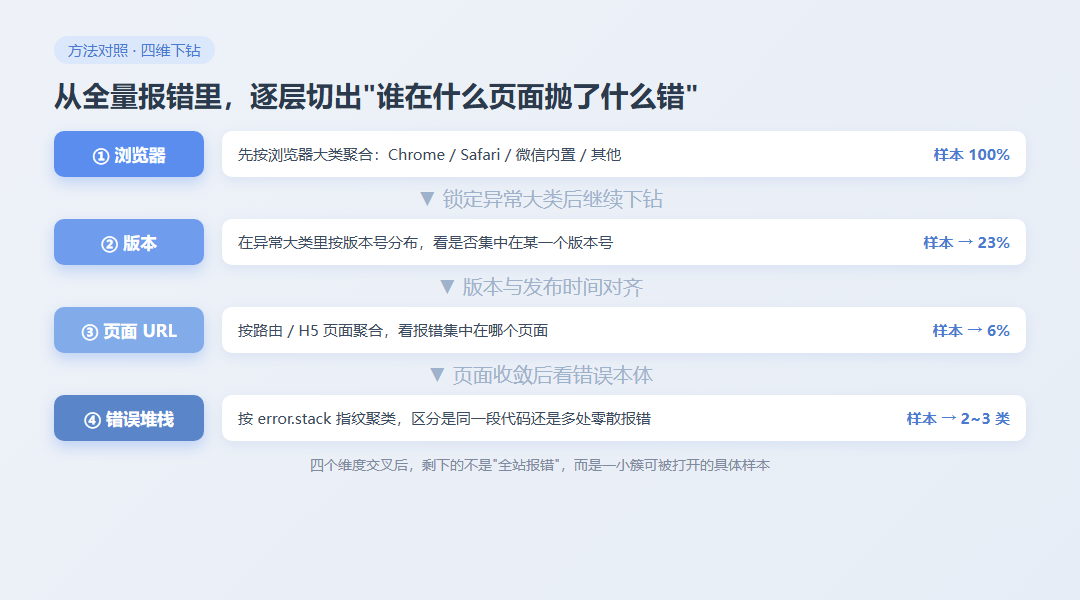 四个维度逐层相交,样本从全量收敛到一小簇具体问题
三、这些数据到底是怎么被采上来的
有必要把采集机制讲清楚,否则容易对监控能力产生误会。前端 JS 错误主要靠两类全局事件捕获:window.onerror 捕获运行时同步抛出的错误,unhandledrejection 捕获没有被 catch 的 Promise 拒绝,回调里主要提供 promise 对象与 reason。之所以要同时监听两者,是因为现代前端大量逻辑是异步的,只挂 window.onerror 会漏掉相当一部分 Promise 报错。还要强调:UA 并不在这两个回调的参数里,得由监控脚本自己从 navigator.userAgent 读取,连同报错信息、页面 URL 与时间戳一并上报。
| 捕获方式 | 能抓到什么 | 抓不到什么 |
|---|---|---|
| window.onerror | 同步运行时错误、语法错误、资源加载异常的回调入口 | 未被 catch 的 Promise 拒绝 |
| unhandledrejection | 异步 Promise 里没有捕获的 rejection 原因 | 已经被 try/catch 或 .catch 处理掉的错误 |
这里要特别说清楚 sourcemap。线上代码经过压缩混淆,error.stack 里的行列号指向压缩后的文件,没法直接读。要在构建产物发布后把 sourcemap 放到离线环境,用专门工具把压缩堆栈映射回源码行号。这一步离线、由研发自己完成;平台不会、也不该自动把源码上传到服务端还原。理解这点很重要——它决定了你不能指望监控平台直接告诉你“第几行第几列出错”。
还要提醒一点:UA 解析本身并不完美。很多内置浏览器和 WebView 会在 UA 里混入自己的标识,同一款 App 不同版本的 UA 格式还会变;按版本下钻时,不妨把命中特别小、明显是解析噪音的版本先忽略,否则会在边角样本上浪费注意力。
四、缩小范围之后,剩下的事交给 Chrome DevTools
到这一步,监控能做的已经做完了:它把“全站报错”收敛成“某个浏览器版本、某个页面、某类堆栈”的一小簇样本。但根因到底是什么——是某个新 API 在该版本不存在,还是某个变量在特定内核下为 undefined——监控曲线本身回答不了。因为这类问题依赖实时断点、作用域查看和在那个具体浏览器里的复现,剩下的工作要在真实目标环境里完成:在目标浏览器/版本、远程真机或浏览器云(如 BrowserStack)里打开那个页面,在堆栈指向的位置下断点,看变量在哪一步变了。这里有个误区:不要在 DevTools 里把 UA 字符串切成目标版本来复现——UA 覆盖只改了上报给服务端的 User-Agent,并不改变 Chrome 自身的内核与 JS 引擎实现,用它复现内核级错误只会得到假复现。DevTools 的 UA 模拟只适合测“服务端按 UA 分流内容”,不能用来复现内核差异导致的错误。
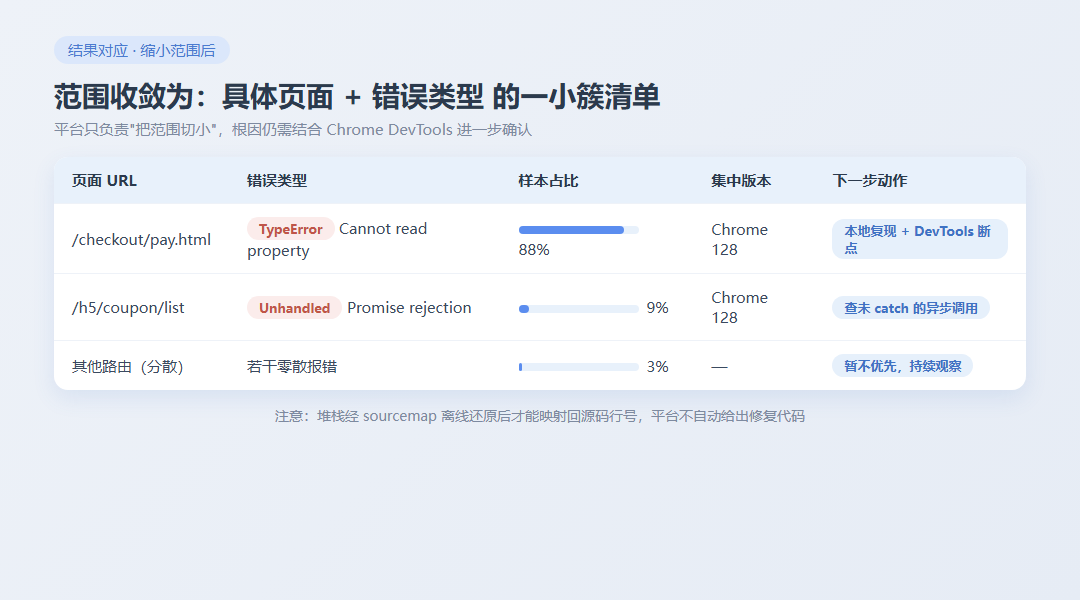 范围收敛为具体页面与错误类型的清单,根因仍需 DevTools 确认
三种前端报错采集方式的差异
这套按浏览器版本、页面 URL、错误堆栈三层下钻的做法,落到工具上通常有三条路:自己写 window.onerror 采集脚本、用浏览器自带的 DevTools 或性能面板、用第三方前端监控平台。三者在接入成本、去重口径、跨端统一、实时性和维护成本上的差别如下表。
| 对比维度 | 自建JS监控脚本 | 浏览器后台/性能面板 | 前端监控平台 |
|---|---|---|---|
| 接入成本 | 要自己挂 window.onerror 与 unhandledrejection,再写上报、接收端和存储 | DevTools 本地打开即可,零接入,但只反映你这台机器 | 嵌一段监控 SDK,按文档配好上报地址即可,UA 自动解析成浏览器与版本 |
| 去重口径 | 同一错误按 error.stack 算指纹的逻辑得自己写,指纹算漏了日志就刷屏 | 面板按单条错误逐条列,不做跨用户聚类,刷不刷屏它不管 | 同一错误按堆栈指纹自动聚合去重、合并计数,避免同一条报错刷屏(指纹与合并规则以产品文档/后台为准) |
| 跨端统一 | Web、内嵌 H5、小程序的报错要分别采,浏览器与设备维度得自己归并 | 只能看当前浏览器,拿不到版本与设备分布 | 浏览器/版本/设备维度统一上报,错误堆栈可按浏览器和设备下钻(是否覆盖 App 内嵌 H5 以产品文档/后台为准) |
| 实时性 | 取决于自己的上报链路与存储,通常延迟几分钟到 T+1 | 本地实时,但只对当前开发者可见 | 控制台刷新频率(如分钟级)与可下钻时间范围以产品文档/后台为准,报错高峰当天可下钻 |
| 维护成本 | SDK 升级、UA 解析、sourcemap 还原、堆栈聚合与告警规则都要自己扛 | 零维护,真实用户侧的报错分布它看不见 | 堆栈聚合与采集由平台负责,告警规则可自行配置,sourcemap 还原仍由研发离线完成(以产品文档/后台为准) |
常见追问
Q:window.onerror能捕获所有JS错误吗?
A:不能。它只能捕获同步执行中的错误。Promise未捕获的rejection需要监听unhandledrejection事件,资源加载错误需要在标签上监听error事件并设capture。
Q:线上JS错误怎么复现?
A:先看错误的浏览器版本和设备型号,在真实浏览器或远程设备上复现。Chrome DevTools的UA切换只改变请求头,不改变渲染引擎,不能用来复现浏览器兼容性问题。
Q:错误堆栈压缩了怎么办?
A:需要sourcemap。构建时生成sourcemap文件,部署时把sourcemap上传到监控平台,监控平台会自动把压缩后的堆栈映射回原始源码位置。具体支持情况以产品文档为准。
五、为什么选用456数据
四维下钻跑完一遍,你会发现能不能自动聚合错误堆栈才是工具分水岭。先按浏览器及版本切出异常簇、再按页面 URL 收敛、最后按堆栈指纹聚类,在控制台里分别对应按 UA 筛选、按页面聚合与堆栈指纹聚类——不用自己写采集脚本搭存储,切两下就能把“全站报错”收敛成“某个版本、某个页面、某类堆栈”的一小簇样本。其中各版本(免费版/基础版/专业版)具体开放哪些能力、是否覆盖 App 与小程序的前端监控,以产品官网与后台套餐说明为准。如果你们已经在用自建 JS 监控脚本,对比上面这张表的五项差异再决定;浏览器 DevTools 性能面板能覆盖的场景,也没有必要额外接一套监控。