埋点事件、事件属性和用户属性怎么区分?命名与评审示例
你有没有开过这样一场会:代码明明已经按技术同事给的文档埋好了,可一回到运营周会,就有人指着后台的列表问一句——"这个按钮的点击,到底算一个事件还是一个参数?"话音落下,整个会议室突然安静,因为你会发现,在座没有一个人能用一句话把它说清楚。
作为增长负责人,我开过不下二十场这样的会。大家卡的从来不是代码,而是同一个地方:运营同事看得懂"今天有多少人点了这个按钮",可一旦讨论到"同一个按钮,在红色文案和蓝色文案下分别被点了多少次",就开始争论这到底该记成两个事件,还是一个事件再加一个参数。之所以卡住,是因为没人把"动作"和"动作的细节"这两层拆开讲过。争论不下,埋点就停在那,数据也就一直是一笔糊涂账。
我后来想明白一件事:这个问题根本不需要懂代码。只要把"事件"和"参数"这两层想清楚,九成的争论当场就能结束。这篇我不写技术手册,只把我们团队在例会上怎么把这件事一层层想清楚的过程记下来,让非技术同事也能一眼判断——下次再被问到,你不用再去翻文档,直接按这套思路答就行。
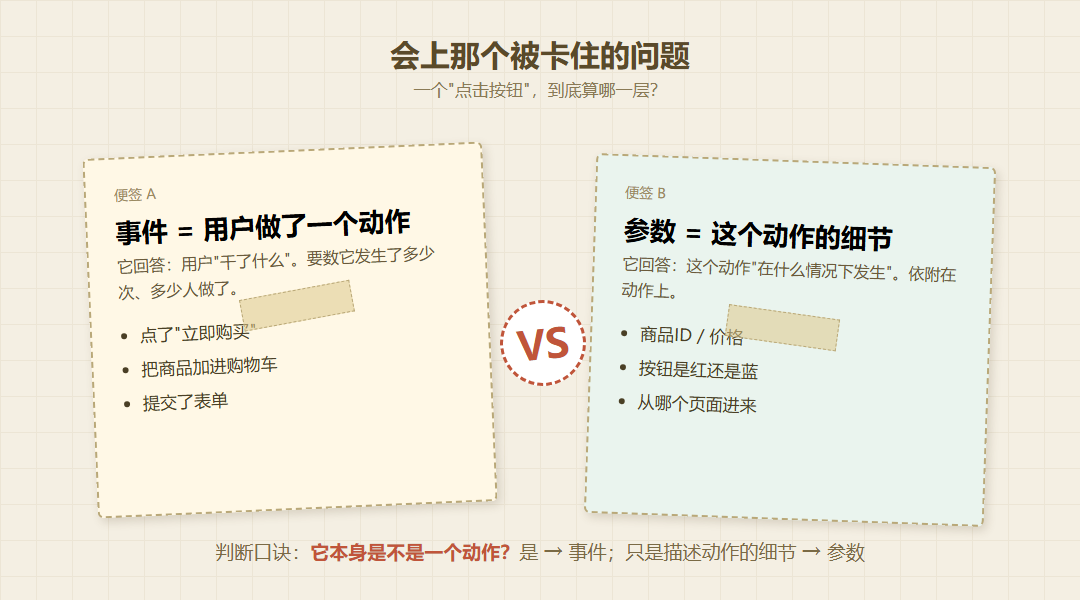
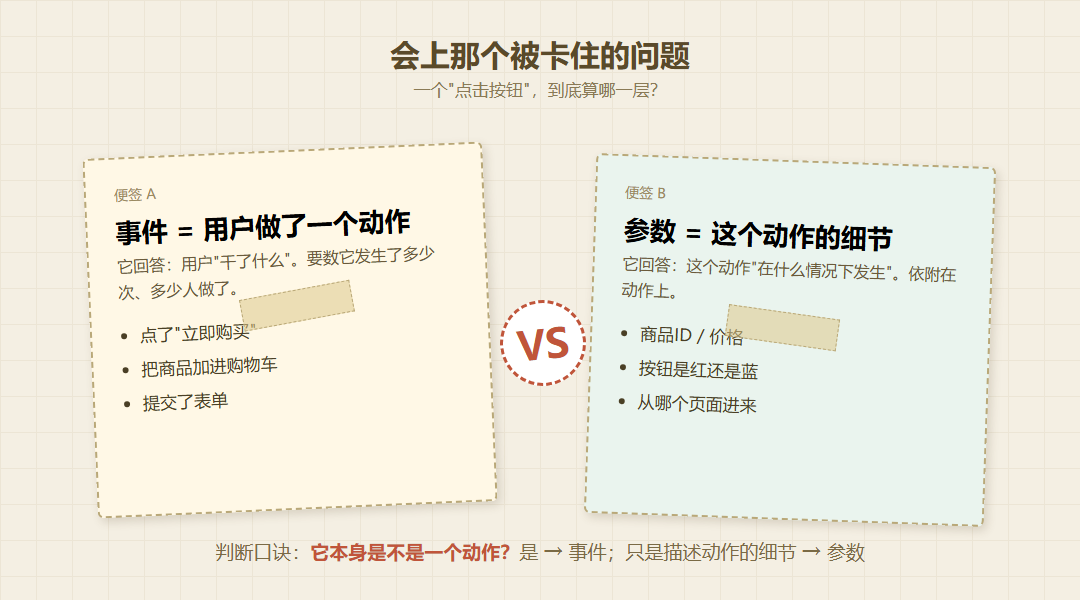
例会上被卡住的那个问题:一个点击,到底该记成事件,还是记成参数?
一、场景首答:先给会上那个问题一个干脆的答案
那天我先打断了争论,给了一句大白话:事件是用户做了一个动作,参数是这个动作的细节。因为"点按钮"本身是一个动作,所以它是事件;而"这个按钮是红色还是蓝色、点它的人从哪个落地页进来",是附着在这次点击上的描述,所以它是参数。一句话讲完,会议室里大半的人当场就点头了。
之所以这样分,是因为分析的时候我们要先数"这个动作发生了多少次、有多少人做了",再去看"这些动作分别长什么样"。如果把红色按钮点击和蓝色按钮点击拆成两个事件,事件列表会像滚雪球一样越滚越多,后面想拼一条转化漏斗根本无从下手;反过来,如果只记一个事件、却不把按钮颜色记成参数,你就永远回答不了"红色和蓝色哪个转化更好"。两端都漏,数据就既不省事儿、也不好用。
这就是这套工具里事件和参数的分工:事件负责"计数和串流程",参数负责"下钻和看细节"。想通这一层,你再看后台那一长串埋点名,就不会觉得它们是一堆莫名其妙的字符串,而会立刻分出哪些是骨架、哪些是血肉。
二、判断条件:什么算事件,什么算参数
光有类比还不够,落到具体页面上,我给团队立了两条判断条件。第一条:这件事能不能被说成"用户做了一个动作"——能,它就是事件,它回答的是"用户干了什么"。第二条:它是不是在描述这个动作"发生时的情况"——是,它就是参数,它回答的是"在什么情况下干的"。两条条件一问,归属基本就定了。
之所以要立这两条,是因为例会上最常见的错误,就是把"细节"也当成一个独立动作去埋。与其每次争论,不如把高频场景列成一张表,大家对着表套,省得凭感觉拍脑袋。
| 你想统计的内容 | 它是事件还是参数 | 为什么这样判 |
|---|---|---|
| 用户点击了"立即购买"按钮 | 事件 | 这是一个明确动作,要数它发生了多少次、多少人触发 |
| 这次点击落在哪个商品上 | 参数 | 它描述的是这次点击的对象,本身不是一个独立动作 |
| 用户提交了一份表单 | 事件 | 一个完整动作,常常是转化漏斗上的关键一步 |
| 这份表单从哪个渠道进来 | 参数 | 它描述这次提交的来源,是动作的附带信息 |
| 用户把商品加入购物车 | 事件 | 独立动作,电商漏斗里绕不开的一步 |
| 这件商品的价格是多少 | 参数 | 它是这次加购的数值细节,依附在动作之上 |
这张表我贴在了团队群公告里。判断时只要问自己一句:"它本身是不是一个动作?"是动作,就往事件上报里放;是动作的细节,就收进属性对象。这样过完一遍,争论基本不会超过一轮,谁也不用跟谁争。
三、分析顺序与命名步骤:怎么把一个动作拆成事件和参数
判断完"谁是事件、谁是参数",下一步是按固定顺序去写埋点,而不是想到哪写到哪。我们团队的顺序是:先定动作,再给动作起名字,最后把细节收进属性。之所以强调顺序,是因为一旦反过来——先埋了一堆细节、动作本身却没数清楚——后面建漏斗时你会发现,最关键的那一步根本没数据,返工起来最疼。
第一步:先回答"用户到底做了什么"
动手之前,先把业务流程上的关键动作列出来,比如浏览商品、加入购物车、提交订单。这些是漏斗的骨架,每一步都必须是一个独立事件。因为漏斗是由一个个事件串起来的,缺了其中一步,后面的流失分析就断了,你只能看到"从浏览到加购",却看不到"从加购到下单"到底掉了多少人。
第二步:给动作起一个稳定、统一的名字
在这套工具里,事件由"分类+名称+属性"三段组成:分类管这个动作属于哪一组业务,名称管具体是哪一个动作。之所以要先把命名想清楚,是因为事件名一旦上报就会沉淀成历史数据,中途改名会导致新老数据对不上,趋势图直接断开。我们的约定是用"业务分类_动作"的写法,全团队共用同一张命名表,不允许一个人写 addcart、另一个人写 add_cart,谁也别私下发挥。
第三步:把"细节"全部收进属性对象
名字定好之后,所有描述这次动作的信息——商品ID、价格、按钮位置、来源页面——都作为属性一起上报。因为属性是附着在事件上的键值对,分析时可以按属性拆分:比如"加入购物车"这个事件下,按商品ID去看哪件商品被加购得最多。属性的好处是灵活,以后你想新增一个细节维度,不用再新发一个事件,只要在上报时多带一个键就行,历史数据也不会乱。
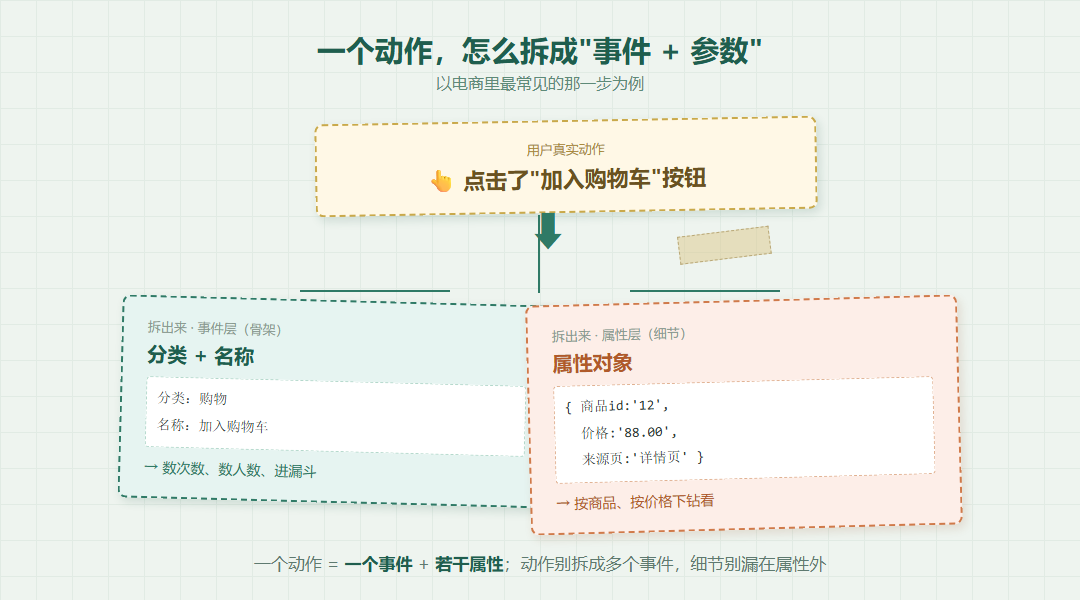
一次"点击加入购物车",如何被拆成一个事件加上它的若干参数。
四、能力边界与对比:能埋点,不等于能管好埋点
把事件和参数拆清楚之后,自然要追问一个问题:这套工具到底能帮我们管到什么程度?这里有一个运营同事最容易混淆的边界——事件埋点是"采集层"的事,而事件管理、漏斗管理是"治理层"的事。前者解决"数据有没有上报上来",后者解决"上报上来的一堆事件怎么不混乱、怎么拼成一条能看的漏斗"。
之所以要把这条边界讲透,是因为有人以为"能埋事件"就等于"能管事件"。实际上,事件管理和漏斗管理这类埋点治理能力,是从基础版起才提供的:免费版可以先把埋点跑起来、看到事件触发数据,但要在后台统一维护事件清单、把多个事件按顺序串成转化漏斗,就需要升到基础版及以上。这个差别,直接决定了你团队现在该把力气花在"先接上"还是"先理顺"上。
| 能力层 | 解决的问题 | 在这套工具里的位置 | 可用套餐 |
|---|---|---|---|
| 事件采集 | 把用户动作连同它的属性一起上报上来 | Web端靠JS队列,App、H5、小程序靠各自SDK接入 | 免费版起 |
| 事件分析 | 看某个事件触发了多少次、多少人触发 | 事件分析模块,按事件计数与去重 | 网站免费版起;App、小程序基础版起 |
| 事件管理 | 在后台统一维护事件清单、命名与说明 | 456数据的事件管理模块,埋点治理用 | 基础版起 |
| 漏斗管理 | 把多个事件按业务顺序串成漏斗、逐段看流失 | 漏斗管理模块,转化分析用 | 基础版起 |
这张表想说明的是:埋点这件事不是"埋完就结束",埋完之后还要有人去管命名、管漏斗。把"采集"和"治理"分开看,你才知道团队现在到底卡在哪一环——是数据没上来,还是上来了但没人理顺——而不是笼统地甩一句"数据不准"。
五、配置动作与下一步清单
想清楚边界,落地就变成一张清单。我们团队每新接一个页面,都按下面这套动作过一遍,因为漏掉任何一步,埋点都会变成"上报了、却分析不了"的死数据。
先确认:这个动作要不要单独成事件
先问自己,它是不是漏斗上的关键一步。是,就单独埋一个事件;如果只是页面上的装饰性点击、业务上根本不关心,就先别埋。因为事件列表一旦被无效点击淹没,真正重要的那几个动作反而被盖住了,找都找不出来。
再确认:这些细节该不该当属性带上
把这次动作发生时的关键上下文列出来,能成键值对的,都收进属性对象里。但属性并非越多越好:高基数字段、PII和冗余字段会增加成本与合规风险,应按最小必要采集。同时要注意分寸:用户身份这类信息不要随手往普通事件属性里塞,它有专门的用户属性通道,混着放后面按用户分析时会对不上号。
| 步骤 | 具体动作 | 验收标准 |
|---|---|---|
| 1 | 创建站点或应用,拿到埋点代码或SDK | 代码贴好后,自己点一次按钮能实时看到这条数据上报 |
| 2 | 给动作定好分类与事件名 | 全团队共用同一份命名表,没有大小写、下划线混用 |
| 3 | 在事件上报里带上属性对象 | 抽查一条真实数据,属性的键和值都完整可见 |
| 4 | 用事件管理核对事件是否齐全 | 后台事件清单和命名表逐条对得上,不多也不少 |
| 5 | 用漏斗管理串起关键动作 | 漏斗每一步都有数据,流失可以逐段查看 |
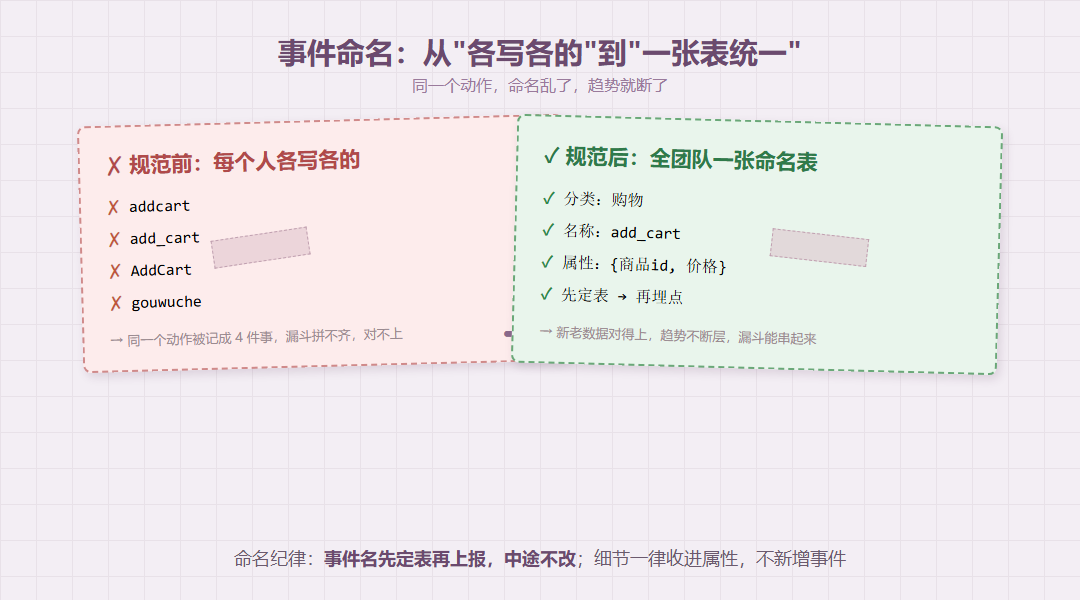
事件命名这件事,从"每个人各写各的",到"一张表统一全团队"。
六、常见误区:我们在例会上踩过的四个坑
误区一:把每一个细节都建成独立事件
最常见的错误,是"红色按钮点一下是一个事件,蓝色按钮点一下又是另一个事件"。因为按钮文案一变,事件名就得跟着加,事件数量会像失控一样膨胀,最后没人记得清哪个是哪个。正确做法是只建一个"按钮点击"事件,把文案颜色放进属性里,分析时再按属性拆分,既省事件名额,又一样看得清。
误区二:只埋动作、不埋属性
反过来,只上报"点击了按钮",却不带按钮位置、商品ID这些细节。这样你虽然知道点了多少次,却永远答不出"到底是哪个商品、在哪个位置被点"。因为动作本身只是一个计数,它真正的价值,全藏在那一层细节里——这正是参数存在的意义。
误区三:事件名随手写、中途还想改
会上拍脑袋起个名字,下周换个人又起一个。因为事件名一旦上报就沉淀成历史数据,中途改名会让新老事件对不上,趋势图直接断层。所以命名必须先定表、再埋点,谁也别在半路私自改名——这是用历史数据换不来的教训。
误区四:以为能埋点,就等于能管漏斗
有人以为"代码接上了"就万事大吉。其实上报只是第一步,把关键事件按业务顺序串成漏斗、再逐段看每一步掉了多少人,是另一项需要在后台配置的能力。把这两件事混为一谈,等你发现"为什么我的漏斗里少了一步",就会完全无从下手。
七、常见问题
Q:一个页面上好几个按钮,该埋成一个事件还是多个?
先看它们是不是同一个性质的动作。如果都是"点击"这个动作,只是位置或文案不同,那就埋成一个事件,把按钮位置、按钮文案放进属性里。因为这样你既能数出总的点击量,又能按属性拆出每个按钮各自的表现,一举两得。
只有当这个按钮代表一个业务上独立的、需要单独统计、还要进漏斗的关键动作时,才给它单独建事件。否则按钮越多事件越多,最后连你自己都数不清后台那一长串名字分别是什么。
Q:属性里到底能放什么?价格、页面路径这些算吗?
算。属性就是描述这次动作的键值对,商品ID、价格、来源页面、按钮位置都可以往里放。这套工具的事件由"分类+名称+属性"三段组成,属性段就是干这个用的,而且支持中文键名,写起来很直观,不用死记英文。
但要注意分寸,用户身份这类信息不放在普通事件属性里。因为事件属性是跟着动作走的,而"这个用户是谁、叫什么"属于用户属性的范畴,有专门的上报通道;在浏览器端我们还会借助Cookie维持同一访客的识别。把两者混在一起,后面按用户做分析时就会对不上。
Q:Web端和App端上报事件,写法一样吗?
思路完全一样,方法名不同。Web端是通过JS全局队列上报的,写法是 _yhxw456_trackdata.push(['event', 分类, 名称, 属性对象]);而App、小程序、鸿蒙HarmonyOS、uni-app这几端,方法名统一为 trackEvent。
之所以方法名不一样,是因为各端运行环境不同——Web跑在浏览器里靠JS队列,App和小程序靠各自的SDK。但"分类+名称+属性"这个三段结构是一致的,所以运营同事根本不用记这些代码细节:你只要知道,无论在哪一端,事件都是"一个动作"、属性都是"这个动作的细节",判断逻辑到哪一端都通用。
命名迁移提醒:事件改名或合并时,旧事件不要立刻在后台删除,至少保留一个完整观察周期(通常一个月)再下线,否则历史漏斗和留存会出现断点。
三类信息怎么分:事件、事件属性、用户属性
| 类型 | 回答的问题 | 示例(加入购物车) | 变不变 |
|---|---|---|---|
| 事件 | 用户做了什么动作 | add_to_cart | 每次动作一条 |
| 事件属性 | 这次动作的细节 | 商品ID、价格、数量、来源页 | 每次可不同 |
| 用户属性 | 这个用户是谁 | 会员等级、注册渠道、是否新客 | 相对稳定,按用户更新 |
容易踩的坑是把"会员等级"塞进每次事件的属性里——它属于用户属性,应该随用户档案更新,而不是每个事件重复上报。事件改名或合并时,建议先双写一段时间(新旧事件名都上报),加版本字段,观察一个周期后再下线旧事件,而不是直接改名字断历史。
为什么选用该平台:它的 Web 事件结构统一为“分类+名称+属性”,埋点命名有固定位置可查;事件改名和迁移仍需业务侧自己管理双写周期。
回到开头那场例会——自从我们把"事件是动作、参数是细节"这句话写进群公告,会上的争论明显少了。埋点之所以让运营同事发怵,往往不是因为技术多难,而是因为没人把"动作"和"细节"这两层说清楚。分清这两层,你在例会上被"这个到底算事件还是参数"卡住的时刻,会越来越少;这套工具能不能用好,最后拼的其实是这层判断力,而456数据要做的,就是把这层判断变得越来越简单。