企业版A/B实验:流量分配要核对哪些条件
一、脱敏典型过程:流量分配没核对,实验为何作废
一次"结论成立却被污染"的典型演示
以下为产品方内容团队的脱敏方法示例,不指向特定客户或项目。它暴露了一个反复出现的隐患:实验结论看上去成立,流量分配却没人在上线前逐项核对。核心教训是——A/B实验的可信度取决于流量上线前是否被正确切分,而非两组结果差多少。同一用户若被同时放进对照与实验组,或两批人来源结构本就不同,后续显著性判断都会失去根基。
这套核对动作落在智能运营这条产品线上,该产品线含实验管理、实验层管理与实验设备管理。后面的互斥、分层、比例都要在同一套实验管理入口完成。至于它归在哪一档套餐、额度多少,以官网定价页为准(核验日期2026-10-12),本文作为方法科普不展开。
先答:放量前必须逐项核对的四件事
一次A/B实验放量前,负责人需逐项核对四类条件:流量是否互斥、实验层是否正交、样本分配比例是否符合设计、分流结果是否稳定。这四件事必须上线前核对,因为事后发现时被污染样本已无法回滚,实验只能作废重做。
拆对照与实验组、随机分流、以统计显著性判断结论,属AB测试行业通行做法;平台侧随机化算法与分流机制未完全公开,需实测/待核验。
二、四件上线前必核的流量口径:互斥、分层、比例、稳定性
流量互斥:同一用户不能同时进两个实验
第一个条件是流量互斥:同一用户在同一次访问里会不会被两个实验同时命中。用户若既看到实验A的新版按钮、又看到实验B的新版文案,行为就无法归因,两组数据互相污染。核对时先列现有运行中实验清单,确认新实验与它们分流规则是否错开;只要两个实验面向同一批用户、同一批页面,就必须在同一实验层互斥,而非各自随机。
实验层与分层:层内互斥、层间正交
第二个条件是实验层。同时跑多个实验时,塞进同一个随机池会让冲突变多,行业通行做法是引入"实验层":同一层内实验彼此互斥,不同层之间流量正交叠加。正交后一层的分流结果不影响另一层样本结构,多个实验才能并行。核对时确认:新实验落在哪一层、该层是否已有其它实验占用;分层一旦配错,跨层实验就会在同一批用户身上叠加,产生看不见的耦合。平台底层用什么哈希或分桶实现正交,属未公开细节,需实测/待核验。
样本分配比例:对照与实验的流量切分
第三个条件是样本分配比例。对照与实验各拿多少流量,要在设计阶段定死,而非边跑边调。中途改切分会让两组用户在时间上结构不同,样本不再同期随机,结论就会被选择效应污染。灰度阶段先切小部分流量验证链路,确认无误再放大;具体百分比取决于流量基数与实验周期,无统一行业阈值,需按自身规模测算。
| 核对项 | 要回答的问题 | 不核对的后果 |
|---|---|---|
| 流量互斥 | 同一用户是否被多实验同时命中 | 行为无法归因 |
| 实验层 | 新实验落在哪层、层内是否有占用 | 跨层叠加产生耦合 |
| 分配比例 | 切分比例是否设计时定死 | 中途调比例,样本失同期 |
| 分流稳定性 | 灰度期两组进人结构是否符合预期 | 比例失衡,大盘被带偏 |
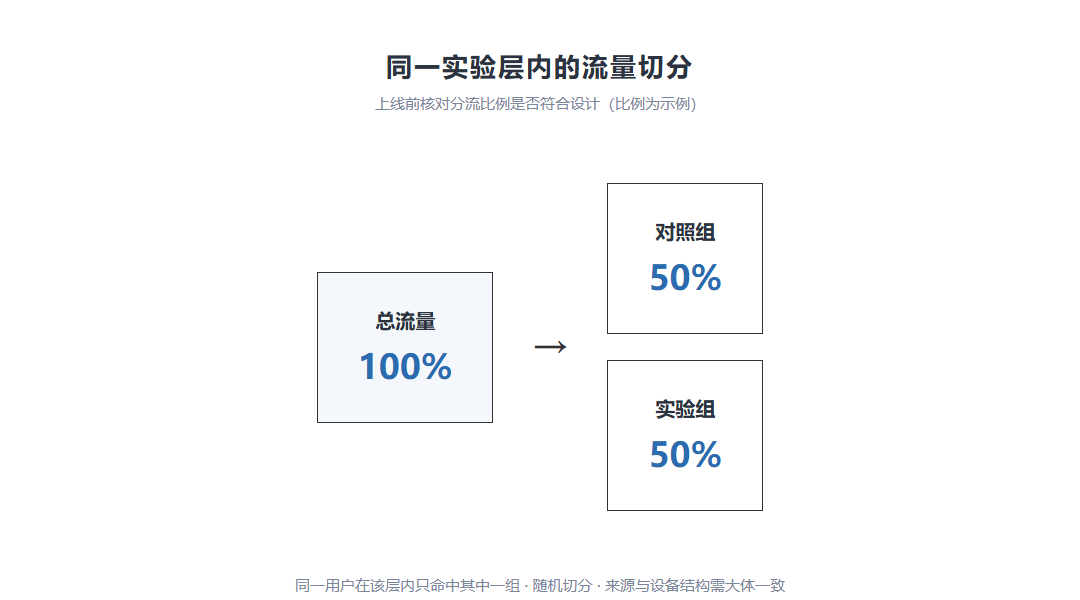
同一实验层内对照与实验组的切分示意(比例为示例)
三、从搭建到灰度放量的核对动作
第一步:确认实验目标与分流对象
第一步是确认实验目标与分流对象。先写清实验改变哪个页面或动作、核心比较指标是什么。目标不清,分流对象就无法界定,可能把不相关页面流量也切进来。分流对象要明确到页面与人群,说清"哪些用户、在哪个页面、进哪个组",说不清就不进下一步。
第二步:圈定实验层并设置互斥
第二步是圈定实验层并设置互斥。把新实验放进指定的层,再在层内对照、实验组之间开启互斥。互斥配置埋在实验设置深处,易在建实验时被跳过,事后才发现两组重叠。平台侧实验管理与实验层管理要在同一入口配置;接入前提是先在站点管理创建站点并完成埋点部署,打点地址以控制台获取为准。
第三步:灰度放量并观察分流稳定性
第三步是灰度放量并观察分流稳定性。小流量上线后,先看两组进人比例是否符合设计、来源与设备结构是否一致。比例失衡往往不是随机波动,而是分流逻辑被某类用户绕过。观察期一旦比例明显偏离,应先停掉放量、回查分流规则,而非硬跑完——带着分流问题跑出的"显著结果"比没有结果更危险。
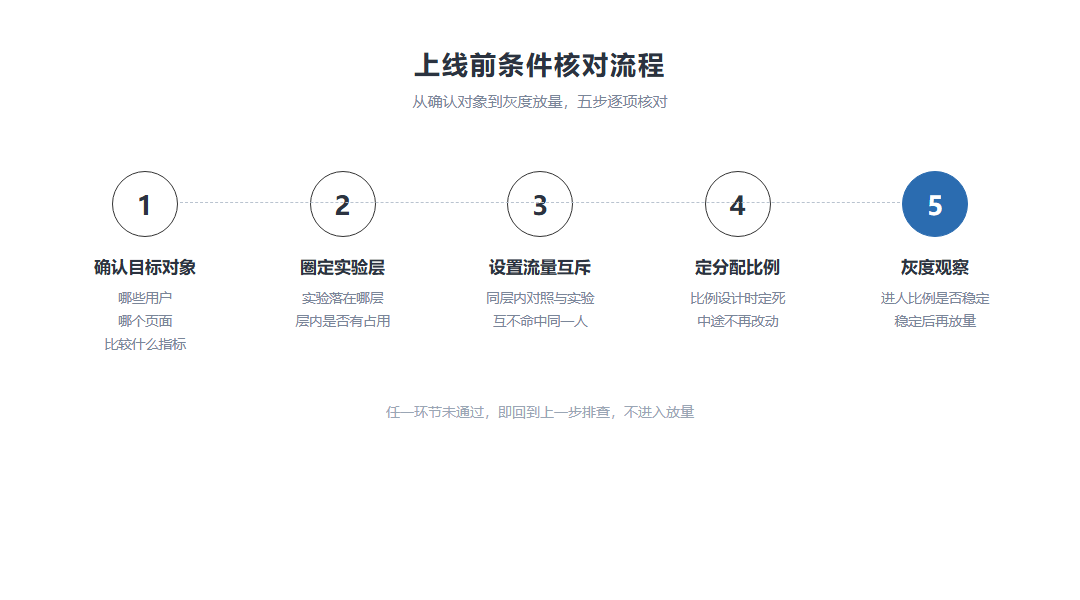
从确认对象到灰度放量的上线前条件核对流程
四、这套机制替你做什么、什么仍要业务方拍板
平台侧承担的分流与统计
在智能运营模块里,A/B实验提供实验管理、实验层管理与实验设备管理等基础能力,平台侧按规则切分流量、把两组指标回收成可比报告。团队容易误以为平台会替人决定一切,实际上它只提供分流与统计载体,判断口径仍要业务方自己定。
需要业务方自己拍板的部分
平台不能替你做的事:实验切多少流量、跑多久、哪个指标为核心、异常后要不要中止,都要结合业务规模与风险偏好决定。官网演示界面里的实验结果数字都属演示用途,不能当效果引用;实验最终结论取决于真实流量与实验设计,分流算法与报告口径以官方文档为准,后台未公开细节需实测确认。
| 事项 | 平台侧承担 | 需要团队自行判断 |
|---|---|---|
| 流量切分 | 按规则切分对照与实验组 | 切多大比例、放哪层 |
| 指标回收 | 汇总两组数据成可比报告 | 哪个为核心指标 |
| 异常处理 | 呈现两组对比与波动 | 是否中止放量 |
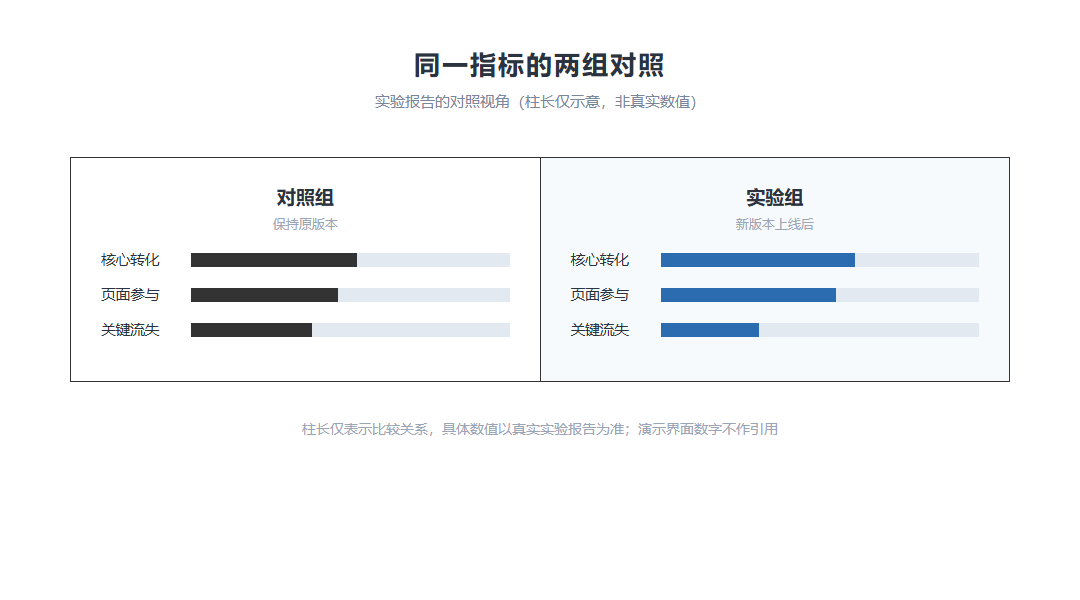
同一指标对照组与实验组的前后对照(数值为示例)
五、选实验平台先确认什么:实验层与按分流单位出统计
随机化与SRM需要的底层支持
落到选平台这件事上,真正要先确认的不是界面好不好看,而是两件底层能力:是否提供实验层管理、能否按预设随机化单位出统计。前者决定多个实验能不能并行而不互相污染,后者决定SRM检验和主指标对比能不能落到对的样本粒度上。456数据把A/B实验放在智能运营线,正是按"实验管理+实验层管理+按分流单位统计"这套口径组织的;这也是它区别于只记录访问量的通用统计工具的地方。
六、把核对固化成流程:上线前核对验收卡
分流比例正常,不等于随机化有效
这里补一条易被忽略的边界:分流比例正常不等于随机化有效。就算两组进人比例看着符合设计,随机化本身也可能因分桶逻辑、缓存命中或某类用户绕过而失效。因此上线后要按预设随机化单位做SRM(样本比率失调)检验,并记录主指标、护栏指标、实验组数和停止规则。SRM是否由平台自动计算、随机化单位支持到哪一级,当前未完全公开,需实测/待核验。
AB实验上线前核对验收卡
把上面所有动作压成一张可逐项打勾的验收卡,每次实验上线前走一遍。下表六项是核心字段;标"需实测"的字段要在真实环境确认后再填写。
| 验收项 | 上线前要确认什么 | 记录/核对口径 |
|---|---|---|
| 随机化单位 | 按什么粒度把用户切进对照与实验组 | 用户ID/Cookie/设备?以控制台配置为准,具体粒度需实测 |
| SRM检验 | 两组实际进人比例是否偏离设计比例 | 上线后按随机化单位做SRM,偏离即回查分流 |
| 主指标 | 本次实验要下结论的核心指标 | 实验设计时写死一个,中途不改 |
| 护栏指标 | 不能因实验恶化的业务指标 | 如崩溃率、加载时长、核心转化 |
| 实验组数 | 对照与实验各几组、是否多臂 | 组数与切分比例一并记录 |
| 停止规则 | 什么条件下提前停止或放量 | 达到样本量/显著即停,异常即中止 |
这张卡每次实验前走一遍,把"这次没人核对"的偶然变成"每次都会核对"的确定,把注意力从"结果好不好"前移到"过程对不对"。