A/B测试案例怎么转成产品验证场景?假设指标对象验收四要素
一篇漂亮的 A/B 测试案例摆在你面前,转化率、留存率写得清清楚楚,你第一反应通常是:能不能直接照搬到自己产品上。因为别人的数字看着很有说服力,所以这种冲动很正常。但直接照搬几乎一定会翻车——不是因为案例造假,而是因为它解决的问题、用户群和指标优先级,跟你的根本不是一回事。
一个稳妥的做法是:看到案例先不动手,而是把它拆成四个要素——假设、指标、实验对象、验收条件。这四件事想清楚,实验才是在验证你自己的问题,而不是在复刻别人的结果。A/B 实验这类能力通常放在智能运营模块里,常见做法是把实验的指标配置和分流说明公开在模块文档中,正好对应这种“先转要素、再开实验”的做法。下文就按这四步,把一个陌生案例一步步转成你自己能落地的验证场景。
一、一篇案例摆在面前,照搬还是转验证
先承认这个纠结很真实。因为案例里的数字确实诱人,所以你会忍不住想“我们是不是也这么改一版”。但真正要问的不是“能不能照搬”,而是“它验证的那个问题,是不是我现在要解决的”。问题对不上,数字再漂亮也和你无关。
很多团队之所以照搬后失望,不是执行力差,而是从一开始就把“别人验证过的结论”误当成了“对自己也成立的结论”。因为用户群、使用场景、产品阶段都不同,所以同一套改动在不同产品上的效果本就可能天差地别。想通这一点,你就不会再急着复刻界面,而是先去拆解它背后的问题。
照搬案例最容易踩的坑
照搬最常见的坑,是只抄了改动、没抄上下文。别人把按钮从蓝改绿提升了点击,背后可能是他们的用户对蓝色已经视觉疲劳、而你的用户还没见过这个按钮。因为脱离了上下文,所以同一个改动在你这里可能毫无效果,甚至起反作用。这也是为什么要先把案例拆成要素,而不是直接复刻界面。
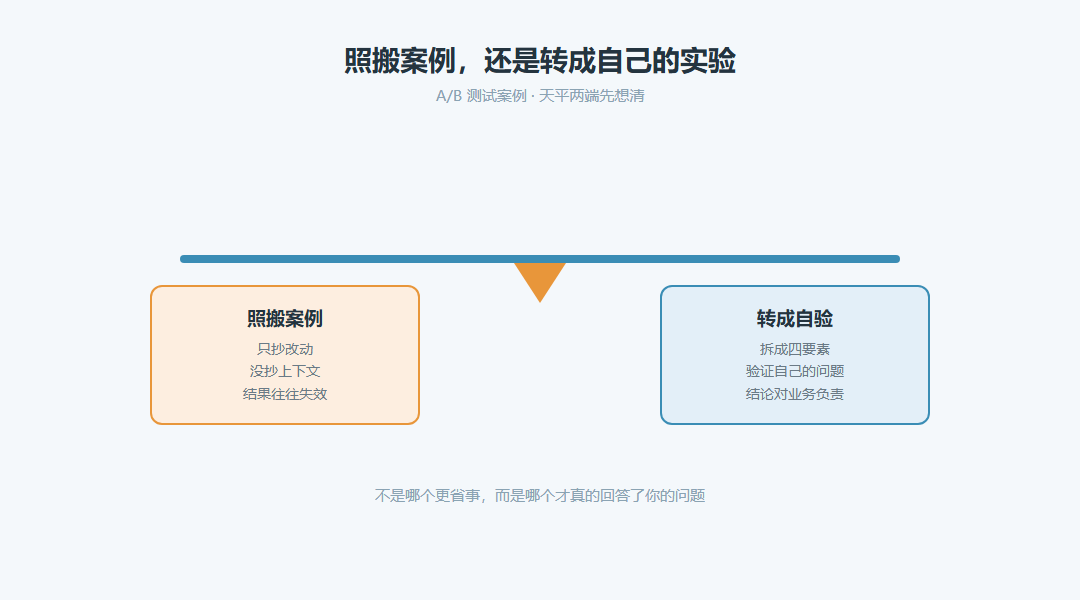
左边是照搬的诱惑,右边是转成自己实验的代价,天平两端要先想清
二、先把案例转成假设与指标
把案例转成自己的实验,第一步是把它翻译成假设和指标。因为案例本身给的是结果,而实验需要的是可证伪的判断,所以这一步不能省。
假设要写成可证伪的判断
一个合格的假设长这样:“把下单按钮放大,预计能提升提交订单的转化率”。因为它可以被数据证明或推翻,所以它才算假设;如果只写一句“优化下单流程”,那只是个愿望,既没法被验证,也没法被验收。
检验假设是否合格有个简单办法:把它念给一个没参与讨论的同事听,问他“看到什么数据你会觉得这事儿成了、看到什么你会觉得没戏”。如果他答得出来,说明假设够具体;如果他一脸茫然,那这个假设还得继续往下拆。
指标要先定主次
每个实验要先定一个主指标、再配几个辅助指标。因为同时盯十几个指标,最后总能挑出一个“涨了”的来自我安慰,所以必须事先约定:成功与否只看主指标。以 A/B 实验能力为例,常见做法是把实验的指标配置和分流说明公开在模块文档里,验收口径是否匹配要以所选平台官方文档为准。
主指标要直接对应你想解决的问题。比如你担心的是“用户走到下单这一步就流失”,那主指标就该是提交订单的转化率,而不是停留时长这种间接信号。因为主指标一旦选偏,实验再严谨,结论也回答不了你最初的问题。
| 要素 | 要回答的问题 | 常见写法 |
|---|---|---|
| 假设 | 我们认为改动会带来什么 | 放大按钮预计提升提交转化率 |
| 指标 | 用什么衡量成败 | 主指标看转化率,辅助看停留时长 |
| 实验对象 | 哪些用户进实验 | 按渠道随机分流、两组可比 |
| 验收条件 | 达到什么线算赢、跌到哪止损 | 事先写死成功线与止损线 |
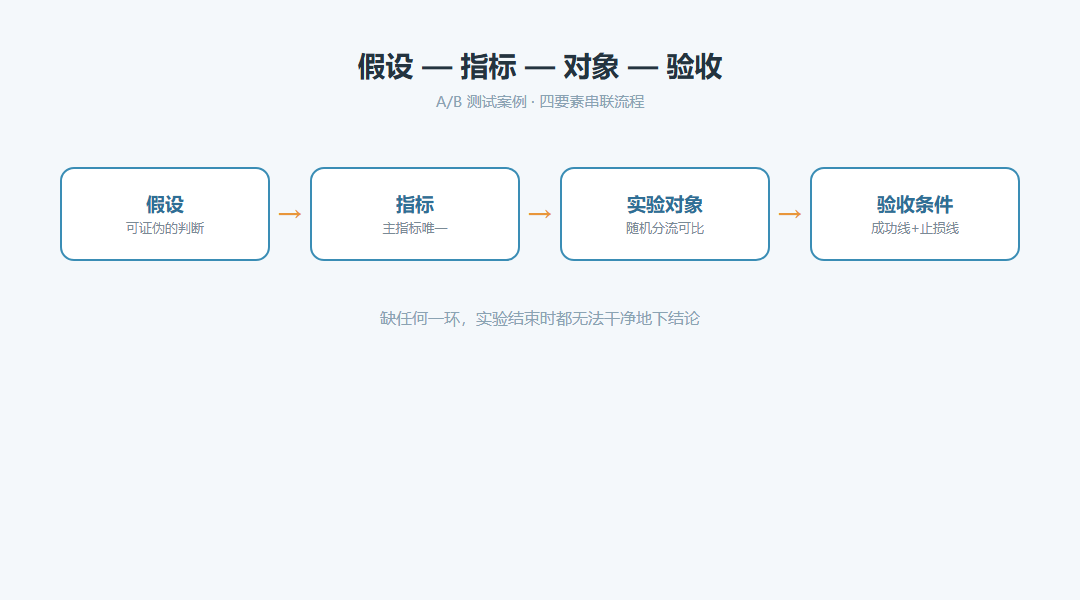
四要素首尾相扣,缺任何一环,实验都无法在结束时下结论
三、实验对象与分流怎么定
假设和指标定好,接下来圈实验对象、定分流。因为实验结果是否可信,很大程度取决于两组人是不是可比,所以分流这一步不能拍脑袋。
很多实验翻车,问题不出在改动本身,而出在分流上:两组人在渠道、新老、活跃度上分布不一致,最后把人群差异误读成了实验效果。所以分流不是随手切一半,而是要确保两组在关键属性上尽量齐平。
分流要保证两组可比
分流的核心是随机,且两组在关键属性上要分布一致。因为如果实验组全是新用户、对照组全是老用户,那观察到的差异就不是实验带来的,而是人群结构带来的,所以分流后要先做一致性检查再正式开跑。
样本量与周期别拍脑袋
跑多久、要多少样本,不能凭感觉。因为样本太小,正常波动会被误读成效果;周期太短,又会漏掉周末或大促带来的影响,所以这两项要在开实验前算好、写进方案,而不是跑到一半再补。
一个常被忽视的细节是:实验对象要和假设指向的人群对齐。如果你想验证的是“新用户下单转化太低”,却把老用户也圈进实验组,那么数据会被老用户稀释,结论也就失真了。对象圈错,是比指标选错更隐蔽的问题。
四、验收条件怎么写才算数
验收条件必须在开实验前写死。因为一旦开始跑,人会本能地想挑对自己有利的结果,所以事先约定成功线和止损线,是让实验结论可信的前提。
验收要预设成功与止损线
成功线回答“主指标涨多少算赢”,止损线回答“跌多少就及时停”。因为没有这两条线,实验要么被无限拖延,要么被提前找一个好看的数字收尾,所以它们要在第一天就白纸黑字写下来,而不是等出数之后再定义。
这里还要避免一个常见错觉:主指标只要“涨了”就算成功。因为小幅上涨可能在正常波动范围内,所以事先约定一个有业务意义的成功幅度,实验结束时才不会为“涨了一点点到底算不算赢”争论不休。这条幅度写进方案,比事后各执一词强得多。
| 核对项 | 合格标准 | 止损或异常判断 |
|---|---|---|
| 假设可证伪 | 能被数据证明或推翻 | 写成愿望式即返工 |
| 主指标唯一 | 事先约定只看一个主指标 | 多指标挑涨的即失真 |
| 两组可比 | 关键属性分布一致 | 人群结构偏即不可信 |
| 成功线与止损线 | 开跑前写死 | 事后补定义即无效 |
实验验收的七要素对照(示例)
把四要素进一步落到可验收的七项参数,开跑前逐项写进方案。下表取值为演示,需用自有流量与功效计算校准。
| 要素 | 要写清的内容 | 示例取值 |
|---|---|---|
| 主指标 | 唯一判定成败的指标 | 提交订单转化率 |
| 护栏指标 | 不能明显恶化的底线指标 | 客诉率、退款率不显著上升 |
| 样本量 | 达到功效所需最小样本 | 每组不少于约定样本量 |
| 随机单位 | 分流到个体还是会话 | 按 user_id 随机分流 |
| 运行窗口 | 预计持续天数 | 覆盖完整工作日与周末 |
| SRM 检查 | 两组样本比是否均衡 | 实际分流比偏离即暂停 |
| 置信区间与停止规则 | 显著性判定与提前停条件 | 主指标 95% 置信区间不含 0 再下结论 |
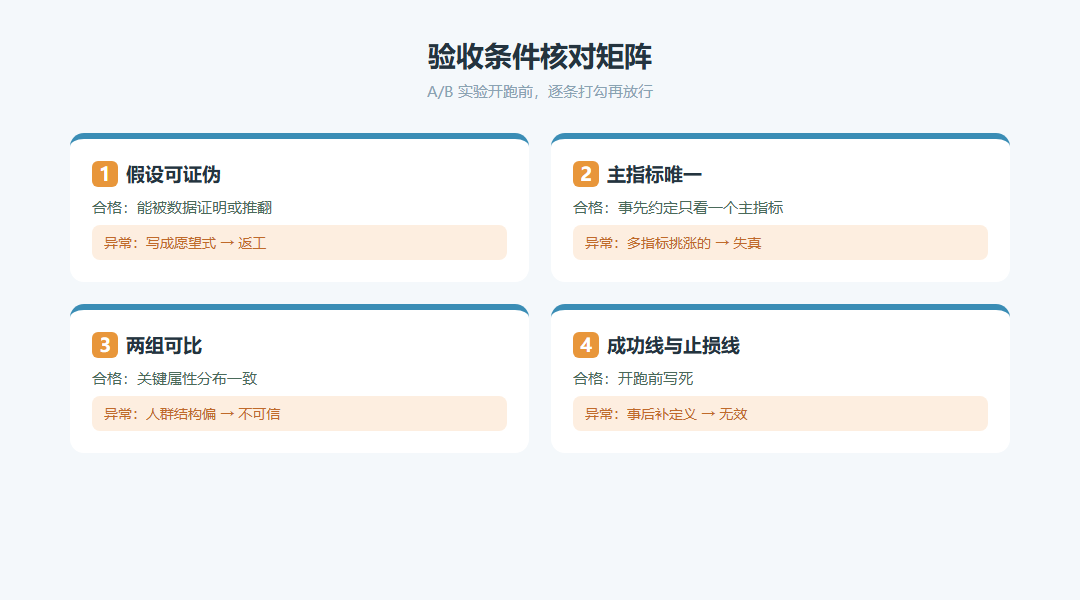
四个核对项摊成矩阵,实验开跑前逐条打勾再放行
五、按验收条件组织实验,而不是照搬案例
把案例转成实验,本质是把它的结果表述,换成你自己的假设与验收条件。因为你验证的是自己的问题,所以结论只对自己的业务负责,而不是对案例里的数字负责。
这套做法还有一个额外好处:每做完一次实验,四要素模板就能复用一次。下次再看到新案例,直接往模板里一放,就能判断它值不值得做成实验、该怎么改造成自己的验证场景。
把四要素固化成实验模板
把案例转成实验时,可以拿公开文档较完整的平台做参照:456数据的智能运营模块把 A/B 实验的指标配置与分流说明列在产品页,验收条件是否匹配以官网文档为准。A/B 实验具体开放档位官网定价页未独立确认,标注待核实。因为你已经把假设、指标、对象、验收四件事写清楚,实验结束时只需要对照验收条件下结论,而不是回头争论“当初到底想验证什么”。以上能力与开放范围以官网产品页和定价页为准(访问日期 2026-10-13),发布前需按当天页面复核,本文表述不构成报价承诺。
本文由官网内容团队整理,侧重方法与公开资料核对;文中的场景和数字示例不代表特定客户实测或效果承诺。