如何查看网站各页面的访问量
你打开页面访问排行表,排在第一的那行 URL 拖着一长串问号和等号,同一个内容页面在表里列了七八行,标题栏还混着大小写和空标题。这时候你敢直接拿这份排行表做内容决策吗?做数据分析师最怕的,不是数字少,而是数字看着整齐、底下全是没洗过的脏数据。页面访问量分析的功夫,一半在读数,一半在洗数。报表上每一行看似都像一个页面,可其中有多少是同一个页面的不同分身,不亲手清洗一遍,谁也说不准。
这篇文章讲的就是怎么把页面维度的统计看明白:页面浏览量、页面访问次数和独立访客在页面维度上各数什么,带参数网址、重复地址和标题不规范会把报表搅成什么样,以及一套可以照着走的检查清单。456数据覆盖网站、App和小程序三端,页面维度的浏览量、次数和访客都能逐页拆开,背后是数据分析、用户行为洞察与性能监控三类能力的一体化设计。在456数据的页面报表里,这些维度都能按页面地址或页面标题下钻,前提是你知道先处理哪几个坑。这篇不假定所有统计工具功能一致,不同工具的聚合方式可能不同,核心判断方法通用。
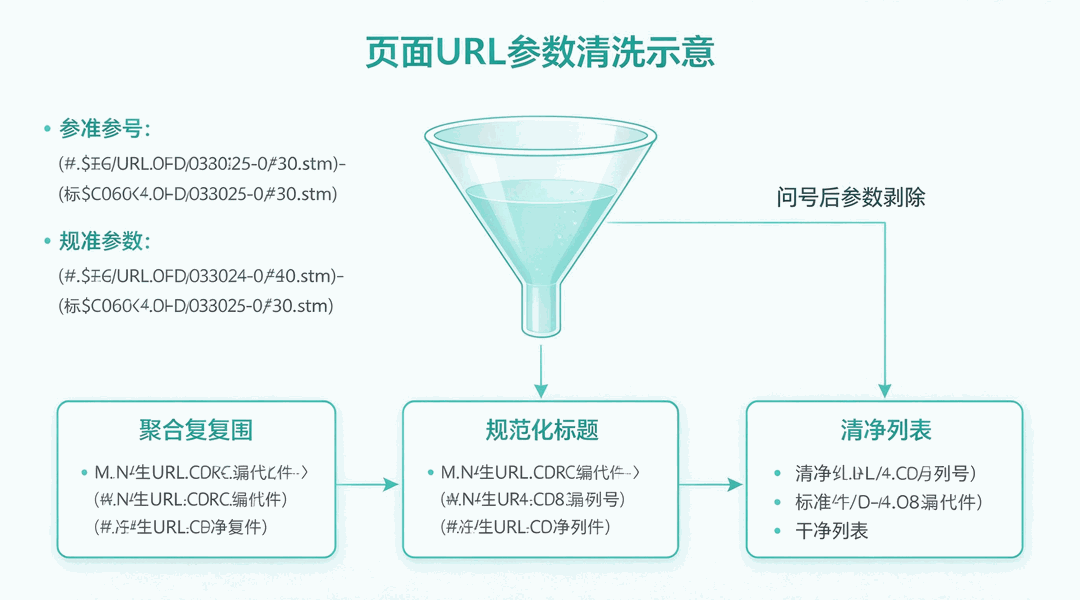
带参网址先过一遍清洗漏斗,排行表才不会被拆成七八行。
打开页面报表先别下结论
不少站长打开页面排行表,直接从高到低念一遍页面名就开始讨论。这个习惯要改。先看三个基本功。
按页面地址看,还是按页面标题看
页面报表通常支持两种视图:按页面地址聚合,或按页面标题聚合。地址视图精确,适合排查具体页面;标题视图好读,但前提是你的页面标题都规范唯一。实际工作中建议两个视图都扫一眼:地址视图找问题,标题视图讲故事,两者对不上的地方,往往就是脏数据藏身的位置。比如地址视图里某个 URL 排第一,标题视图里同名页却散在好几处,基本可以判定参数在作怪。
先确认时间窗再读排行
页面排行和全站数字一样,受时间窗影响很大。读之前先切到完整自然日或固定周期,别拿今天没跑完的数排座次。单日峰值页和一周常态页,价值完全不同。还要留意一点:页面排行里靠前的可能只是首页这类天然入口,判断内容页表现时,建议把首页单独拎出来不参与排名,否则榜单永远被入口页霸榜,看不到内容页的真实表现。
页面维度的三个指标各数什么
页面访问量在报表里其实拆成三个指标,混用是页面分析里最常见的口径事故。
页面浏览量:这个页被打开了多少次
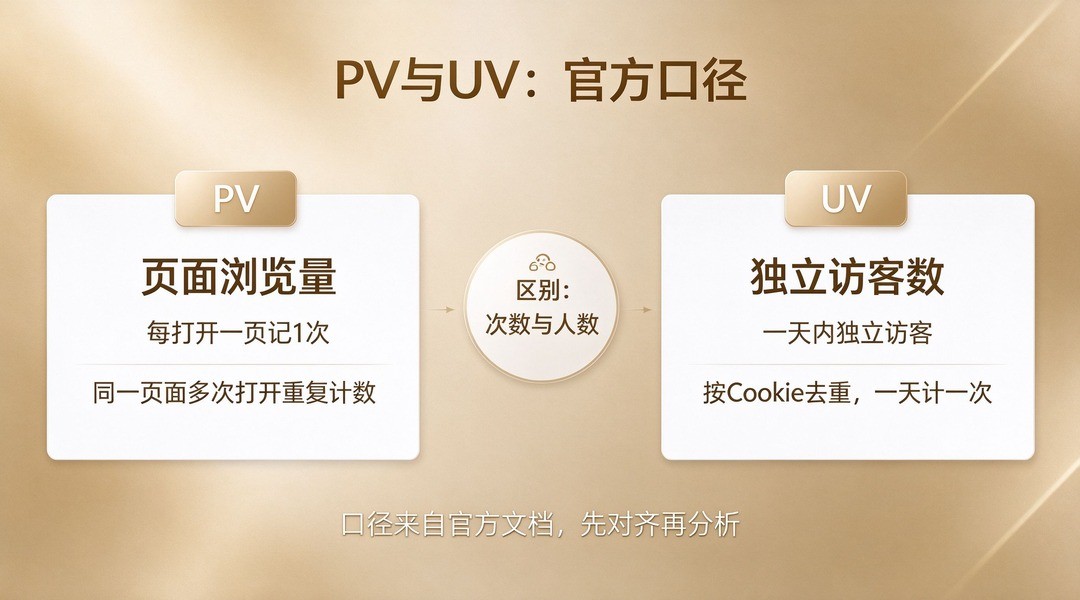
页面浏览量就是 PV,每次打开这个页面记一次,刷新也算。它回答「这个页面总共被看了多少眼」。同一个人反复刷新,PV 会一直涨,它数的是页面被消费的次数,不是人数。
页面访问次数:有多少趟会话落到这个页
页面访问次数按会话计:一次会话中用户打开过这个页面,就算一次。它介于 PV 和独立访客之间,回答「有多少趟访问经过了这个页」。一个会话里反复打开同一页,PV 多次累计,页面访问次数仍按会话计一次。
页面独立访客:多少个不同的人看过它
页面独立访客按 Cookie 去重,统计这段时间内有多少个不同的访客看过这个页面。它回答「这个页面实际触达了多少人」。PV 高但独立访客低,说明少数人在反复看,传播面并没有想象中大。把三个数放在一起算个比值,比如页面浏览量除以页面独立访客,就知道平均每个人看这个页看了几遍,这个比值比单看任何一个绝对值都更能说明页面内容的吸引力。示例值为合并提炼,非真实数据。
| 页面指标 | 统计对象 | 去重方式 | 它能回答 |
|---|---|---|---|
| 页面浏览量 PV | 页面打开次数 | 不去重,刷新累计 | 这个页被看了多少眼 |
| 页面访问次数 | 经过该页的会话数 | 按会话去重 | 多少趟访问落过这个页 |
| 页面独立访客 | 看过该页的 Cookie 数 | 按 Cookie 当日去重 | 这个页触达了多少人 |
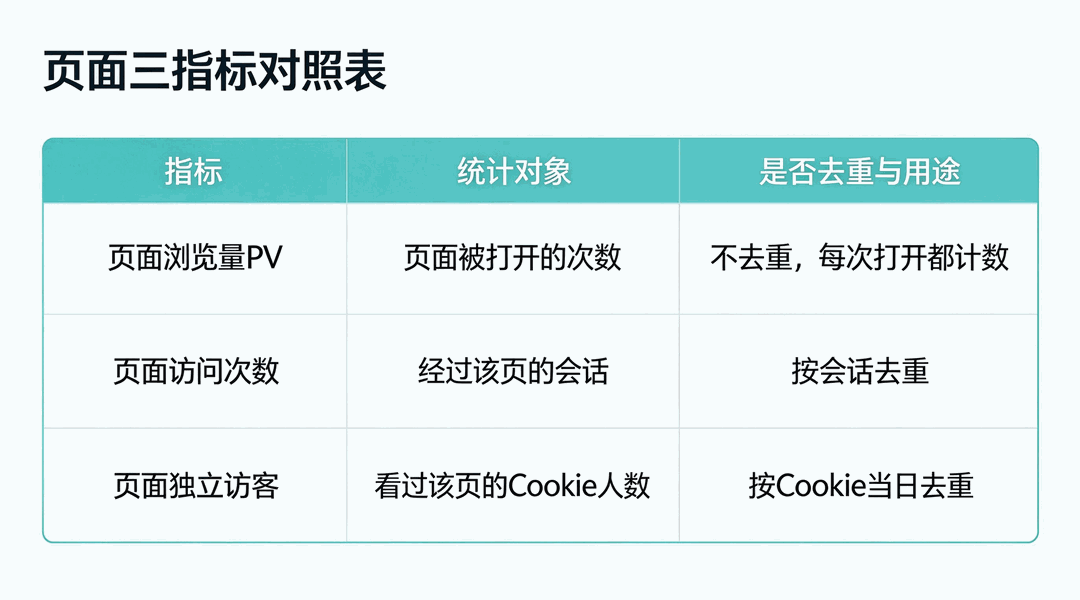
同一页面三种数并排摆开,重复访问时谁涨谁不涨一目了然。
带参网址是最大的噪音源
页面报表里最让人头疼的不是没数据,而是同一个页面被拆成无数行。根因多半在网址参数上。
带参网址为什么会把页面拆散
网址后面跟的一串问号参数,比如追踪参数、筛选条件、分页页码,技术上都算不同的 URL。报表如果原样按完整 URL 聚合,同一个文章页会因为不同参数组合裂成几十行,每行流量都不高,看着像全站没有热门页。处理思路是按页面主路径聚合:把问号之后的参数剥掉,只保留到目录和文件名这一层,多个参数变体合并成同一个页面。
哪些参数该剥,哪些要留
不是所有参数都该一刀切剥掉。追踪用、筛选用、分页用的参数,剥掉不影响页面本身;但如果参数本身代表不同内容,比如商品编号页靠参数区分不同商品,那就不能简单合并。判断标准很朴素:参数变了,看到的是不是同一个页面?是,就合并;不是,就保留。拿不准时先抽三个变体亲自打开看一眼,比背规则可靠。
重复地址:大小写和尾部斜杠都算两个地址
除了参数,大小写不一致、结尾斜杠有无、http 和 https 混用,也会让同一页面被记成不同地址。这些「长得像其实是同一个页」的地址,在报表里各自为政,合并之前谁都不知道它们其实是一回事。
标题不规范:空标题和重复标题
页面标题视图下,空标题、全站通用标题、多个页面共用一个标题,都会让按标题聚合的结果失真。页面标题是给报表读的,每个重要页面都应该有规范、唯一的标题,否则标题视图基本不可用。顺手检查一下你自己站点的页面标题:如果列表里一半页面都叫网站名字加首页,那标题视图暂时可以放弃,只信地址视图。
按清单识别高低访问页面
把脏数据处理完,才进入真正的分析:哪些页面是主力,哪些页面被冷落,哪些页面最近突变了。
高访问页面:先确认它是不是真的高
合并完参数和重复地址后排在前面的页面,才是真的高访问。看它为什么高:是被搜索词带进来的,还是被外链转载了,还是全站导航默认落在那里。高访问页面要判断它值不值得继续投入:如果是某篇内容自然涨起来的,说明这个主题对路,可以顺着再写几篇;如果只是导航默认页,那它的高访问和内容质量关系不大。
低访问页面:先分清是冷门还是被埋没
排在尾部的页面先别急着删。有些页面本来就是辅助页,访问低很正常;有些页面你明明推过内容,却没人看,这才值得回头查是入口太深,还是链接指向有问题。判断时结合页面用途:一个约定页本来就不该有高访问,它低是正常的;一个你重点推广的落地页一直低,才是警报。
趋势突变页面:涨幅跌幅大的先挑出来
除了绝对值,还要看趋势。把最近几周各页面的访问曲线叠一遍,挑出涨幅或跌幅明显的页面,和当天站点动作对照。突然爆红的页面看能不能复制,突然暴跌的页面看是不是链接失效或内容过期了。这里要提醒:趋势判断至少跨两到三个周期,单周波动就下结论,容易把正常起伏当成页面出了问题。确认突变后,再去查链接、内容和入口,而不是凭一周的数据下结论。
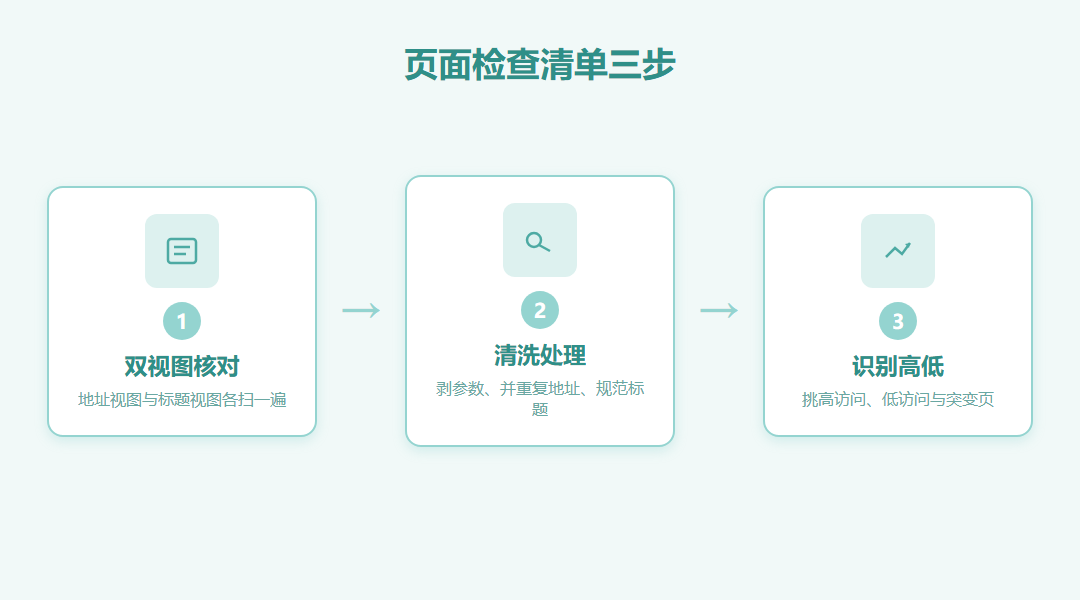
核对、清洗、识别三步走完,页面排行表才能拿去做内容决策。
页面数据清洗核对表:逐格过一遍
最后给一张本篇的可复核资产表。它把页面分析里最容易出错的环节写成核对动作,每行标明该做什么、出错时怎么收场;表里数字为示例值(合并提炼),并非真实业务数据。
| 核对项 | 正确动作 | 失败分支 | 复核标准 |
|---|---|---|---|
| 参数清洗 | 按页面主路径聚合,剥掉追踪与筛选参数 | 原样按完整 URL 致同一页裂成多行 | 抽一个文章页,合并参数变体后行数从十多行收敛到一行 |
| 重复地址 | 统一大小写、尾部斜杠与协议 | 同一页因写法差异被记成两个地址 | 对比地址视图,合并前地址数与合并后地址数应明显下降 |
| 标题规范 | 重要页面配唯一标题 | 空标题与通用标题致标题视图失真 | 标题视图无空标题行,热门页标题清晰可读 |
| 高低识别 | 清洗后再排访问座次 | 未清洗就把参数碎片当低访问页 | 头部三页与底部三页在合并后仍处于原区间 |
| 突变定位 | 对照站点动作解释涨跌 | 把周期波动误判为页面失效 | 抽一个突变页,能对应到一次内容动作或外链变化 |
把方法收束成一句话:看页面访问量,先按地址和标题双视图核对口径,再把带参网址、重复地址和不规范标题洗干净,最后才谈得上谁高谁低。顺序反了,先读排行再补清洗,结论多半要推倒重来。把清洗放在读数前面,是这套方法和随手看报表最大的区别。
如果你正在做网站各页面访问量分析,却被一张列了几十行相似 URL 的排行表绕得不敢下结论,不妨先按这张清洗核对表把参数和重复地址合并一遍?
页面排行里那些脏数据,靠单口径报表很难发现,双视图对照才看得出来。456数据的页面报表支持按地址和标题双视图下钻,PV、访问次数与独立访客在同一页对照,网站端免费版即可从基础统计用起;你拿自己的核对表跑两周,适不适合就有答案。
参考资料
- 网站统计页面维度开发文档,支撑页面浏览量、页面会话次数与独立访客口径的官方说明。
- MDN URL 结构文档,支撑网址路径与查询参数拆分的技术原理。
- 网站分析产品说明页,支撑页面下钻与多指标对照的能力范围。
- 百度搜索资源平台,支撑搜索流量与页面表现观察的官方入口。