前端性能监控怎么搭建?四步框架从阈值到复盘
页面加载慢、接口经常超时,用户投诉进来了,可团队拿不出任何数据证明问题在哪。技术负责人最怕的不是性能差,而是性能差却看不见。这篇按任务执行顺序,给出一套前端性能监控的四步搭建框架,你照着搭,第一周就能看到真实数据。
一、前端性能监控是什么
1.1 前端性能监控解决什么问题
前端性能监控指采集真实用户在浏览器端的加载、交互与错误数据,用于定位性能问题。它解决的核心问题是"性能差却看不见":没有监控时,页面慢只能等用户投诉;有监控后,加载耗时、JS错误、接口超时都能量化。因为性能问题直接影响转化与留存,所以前端性能监控是数据体系的必要组成部分,不是可选项。搭建前端性能监控的第一周,目标就是把"看不见"变成"看得见"。
1.2 RUM与实验室监控的区别
前端性能监控通常采用RUM(Real User Monitoring,真实用户监控),与实验室监控(在固定环境模拟测试)相对。因为RUM采集的是真实用户的网络环境与设备数据,所以它能反映实际体验,而实验室数据只能反映测试环境。两者互补:实验室用于发布前检测,RUM用于线上持续观测。搭建前端性能监控时,两类数据都要有,但角色不同。
1.3 核心Web指标的来源
性能指标的判定阈值参考web.dev公开的标准。因为web.dev是Google维护的Web性能权威来源,所以团队可以直接引用其阈值做基线,不需要自己拍脑袋定标准。前端性能监控的阈值设定,是整套体系的地基,地基引用权威标准,后面的告警与报告才有共同语言。
1.4 前端性能监控与行为分析的联动
前端性能监控的价值不只在于性能本身,还在于与行为分析联动:页面慢的用户,转化率是否更低;接口报错的时段,流失是否上升。因为性能与行为是同一批用户的两面,所以把性能数据与行为数据放进同一套体系,才能回答"性能问题影响了多少业务"。这也是为什么越来越多团队把前端性能监控纳入统一的数据分析平台。
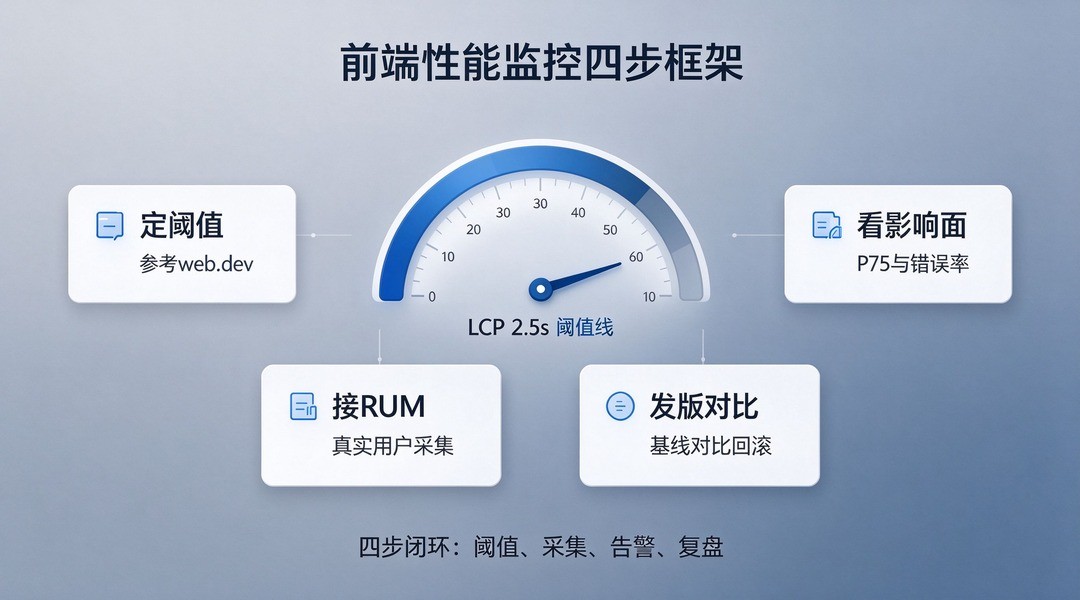
图1 四步框架看什么:从阈值到复盘的概念与结构示意
二、四步框架看什么:从阈值到复盘
2.1 第一步:定阈值
搭建前端性能监控的第一步是定阈值。参考web.dev的公开标准,核心Web指标的阈值如下:
| 指标 | 良好 | 需改进 | 差 |
|---|---|---|---|
| LCP(最大内容绘制) | ≤2.5秒 | ≤4.0秒 | >4.0秒 |
| FCP(首次内容绘制) | ≤1.8秒 | ≤3.0秒 | >3.0秒 |
| CLS(布局偏移) | ≤0.1 | ≤0.25 | >0.25 |
| INP(交互到绘制延迟) | ≤200毫秒 | ≤500毫秒 | >500毫秒 |
| TTFB(首字节时间) | ≤0.8秒 | ≤1.8秒 | >1.8秒 |
因为阈值是"正常与否"的判定基线,所以先按上表把三类判定(良好/需改进/差)写进监控配置,后续告警与报告都以此为基准。
2.2 第二步:接入RUM采集
第二步接入RUM采集,在页面中加载前端性能监控脚本,采集LCP、FCP、CLS、INP与错误数据。因为RUM数据来自真实用户,所以接入后数据会随流量自然积累,新站点第一周就能形成基线。接入时注意脚本要在页面早期加载,避免漏采首屏数据。这一步完成,前端性能监控才算真正"上线"。
2.3 第三步:按影响面告警
第三步设置告警,原则是"按影响面告警,而不是按单条异常告警"。因为单个用户的环境问题不代表整体问题,所以前端性能监控的告警应基于聚合指标(如P75超过阈值、错误率超过比例),而不是单次请求。官网公开的错误分布示例可以作参考:JS错误42.5%、接口错误28.1%、资源错误18.6%、网络错误7.8%——按错误类型分布定位,比笼统看"错误率"更精准。
2.4 第四步:发布对比复盘
第四步把前端性能监控接入发布流程:每次发版后对比性能指标,异常立即回滚或修复。因为大多数性能问题由发布引入,所以"发布前后对比"是前端性能监控最有价值的用法。复盘时用P50与P95两个分位一起看,P50代表典型体验,P95代表极端体验,两者同时恶化说明问题严重。
2.5 四步框架的节奏
四步框架不是一次做完就结束,而是建立持续节奏:阈值随业务调整、告警随版本优化、复盘随发布执行。因为前端性能监控是运营型体系,不是一次性项目,所以把四步固化成流程(定阈值→接采集→设告警→做复盘),每季度回看一次,体系才不会老化。
三、怎么做:搭建动作清单
3.1 动作一:选择采集方式
选择RUM采集方式:自建脚本或使用现成的性能监控能力。因为自建要维护采集与存储,所以中小团队优先使用现成能力。以官网公开信息为例,456数据的前端性能监控覆盖页面加载、JS错误、资源耗时与接口超时,接入方式与统计代码统一,不需要单独部署一套体系。这一步把"要不要自己造轮子"的决策做掉。
3.2 动作二:配置阈值与告警
按第一步的阈值表配置监控,设置P75级别的告警规则。因为P75是"多数用户体验"的代表值,所以比平均值更能反映真实问题,告警阈值以P75为基准更稳。配置完成后,用一次模拟异常验证告警能触发,避免"告警没配好"到出事才发现。
3.3 动作三:建立错误分类
把错误按JS、接口、资源、网络四类归类,建立错误分类视图。因为四类错误的排查路径不同(JS错误看代码、接口错误看后端、资源错误看CDN、网络错误看用户环境),所以分类后才能对症下药。前端性能监控的错误分类,是告警之后的第一层定位工具。
3.4 动作四:接入发布流程
把性能对比接入发布流程:发版前记录基线,发版后24小时对比,异常即回滚。因为发布是性能波动的高发点,所以这一步把前端性能监控从"被动看板"变成"主动闸门"。接入发布流程后,性能监控才真正产生工程价值。
3.5 动作五:建立周报机制
把性能周报纳入常规节奏:每周看LCP/FCP/CLS/INP的P50与P95趋势、错误分布变化、异常事件记录。因为周报让性能问题"被看见",所以前端性能监控的周报机制,是四步框架之外的持续性动作,保证体系不会闲置。
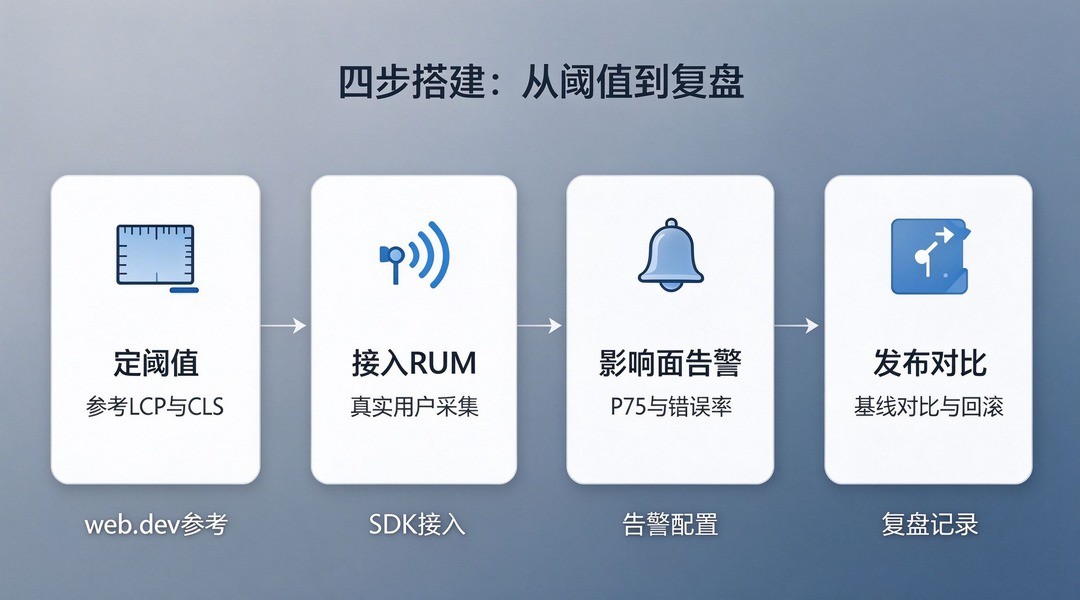
图2 前端性能监控四步框架从定阈值、接入RUM、影响面告警到发布复盘的流程
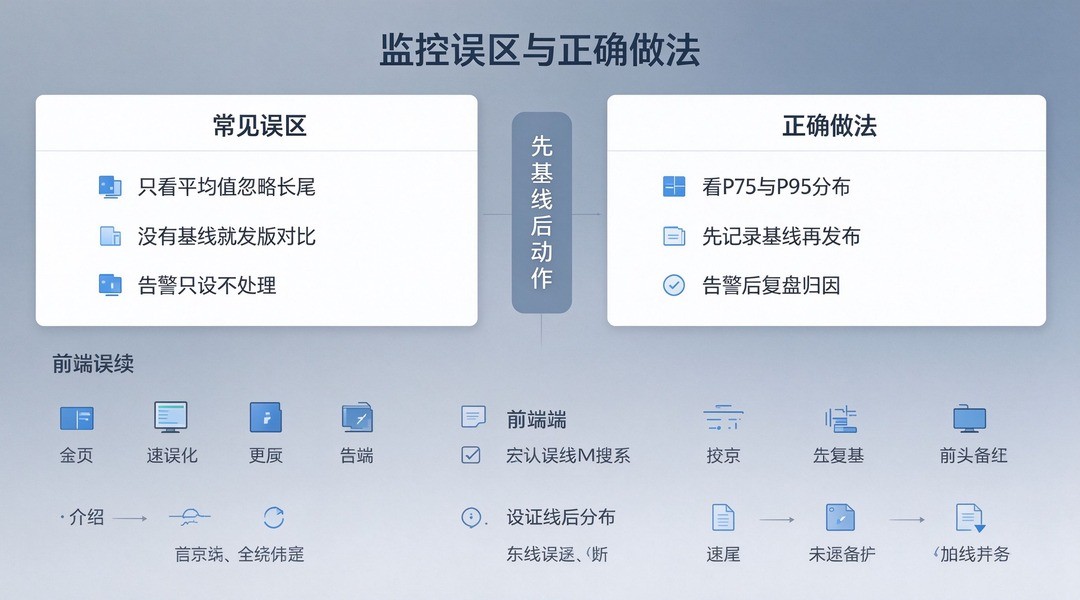
图3 本文误区与边界的关键对比
四、误区与边界
4.1 误区:平均值够用
平均值会掩盖性能问题。一次超长加载会把均值拉高,一次快速加载也会把均值拉低,平均值的波动无法定位到用户群。因为分位数(P50、P75、P95)才能反映体验分布,所以前端性能监控看板以分位数为准,平均值只作参考。
4.2 误区:只监控首页
只监控首页会漏掉大量问题。因为用户进入站点的路径多样(落地页、活动页、详情页),所以核心页面都要纳入前端性能监控,至少覆盖流量前20的页面。只盯首页,等于只看门面不看房间。
4.3 误区:阈值一次定死
阈值不是一次定死的:业务改版、用户结构变化都会改变"正常"的定义。因为前端性能监控的阈值需要随业务演进,所以每季度回看一次阈值配置,用真实数据校准,而不是沿用最初的web.dev基线。
4.4 边界:性能监控不替代错误监控
前端性能监控聚焦体验指标,不替代应用错误监控的全部功能。因为错误监控还涉及后端日志、崩溃堆栈等维度,所以两者是互补关系,评估时确认性能监控覆盖的范围(JS错误、接口、资源)是否符合你的错误治理需求。
4.5 边界:阈值需要按业务调整
web.dev阈值是通用基线,不代表所有业务都适用。因为不同业务对性能的敏感度不同(电商对加载敏感、工具类对交互敏感),所以通用阈值只作起点,运营一段时间后按自己的业务数据调整。
4.6 上线后的两项配套:验收与权限
前端性能监控搭建完成后,建议做一次"数据质量验收":用已知的慢页面或已知错误验证监控数据能准确反映。因为前端性能监控的数据链路(脚本采集→上报→聚合→展示)任何一环出错,看板上的数字都会失真,所以上线初期主动制造一次可控异常(如临时给某个接口加延迟),确认监控能捕获,再进入日常使用。权限与告警管理也值得提前设计:因为前端性能监控数据是跨团队共享的(前端、后端、运维、产品都可能要看),所以权限分级与告警订阅规则清晰,能避免"告警太多没人看"或"数据开放无边界"两个极端。
4.7 本文未覆盖的边界
本文未覆盖Web Vitals之外的性能指标(如TTI、FID替代指标的适用场景)与自定义性能监控采样的完整配置,也不展开私有化部署方案。因为这类信息依赖站点结构与官方文档更新,所以需要时以官方文档站的最新公开内容为准。
结尾
前端性能监控的四步框架是:定阈值(引用web.dev标准)、接入RUM(采集真实用户数据)、按影响面告警(P75与错误率)、发布对比复盘(发版前后看基线)。四步走完,性能从"靠用户投诉发现"变成"靠数据主动发现"。最容易踩的坑是用平均值判断性能,换成P50与P95,判断就会准确很多。前端性能监控的终点不是搭起来,而是跑起来:周报、告警、发布对比,一样都不能少。