产品用户留存率如何计算与分析?先对齐三个口径
早上九点,运营群里炸了:「次日留存怎么掉了 10 个点?」我第一反应不是查数,而是先问一句:「你说的留存,是哪个口径?」因为用户留存率这个数字,换一个口径就能变出一套说法。本文按「问题爆发→对齐口径→批次分析→归因」的顺序,把留存率的计算与分析讲透。文中示例数据均为假设示例,不代表行业平均水平。
一、先别慌:留存率衡量的是什么
用户留存率衡量的是:一批用户在首次使用(或注册)之后,经过一段时间是否还会回来。它回答的不是「来了多少人」,而是「这批人留不留得住」。之所以留存率比单日活跃更重要,是因为它排除了推广带来的「一次性流量」:投放拉来的用户如果只来一次,活跃数再高也不构成长期价值。
所以要判断用户留存率的变动是真是假,第一件事永远是核对口径,而不是看绝对值。因为绝对值高可能是「回访条件宽松」的结果,绝对值低也可能是「回访条件严格」的结果;没有口径说明,任何「留存高」「留存低」的结论都不可比。
二、三个口径先对齐:起始群体、回访条件、观察窗口
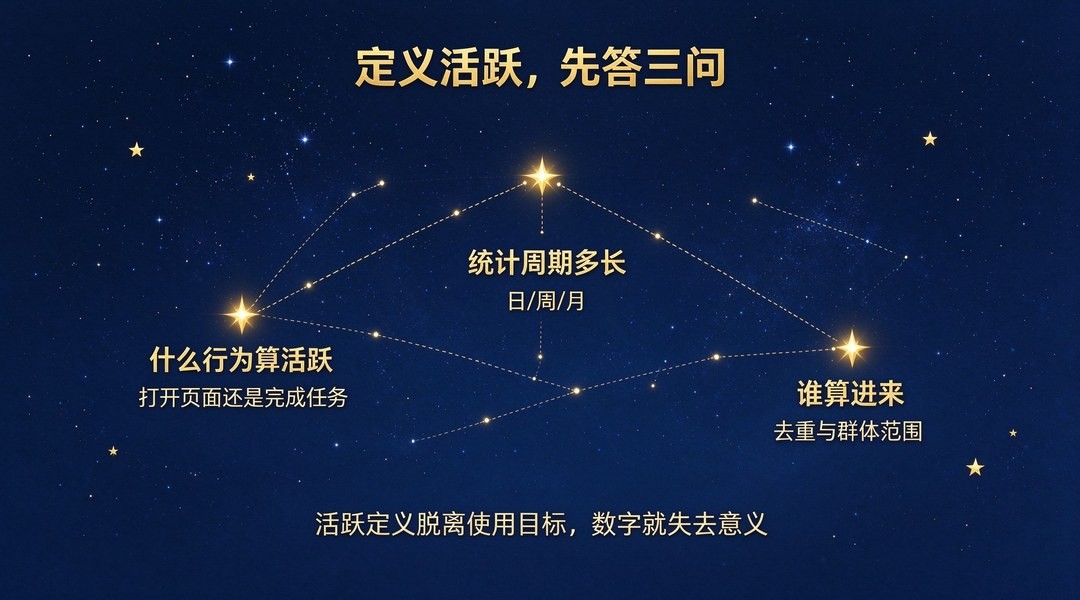
计算用户留存率前,必须同时确定三个口径,缺一个都会让结果失真。
| 口径 | 要回答的问题 | 常见写法 |
|---|---|---|
| 起始群体 | 谁被算进这批用户 | 新注册用户、首次使用用户、某渠道用户 |
| 回访条件 | 什么行为算「回来了」 | 打开 App、登录、完成核心任务 |
| 观察窗口 | 第几天回来算留存 | 次日、第 7 日、第 30 日 |
因为起始群体不同,留存率含义完全不同:新注册用户留存反映「获客质量」,活跃用户留存反映「存量粘性」;两者不能混着比。回访条件也很关键:把「打开页面」当回访,和把「完成一次任务」当回访,会得到差异很大的留存率,所以计算前要把回访条件写成一句可核对的话。
三、按批次建组:注册批次与首次使用批次
留存率不能看「全体用户均值」,要看批次。批次有两种常见建立方式:
- 按注册日期建组:把同一天注册的用户归为一个批次,看他们的留存曲线。
- 按首次使用日期建组:把同一天第一次触发关键行为的用户归为一个批次,更贴近真实「开始使用」时刻。
因为推广活动往往集中某几天带来大量用户,这些「活动批次」的留存天然偏低;按批次对比时,要把活动批次单独标记,避免把获客质量波动误判为产品问题。这里还要注意批次的最小规模:批次人数太少时(假设示例:不足百人),留存率的随机波动会很大,数字不具备统计意义。
四、怎么比较批次:同期批次与历史批次
批次建立后,比较方式有两种:
- 同期比较:比较同一周内不同来源批次的留存,判断哪个渠道的用户更值钱。
- 纵向比较:比较本周批次与历史批次的留存曲线,判断留存是否在改善。如果本周批次在 D7 明显低于上周批次,说明近期的产品变化或渠道变化可能影响了留存。
比较时注意:批次规模差异大会导致留存率波动大,小批次(假设示例:不足 100 人的批次)的数字不要单独下结论。因为留存曲线是一整条,建议比较时看「曲线形态」而不是只看单个节点:整条曲线右移说明留存变好,某个节点单独凹陷则更像事件性影响。
五、结合来源与行为拆解
批次趋势只能告诉你「变了」,要回答「为什么变」,需要再拆两层:
- 按用户来源拆:不同渠道的用户留存差异,往往大于产品改版的影响。
- 按首次使用行为拆:首次就完成核心任务的用户,留存通常显著高于浅层使用用户。因此可以把「首次行为深度」作为早期信号:某批次留存下滑,先看是不是该批次的首次行为深度下降了。
因为「来源」和「首次行为」是留存的两个前置变量,拆解它们比直接猜「产品是不是变差了」更接近原因。用户留存率的归因,本质上是在回答「是来的人不对,还是留下的人变少」。
回答这个问题,建议用一张「留存矩阵」把来源与首次行为两个维度组合起来:行是渠道来源,列是首次行为深度(只浏览、用过核心功能、完成关键任务),每个格子里填该群体的留存率。因为单一维度的拆分只能看到「哪个渠道差」或「哪种行为留得住」,矩阵才能看到「某个渠道来的浅层用户」这一类交叉群体的真实留存水平。矩阵里的数字属于假设示例时要明确标注,不能作为行业基准引用。
六、边界:结果受产品类型、活跃定义与统计口径影响
用户留存率不能脱离业务目标直接比较:工具型产品(用完即走)与内容型产品(每日打开)的合理留存水平完全不同,不同产品的「活跃」定义也不同。所以本文不引用任何行业平均留存率,行业基准类数字需要你自己按产品类型、统计口径去核实,直接套用只会误导判断。
最后提醒一个口径细节:留存的「观察窗口」要按自然日还是按用户相对日计算,两种方式结果不同。按自然日(固定日期窗口)适合看大盘趋势,按相对日(用户首次使用后的第 N 天)适合看行为曲线;因为两种口径回答的问题不同,报告里要写清用哪一种,避免团队拿着两种口径的留存数字争论不休。用户留存率的分析结论建议固定一套口径发布,并注明统计周期与批次定义,保证下个月复盘的数字与本月可比。
工具层面,像 456数据 这类统一接入网站、App、小程序的分析平台,可以按批次、来源、首次行为快速切分留存数据,把「口径对齐」的成本降下来;但起始群体、回访条件、观察窗口这三个口径,必须由业务团队自己定义清楚。留存工具负责把批次数准,定义「什么算留下」,是产品与运营的责任。
工具与口径的关系说清后,还要补一个实操建议:留存分析要「先画曲线,再定策略」。先把最近 8~12 个批次的留存曲线叠在一张图上,观察整体形态(曲线陡降还是平缓、是否有周期性波动),再决定下一步拆什么;因为曲线形态会告诉你问题类型——次日就陡降指向「首次体验」,7 日后持续下滑指向「价值衰减」,周期性波动则指向「使用场景受时间影响」。基于形态再选拆解维度,比直接按来源拆更接近问题本质。
如果你想从留存延伸到增长落地,可以读官网文章《数据驱动增长怎么落地?456数据从指标连接业务动作》(https://www.456.cn/news/30088.html)和《网站数据分析从哪里开始?456数据先定目标和指标》(https://www.456.cn/news/60086.html)。
回到早上那个问题:「次日留存掉了 10 个点」——如果你正在排查这次下降,先别急着改产品,先确认这三个口径:起始群体是谁、什么算回访、第几天算留存。如果这三个问题答不上来,那个「10 个点」可能根本不是你想的那个数。你最近一次看留存率,用的回访条件是什么?
最后补充一个留存分析的汇报口径:报告里同时写「绝对留存」与「相对变化」。绝对留存回答「这批用户第 N 天回来多少」,相对变化回答「与上批次/上季度比变化多少」;因为只报绝对数看不出趋势,只报相对数无法定位水平。报告还要标注批次规模与统计周期,小批次的留存数字(假设示例:不足百人)要加注「波动较大,仅参考」。这样输出,管理者既能看水平也能看变化,讨论才不会停留在「这个数高还是低」的层面。
用户留存率的分析,还可以引入「留存曲线对比」这一招:把当前批次与历史最佳批次的留存曲线叠放,直接看出差距在哪个周期拉开。因为用户留存率的改善不是均匀发生的,可能集中在次日(首次体验)或第 7 日(价值建立);曲线对比能直观暴露「差距从第几天开始放大」,为下一步拆解指明方向。建议每月做一次留存曲线体检:与自身历史对比、与目标对比、按渠道对比三张图,固定输出;坚持两个季度后,团队对「留存为什么变」的判断会明显更有依据。