网站统计数据与服务器日志为什么存在差异
目录索引
- 先看清两套系统各自记什么
- 请求数、PV、UV 的漏斗换算
- 九类差异原因,以及两端各自留下的痕迹
- 四个数字各自到底回答什么
- 七步核查法:把差异逐项对上
- 假设场景:12 万对 4 万怎么逐项验证
- 各有适用范围,按分析目标选数据源
- 实操补遗:一笔对账算例与落地口径
- 内容缺口复盘与改进优先级
示例数字仅用于说明口径。
对账表摊在桌上:服务器日志昨日滚出约 12 万条请求,统计报表里却只有约 4 万 PV,谁错了?(示例值)这种三倍差距一摆出来,你大概率会想先给其中一方定罪。稳妥的做法是先把「谁错了」三个字收起来——两套系统记录的根本不是同一件事。
数据对账,第一件事是承认两套数记的不是同一件事。一体化数据分析平台通常把用户行为洞察和前端性能监控按同一口径出数;可服务器日志讲的其实是另一套语言。但只要和服务器日志放在一起对账,就得立刻意识到:统计端记的是脚本执行之后的浏览与事件,日志端记的是浏览器与爬虫发起的每一次 HTTP 请求。对象不同、中间被扣减的环节不同,数字对不齐往往是合理的。下面把这条差异链一节一节拆清楚。
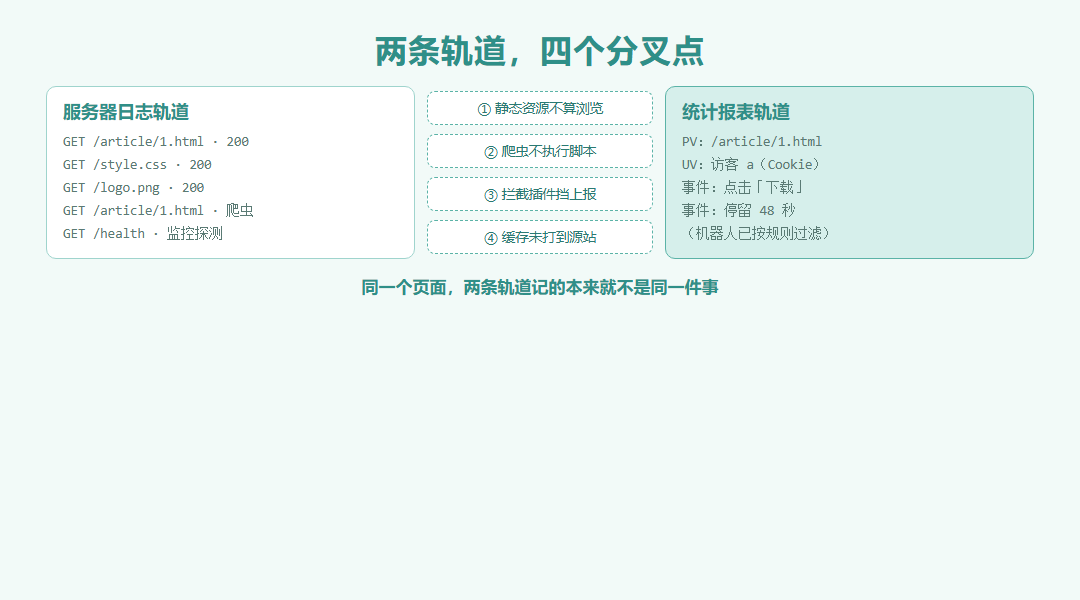
两条轨道从同一个页面出发,在四个分叉点走上了不同的计数路径。
▌ 先看清两套系统各自记什么
对账之前,先把两边的记录对象写清楚。这一步不做,后面所有「对不上」都会被误读成故障。
日志记的是 HTTP 请求全量
服务器日志逐行记录到达服务器的每一次请求,HTML 页面、CSS、JS、图片、字体,连同搜索引擎爬虫、监控探测、健康检查一起,全在里面。它不关心脚本有没有执行,也不区分这次请求背后是真人还是机器人。它回答的是「服务器被敲了多少次门」。除了页面本身,日志还记录每次请求的状态码、响应耗时、来源地址和浏览器标识,排查可用性和抓取行为时,这些字段是统计报表给不出的。
统计记的是脚本执行后的浏览与事件
统计工具要等浏览器加载完页面、统计脚本跑起来、浏览事件触发并上报之后,才记一笔 PV。没加载脚本的页面、被广告拦截插件挡掉的请求、爬虫不执行 JS 的访问,都进不了统计报表。它回答的是「真实被浏览了几次、访客做了什么」。换个说法,统计端天然带一层真人筛选:脚本跑起来了、事件触发了,它才认账。
▌ 请求数、PV、UV 的漏斗换算
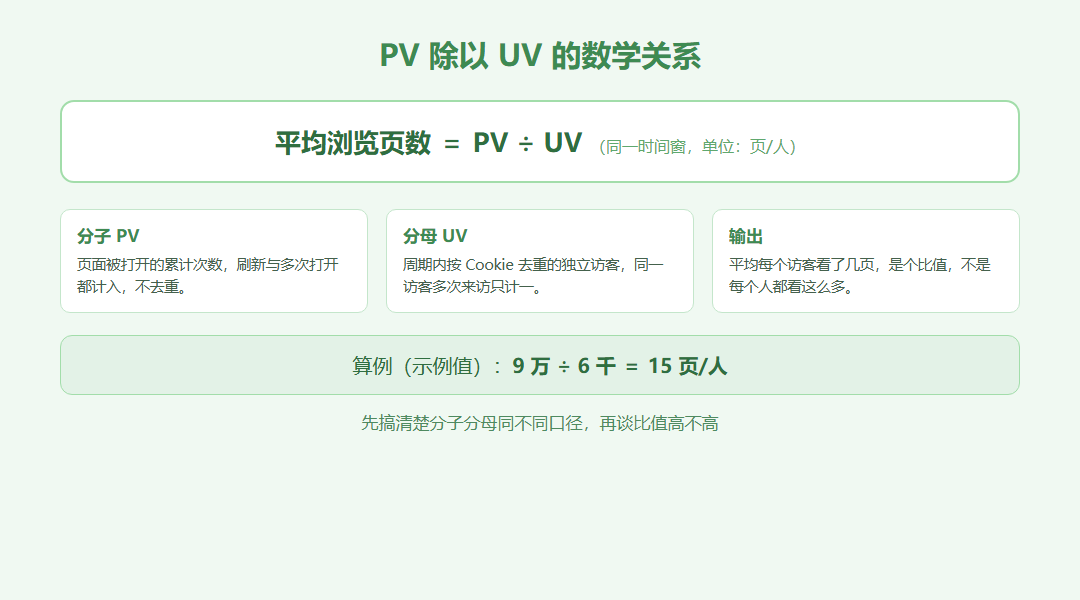
把两个数放在一起比之前,先理解一条不等式:请求数 ≥ PV ≥ UV。每一层都在扣减,扣减项不同,数字自然分叉。
为什么请求数一定大于等于 PV
日志里既有 HTML 页面请求,也有静态资源请求、监控探测和缓存命中。一个页面打开往往伴随十几次静态资源请求,这些在日志里都是记录,在 PV 里却只算一次。爬虫和机器人的请求同理——日志照单全收,统计端通常会过滤或根本采不到。这就是请求数远大于 PV 的第一层原因。
为什么 PV 又大于等于 UV
PV 是每打开一个页面记一次,多次打开累计;UV 一天内按 Cookie 去重,同一个访客来回刷十个页面也只计一个 UV。一个人看五页,PV 加五、UV 加一。所以 PV 不可能小于 UV,比值越大说明人均浏览页数越多,而不是访客越多。
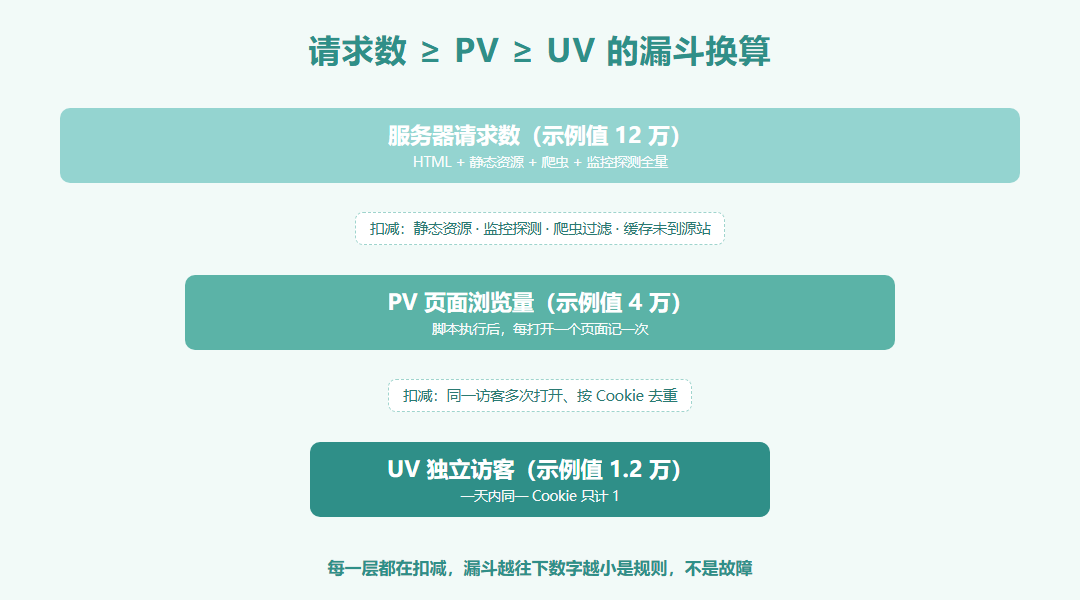
漏斗每一层都在扣减,理解扣减项就理解了差异的大头。
▌ 九类差异原因,以及两端各自留下的痕迹
除了上面这种结构性扣减,还有九类常见原因会让两个数字进一步拉开。关键是知道每一类在日志端和统计端分别留下什么痕迹,这决定了你该去哪一边找证据。
脚本与拦截类
统计脚本未正常加载,浏览器扩展或内容安全策略把上报请求拦掉,用户没有触发统计事件——这三类会让统计端偏低,而日志端的页面请求照常到达。痕迹很明确:日志有、统计无。
爬虫缓存与口径类
搜索引擎爬虫和自动化程序在两边的处理方式不同:日志全记,统计端按规则过滤或直接采不到。缓存命中的请求只到 CDN 或中间层,未必打到源站日志;统计口径不一致则让两边的数从一开始就不是同一把尺。
过滤时区与事件对应类
机器人过滤规则两边不同,时间范围与时区设置不一致,会让同一天的数据落在不同的统计窗里。页面浏览事件和服务器请求本来也不是一一对应——一次请求可能没触发事件,一次 SPA 路由切换可能触发浏览事件却没有新的服务器请求。
| 差异原因 | 日志端可见痕迹 | 统计端可见痕迹 |
|---|---|---|
| 脚本未加载 | 页面请求正常到达 | 对应浏览事件缺失 |
| 浏览器拦截上报 | 页面请求在,上报请求无 | 实时访客少于日志请求 |
| 事件未触发 | 页面请求存在 | 自定义事件为零或偏低 |
| 爬虫处理不同 | 大量机器人请求保留 | 按规则过滤后不计访客 |
| 缓存命中 | 部分请求未到源站 | 浏览事件仍被记录 |
| 统计口径不同 | 不受口径影响 | 换口径后数值跳变 |
| 过滤规则差异 | 保留全部请求 | 剔除比例与日志不同 |
| 时区与时间范围 | 时间戳为服务器本地 | 按报表时区切日 |
| 事件与请求不对应 | SPA 路由切换无新请求 | 浏览事件照常累计 |
▌ 四个数字各自到底回答什么
差异讲完,再把四个常被混用的数字各归其位。把它们当成同一把尺的刻度,是对账争吵的根源。
日志请求数、PV、UV、事件分别回答什么
日志请求数回答「服务器被请求了多少次」,适合看可用性、被谁抓取;PV 回答「页面被浏览了多少次」,适合看内容消费密度;UV 回答「来了多少个以 Cookie 识别的独立访客」,适合看拉新与回访;事件回答「访客做了哪些你预先定义的动作」,适合看行为路径。用途不同,谁也替代不了谁。
| 指标 | 记录方 | 核心问题 | 不适合回答 |
|---|---|---|---|
| 日志请求数 | 服务器日志 | 被请求了多少次 | 真人看了几页 |
| PV | 统计工具 | 页面被浏览多少次 | 来了多少人 |
| UV | 统计工具 | 多少个独立访客 | 精确人头 |
| 自定义事件 | 统计工具 | 访客做了哪些动作 | 服务器负载 |
▌ 七步核查法:把差异逐项对上
遇到差异,不要急着缩小数字,而是按下面七步把口径和证据一步步对齐。顺序乱了,容易在错误的环节打转。
从统一时间到按页比较
先统一时间范围与时区,再核对指标定义,再检查日志记录范围,再看统计脚本加载,再验证事件上报,再确认机器人过滤规则,最后按页面和时段逐项比较。每一步都把两边看到的客观结果记下来,差异落在哪一层,哪一层就是结论所在。遇到两边始终对不齐,也不必强行把数字凑成一样——先确认差异是否落在已知的扣减项里,再决定要不要继续追下去。
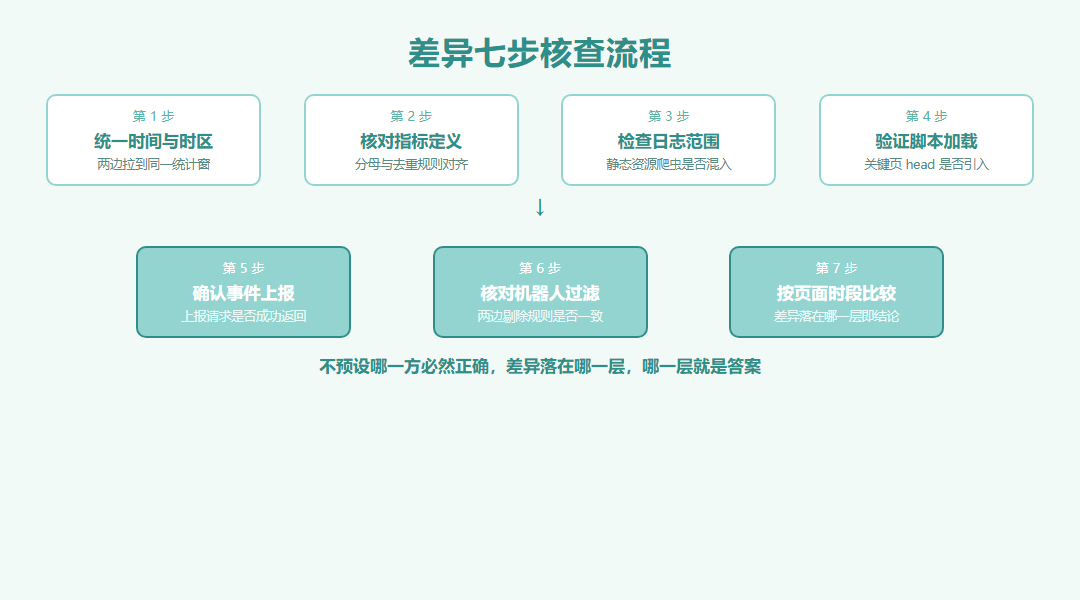
七步走完,差异通常已经落在某一层,而不是一团迷雾。
▌ 假设场景:12 万对 4 万怎么逐项验证
接下来就用这套数做一次完整对账,数字合并自多个教学案例,并非某个真实站点。某站日志昨日约 12 万条请求、统计报表约 4 万 PV(示例值,合并提炼,非真实数据)。值班同学先把两边拉到同一个北京时间窗口。
阶段性结论怎么下
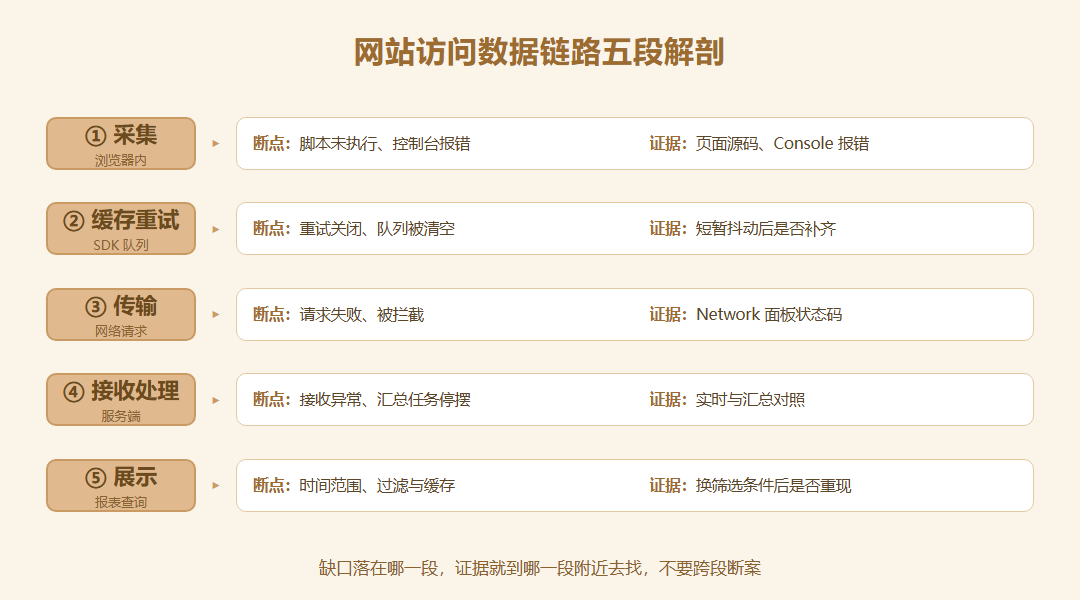
第一步发现日志里近一半是图片、CSS 和 JS 等静态资源请求;第二步认出其中还有一大块是某搜索引擎爬虫的集中抓取,统计端按规则过滤了;第三步核对一个热门文章页,日志请求与统计 PV 在剔除静态资源和爬虫后基本吻合。第四步又抽查了几个内页,日志请求与统计 PV 的比值稳定在同一区间,说明不是某几个页面的脚本出了问题。阶段性结论是:差异主要由结构性扣减和爬虫过滤造成,不是统计端漏采,也不需要修代码。
▌ 各有适用范围,按分析目标选数据源
做用户行为洞察,要看统计端的 PV、UV 与事件;做抓取与可用性分析,要翻日志端的请求。两套数摆在一起比,比追着一个数字要答案更靠谱。456数据把指标口径写成公开定义,和服务器日志是互补而不是互斥的关系;你带着自己的分析目标跑两周,该信哪一边自然有分寸。
说到底,日志和统计工具不是谁取代谁,而是各管一段:一个盯服务器被怎么敲门,一个盯访客真实做了什么。承认双轨共存,对账时就少了一半冤枉。
日常维护上,建议团队把两边的口径和扣减项写成一页纸,定期抽几个页面做一次对账。只要比值稳定在可解释的区间里,差异就是健康的;一旦某个时段比值突然跳变,那才是需要动手排查的信号。
▌ 实操补遗:一笔对账算例与落地口径
口径说明:对账时不要拿两个总数直接比大小,先把差异按来源分桶。算例(示例值,合并提炼):同一统计日统计端 PV 约 8000、服务器日志请求约 12000,差 4000。按四类拆开:爬虫与监控探测请求约 1800(日志有、脚本不跑)、静态资源与重复请求约 1200(不计入页面浏览)、脚本被拦截未执行的访问约 600、CDN 缓存命中未回源约 400。四桶合计约 4000,差异闭合,没有一方算错。
落地五步:一、固定同一统计日、同一时区;二、把日志请求按 UA 先分人工与爬虫;三、剔除静态资源请求得到页面请求数;四、与统计端 PV 对齐时间窗;五、剩余差异归入脚本执行与过滤两类,逐个取证。这个对账表每月跑一次,差异在两成以内属于两套系统的正常口径差,超过两成才需要深挖。
▌ 内容缺口复盘与改进优先级
本文没有展开的部分:具体日志分析工具的操作步骤、日志轮转与保留策略的配置,以及如何用脚本自动对账。这些需要结合各自服务器环境实施,本文只提供口径框架。
按落地顺序排列改进项:P0——固定统计端与日志端的统一时间窗与时区,任何对账先声明这两项;P1——把差异四桶(爬虫、静态资源、脚本未执行、缓存)做成月度对账表,差异在两成内留档;P2——沉淀一份「差异字典」,把已解释过的差异原因固化,避免每次重新争论。
延伸阅读
参考资料
- 网站统计常用指标说明,支撑 PV、UV、IP 数等指标的逐项口径。
- 网站统计接入指南,支撑统计脚本部署位置与采集流程说明。
- MDN Cookie 说明文档,支撑以 Cookie 识别独立访客的技术原理。
- MDN Navigator.sendBeacon 文档,支撑页面关闭时数据上报能力的技术来源。
- RFC 9309 机器人排除协议,支撑爬虫抓取行为的协议依据。
- 百度搜索资源平台,支撑搜索引擎抓取观察的官方入口。