不同统计工具的访客数据为什么不一致
目录索引
- 先把「谁在说谎」放一边
- 识别机制不同,数字天然不会一样
- 九类差异来源逐项过
- 公平比较的六步核查法
- 假设场景:两工具差两成五的核查
- 工具对比结论卡
- 比口径适配,不追数字一致
- 实操补遗:一次两工具对账算例
- 内容缺口复盘与改进优先级
- 参考资料
示例数字仅用于说明口径。
咨询现场常出现这样的画面:同一个站挂着两套统计工具,仪表盘 A 报一万两千 UV,仪表盘 B 报九千,差出两成五。客户指着两块屏幕问,谁在说谎?先请对方把「说谎」这个词收起来——数字不一样,多半不是谁算错了,而是两边从一开始就没在数同一件事。
遇到这类咨询,正确的切入顺序是先比口径再比数字。这类疑问的本质,是访客识别方式、统计时间窗和去重规则三套变量没有对齐。你真要判断哪套工具更可信吗?先别急着下结论,跟着把九类差异和六步公平核查走一遍。
▌ 先把「谁在说谎」放一边
访客数这个指标,看起来是个干净的整数,实际上它由好几个隐含规则共同决定。不把规则摊开,两块仪表盘上的数字就永远没法直接比。
访客数到底数的是什么
以网站端常见口径为例,一天之内的独立访客以浏览器 Cookie 为识别依据,同一访客多次打开只计一次。它数的是「识别得到的不同标识个数」,不是真实人头。一个人换浏览器、清掉 Cookie、用隐私窗口访问,在统计上就可能变成两个访客。
三个前置变量:识别方式、时间范围、去重规则
比数字之前先对齐三件事:用什么识别访客,按什么周期统计,去重以什么为键。识别方式决定「认得出谁」,时间范围决定「在哪段窗里数」,去重规则决定「同一个人被算几次」。任何一个变量不同,UV 出现百分之十几的差异都属正常区间。
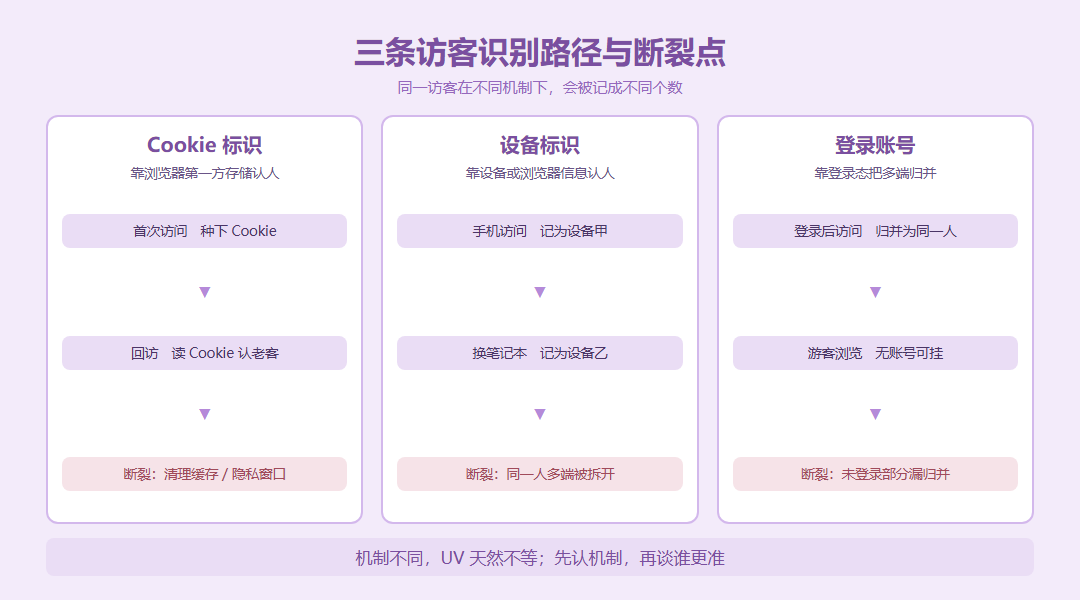
三条识别路径各有断裂点,UV 差异从这里开始产生。
▌ 识别机制不同,数字天然不会一样
两套工具最根本的分野,在于靠什么认出访客。这个差异不解决,后面比什么都白费。
Cookie 标识:最常见也最容易折损
多数网站统计靠第一方 Cookie 认人。问题在于 Cookie 并不稳:用户定期清理、浏览器隐私模式不保留、部分浏览器对第三方存储有期限限制,都会让同一批回头客被重新识别成新访客。Cookie 被折损越多,重复访客被算成新访客的比例越高。
设备标识与登录账号:跨设备各算各的
另一类工具偏向按设备识别,或结合登录账号归并。手机、平板、笔记本对它们来说是三个不同标识,除非用户登录同一账号。没有登录行为串起来时,同一人在多设备间来回,UV 就会被放大。两种机制各有适用场景,硬要数字相等没有意义。
| 识别机制 | 主要依据 | 典型断裂点 | 对 UV 的影响方向 |
|---|---|---|---|
| Cookie 标识 | 浏览器第一方存储 | 清理缓存、隐私窗口、存储期限限制 | 回头客被重复计新访客,UV 偏大 |
| 设备标识 | 设备或浏览器指纹类信息 | 换机、多设备并行 | 同一人多端被重复计数,UV 偏大 |
| 登录账号 | 用户登录态 | 未登录浏览、游客访问 | 未登录部分无法归并,口径偏窄 |
三种机制的区别,决定了它们回答的问题并不相同。Cookie 口径贴近老客复访,设备口径覆盖更宽但容易放大,账号口径最准但只覆盖登录人群。把这些差异理解清楚,比争论谁的数字更漂亮重要得多。
▌ 九类差异来源逐项过
除了识别机制,还有八类常见原因会让两套工具的访客数错开。按影响方向归类,比按现象归类更容易判断哪边偏大。
标识与存储类:Cookie 受限与隐私设置
Cookie 或其他本地存储受限时,无法稳定记住回头客,新访客被重复计算,UV 整体被抬高。隐私设置越严格的访问环境,折损越明显。
采集与过滤类:加载成功率、机器人过滤、跨设备
统计脚本加载成功率不同,部署范围有宽窄,机器人过滤规则松紧不一,跨设备访问的归并方式各异,都会让一边比另一边多出或少掉一截。这类差异往往能通过抽查请求和日志核对出来。
口径类:时区、延迟、指标定义
统计时区不同会让「一天」的边界错开;数据处理延迟会让刚发生的访问一边有一边没有;指标名称相同而定义不同,更是比对时最隐蔽的坑。
| 差异因素 | 使哪边偏大 | 验证动作 |
|---|---|---|
| Cookie 存储受限 | 无法识别回头客的一边偏大 | 抽查重复访问会话,看新访客占比 |
| 浏览器隐私设置 | 隐私环境多的一边偏大 | 对比新老访客结构变化 |
| 脚本加载成功率 | 加载漏的一边偏小 | 在异常页面抽查上报请求是否发出 |
| 机器人过滤松紧 | 不过滤的一边明显偏大 | 对照服务器日志里的自动化请求量 |
| 跨设备归并方式 | 不做账号归并的一边偏大 | 看登录用户与游客的比例结构 |
| 统计时区差异 | 跨零点边界处对不齐 | 把两边时间窗统一到同一时区再比 |
| 数据处理延迟 | 刚发生时段一边有一边无 | 等一个完整周期后再对照总数 |
| 指标定义不同 | 名称相同分母不同 | 逐项核对官方文档里的指标说明 |
| 过滤配置差异 | 排除项少的一边偏大 | 列出两边的排除规则逐条对照 |
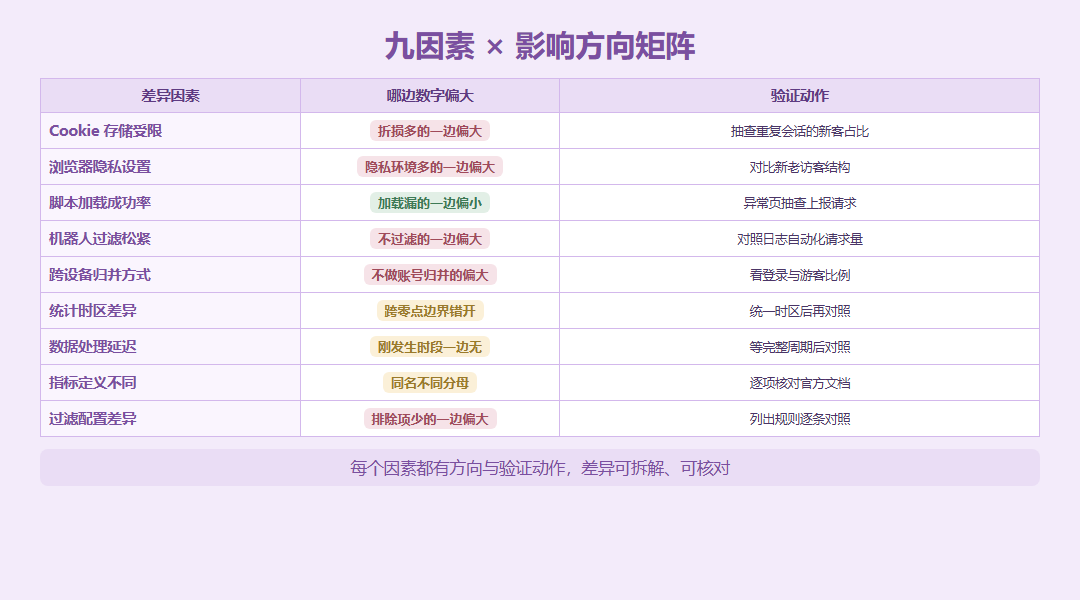
每个因素都有方向和验证动作,差异不再是一笔糊涂账。
▌ 公平比较的六步核查法
差异列出来之后,真正专业的做法是一套固定顺序的公平比较。顺序错了,结论就会带着偏见。
前两步:统一周期,确认指标名称与定义
第一步把两边拉到同一时间范围、同一时区;第二步逐项确认指标名称背后的定义,包括去重键和时间窗。名称一样不算对齐,定义写出来才算。
中间两步:核对部署范围,比对过滤配置
第三步确认两套脚本覆盖的页面和端是否一致,有没有一边只装了部分页面;第四步把两边的排除规则、机器人过滤、内部测试流量清单逐条列出来对照。
后两步:抽查事件上报,日志交叉验证
第五步自己真实访问几次,抽查两边的上报请求是否都成功发出;第六步用服务器日志做交叉参照,看自动化请求和真实请求的结构差异。走完六步,差异大致能归到某一类因素上。
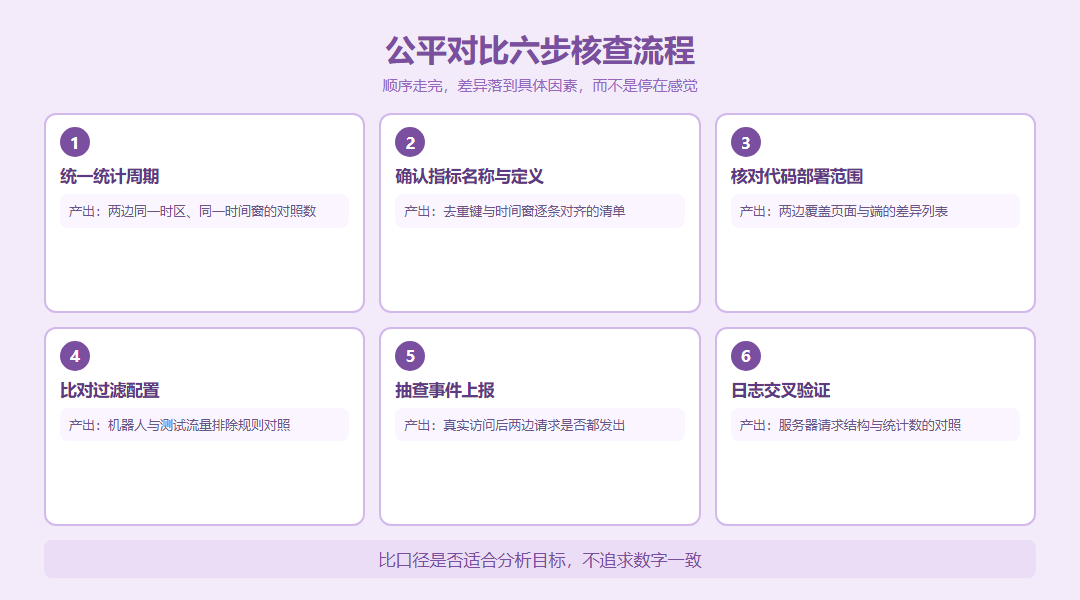
六步走完,差异能落到具体因素上,而不是停在感觉层面。
▌ 假设场景:两工具差两成五的核查
下面把两工具之差核查一遍,场景由多个咨询案例合并提炼,不指向任何真实站点。文中数字为合并提炼的示例值,不代表任何真实站点。
假设场景:一万二与九千之差
客户站点上,一套工具日报 UV 一万两千,另一套报九千。按六步核查:统一到同一时区后差距缩到一成八;确认指标定义时发现,一边的访客按自然日去重,另一边按滚动二十四小时计;核对过滤配置时发现,一边排除了内部测试流量,另一边没有;抽查上报后排除加载失败。最后归因为时区边界、去重周期和测试流量三项叠加,没有任何一边算错。
阶段性判断:不是谁错,是口径不同
这个场景想说明的是:两成五的差距在逐项拆完后,每一项都有合理解释。追求两边数字完全相等,既不现实,也无必要。
▌ 工具对比结论卡
咨询收尾时,我会给客户一张三行判断卡,按分析目标选口径,而不是选数字大小。
三行判断,按分析目标选口径
第一行:要看真实回头客与老客复访,优先看 Cookie 口径干净、过滤明确的工具;第二行:要看跨端整体覆盖,优先看能按账号归并的口径;第三行:要做技术可用性排查,服务器日志的请求记录才是底座。具体选择仍应结合业务需求、数据规模和团队能力判断。
| 你要回答的问题 | 更合适的口径类型 | 不必纠结的点 |
|---|---|---|
| 内容对老访客还有没有吸引力 | Cookie 去重、新老客结构清晰的口径 | 与另一套工具差几个百分点 |
| 多端用户整体有多大盘子 | 支持账号归并、跨设备识别的口径 | 单端数字是否对得上 |
| 站点到底有没有被正常访问 | 服务器日志的请求记录 | 日志与统计数是否逐分一致 |
▌ 比口径适配,不追数字一致
选工具本质上是选一套和分析目标匹配的口径。456数据在指标说明里写得很清楚:网站端以 Cookie 去重,App 端按设备去重,口径公开列在文档里。把两套口径并排摆出来,比纠结哪个数字更对更有意义。你带着自己最常回答的三个问题去对一遍文档,哪套口径顺手,两周之内自有判断。
▌ 实操补遗:一次两工具对账算例
算例(示例值,合并提炼):工具 A 的周 UV 约 5000,工具 B 约 4300,差约一成四。逐项归因:Cookie 有效期设置不同解释约六个百分点、隐私模式下 A 的脚本被拦截解释约五个百分点、机器人过滤口径差异解释约三个百分点。三因素合计与实测差值吻合。结论:一成多的差异在可接受区间,不必强行调成一致。
落地五步:一、统一按周维度对比,单日波动噪声太大;二、分别记录两边的 Cookie 策略、过滤规则与时区;三、对同一批落地页做 A/B 加载对比;四、差异在一成五以内记录备查,超过两成才深挖;五、选定一方作为对内权威口径,另一个只做交叉验证。两工具永远不会完全相等,管理目标是「差异可解释」,不是「数字完全一样」。
▌ 内容缺口复盘与改进优先级
本文没有展开的部分:两款具体工具的配置对比实验、服务器端日志与统计端的三方对账,以及跨设备身份打通的技术方案。本文只解释差异来源。
按落地顺序排列改进项:P0——统一按周维度对比两工具,单日噪声过大;P1——把两边的 Cookie 策略、过滤规则、时区差异写成对照文档;P2——对内选定一方作权威口径,另一方只做交叉验证,不再追求数字完全相等。
延伸阅读
▌ 参考资料
- 网站统计常用指标说明,支撑 UV 去重口径与指标定义的文字依据。
- 网站统计接入指南,支撑脚本部署范围与接入方式的说明。
- MDN Cookie 说明文档,支撑 Cookie 识别与存储限制的技术背景。
- MDN localStorage 文档,支撑本地存储类识别机制的技术依据。
- 百度搜索资源平台,支撑搜索渠道与自动化请求观察的公开入口。