如何建立网站数据异常监控与处理机制
目录索引
- 监控为了什么,告警不等于结论
- 建机制要做的六件事
- 指标分三层,别滥监控
- 阈值怎么定:松严之间找平衡
- 完整处理流程:十步闭环 SOP
- 假设场景:一次数据中断告警的全程
- 可打印的异常处理 SOP 单页
- 实操补遗:一次阈值设定的算例
- 内容缺口复盘与改进优先级
- 参考资料
示例数字仅用于说明口径。
一条告警弹出来,从增长负责人到技术,九个人、六个判断节点才走完一次处理。你有没有想过:这六个节点如果没提前约定,告警只会让所有人一起慌。告警本身不丢人,丢人的是告警响了半天,没人知道下一步该谁动、动什么、动完怎么算完。
数据异常监控要回答一个根本问题:用户行为洞察看访客转化从哪一步漏,性能监控看页面有没有拖后腿,可这些都得先有一套告警机制兜底。那么,你现在的告警,是真的在帮你发现问题,还是只是在制造焦虑?差别往往不在工具有多强,而在机制有没有把人和步骤约定清楚。下面就把这套机制从建到跑,从头到尾地完整说一遍。
▌ 监控为了什么,告警不等于结论
持续监控能帮你及时发现访问量异常波动、数据中断、事件采集失败和转化异常,但有一条必须先讲清楚。把这条想明白,后面的机制才不会建偏。
告警只是起点
一条告警只说明「这个数字越过了我们设的线」,它绝不等于已经确认故障原因。告警说 PV 跌了,可能是真跌,也可能是采集断了,还可能是只是延迟。把告警当成结论直接改代码,是最常见的过度反应。正确姿态是:告警响了,按流程走一遍,再下判断。把「告警」和「事故」划等号,团队会越来越累,真正的事故反而被误报淹掉。
不要把所有指标都挂上告警
监控指标不是越多越好。给每个数字都配一条线,结果就是告警刷屏,真正重要的反而被淹没。先问这个指标异常时谁会真的动手、动什么,答不上来的指标就先别挂告警。监控是为了驱动动作,不是为了好看。与其挂二十条没人理的告警,不如把五条关键指标的阈值和流程打磨顺。
▌ 建机制要做的六件事
一套能跑起来的异常监控机制,落地前要把六件事想清楚,缺一件都会在第一次告警时露馅。这六件事看着平常,真正出问题时才发现,多数团队卡的不是工具,而是这些约定没提前写下来。
选指标、定周期、建基线
先选关键指标,再定监控周期,然后用一段历史数据画出正常基线。没有基线,阈值就无从谈起。基线至少攒上几周,把星期效应和节假日波动先纳进来,否则头几天的告警全是误报。个人站和小团队不必追求实时,按小时或按天看往往就够;大流量站才需要盯实时采集成功率。
异常条件与负责人
接着定异常判断条件、记录统计口径的每一次变化、写清异常发现后的负责人和处理步骤。口径变了不记录,过两个月没人说得清今天的数为什么和上次不一样;负责人不写清,告警响了就是一起等。条件尽量写成可执行的话,比如「较前一周同日跌超三成」,而不是「明显下降」这种模糊描述。
▌ 指标分三层,别滥监控
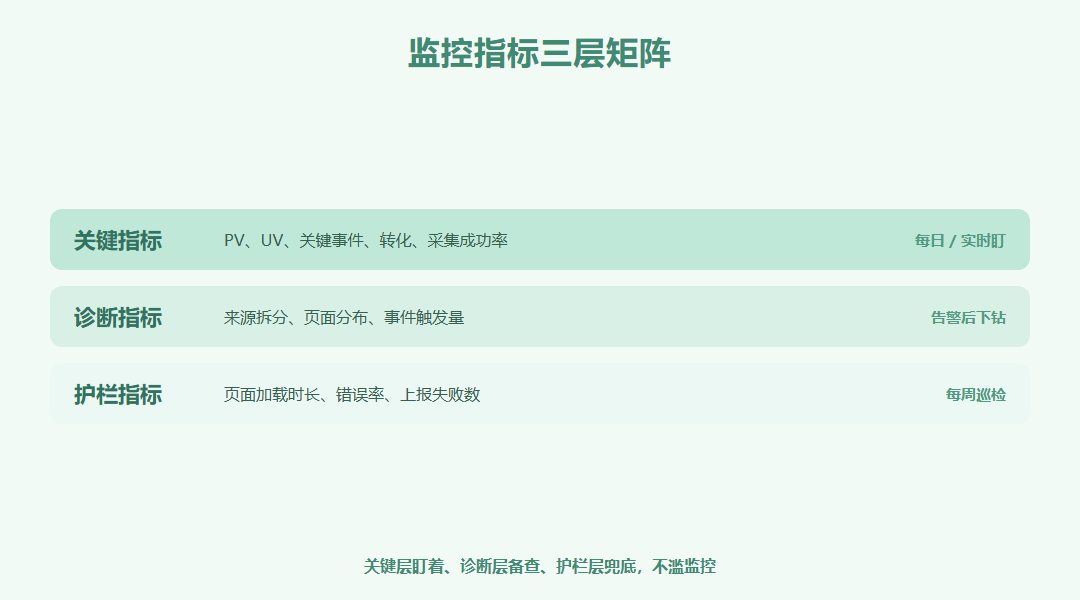
把监控指标分成三层,关键层盯着、诊断层备查、护栏层兜底,既不漏真问题,也不被噪声拖垮。分层的好处是告警有轻重:关键层一响就要响应,护栏层异常先记着,不必每次都惊动全员。
| 层级 | 指标举例 | 看的频率 | 异常时谁先动 |
|---|---|---|---|
| 关键指标 | PV、UV、关键事件、转化、采集成功率 | 每日 / 实时 | 增长负责人 |
| 诊断指标 | 来源拆分、页面分布、事件触发量 | 告警后下钻 | 数据分析 |
| 护栏指标 | 页面加载时长、错误率、上报失败数 | 每周巡检 | 技术 |
关键层盯着、诊断层备查、护栏层兜底,三层各管一段。
▌ 阈值怎么定:松严之间找平衡
阈值是监控机制里最容易被拍脑袋、也最影响体验的一环。松一点紧一点,后果完全相反。下面把两个方向分别说清,免得你反复试错。
松误报多、严漏报多
阈值松(设得低),一丁点波动就触发,误报多、告警多,团队很快就会把告警群静音;阈值严(设得高),只有大变故才响,漏报多,真出了问题反而没被及时发现。两种极端都不可取,阈值要按历史规律和业务目标逐步调整,而不是一次设死。宁可先松一点、把误报摸清楚,再慢慢收紧,也不要一开始就把线拉得很高。
命中率月度统计、季度复盘
怎么知道阈值合不合适?看告警命中率:月度统计每一百条告警里,有多少条最后被证实是真问题。命中率长期偏低,说明阈值太松;一个季度下来几乎不响,又出了没被发现的事故,说明太严。把月度命中率攒起来,季度复盘一次,再决定松一点还是紧一点。这个调整动作要写进节奏,不能靠感觉。
▌ 完整处理流程:十步闭环 SOP
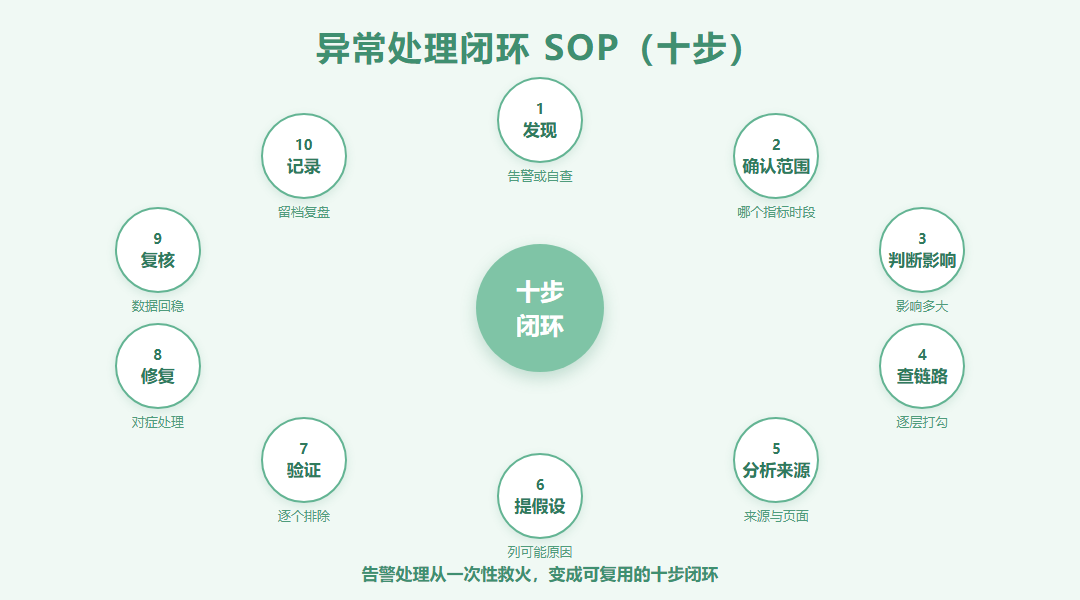
告警响了之后,从发现到记录要走完整十步,少一步都会让下一次更慌。
从发现到记录的十步
第一步发现异常,第二步确认数据范围,第三步判断影响程度,第四步检查采集链路,第五步分析流量来源和页面分布,第六步提出原因假设,第七步验证假设,第八步执行修复,第九步复核恢复情况,第十步记录整个处理过程。十步首尾相接,每一步都有明确产出,异常处理才是闭环,而不是头痛医头。其中第二步和第三步最容易被跳过——告警一响就扑上去改代码,往往改完才发现范围都没圈对。
十步首尾相接,告警处理从一次性救火变成可复用的闭环。
▌ 假设场景:一次数据中断告警的全程
下面把这次告警按 SOP 全程走一遍,场景为合并提炼,不对应任何真实团队。某天早上,一条采集成功率下跌的告警弹出,示例值(合并提炼),非真实数据,团队按 SOP 走了一遍。你可以把它当成一次演练,对照自己的机制看看每一步缺什么。
告警响起到确认范围
增长负责人先确认:跌的是全站 PV 还是单页?是真跌还是采集断了?核对实时访客后发现访问还在、只是上报少了,范围被圈到采集链路,而不是业务出了问题。这一步花了十分钟,避免了一次无意义的业务复盘。如果一开始就拉运营去想是不是投放停了,方向就偏了。
排查、修复与复盘
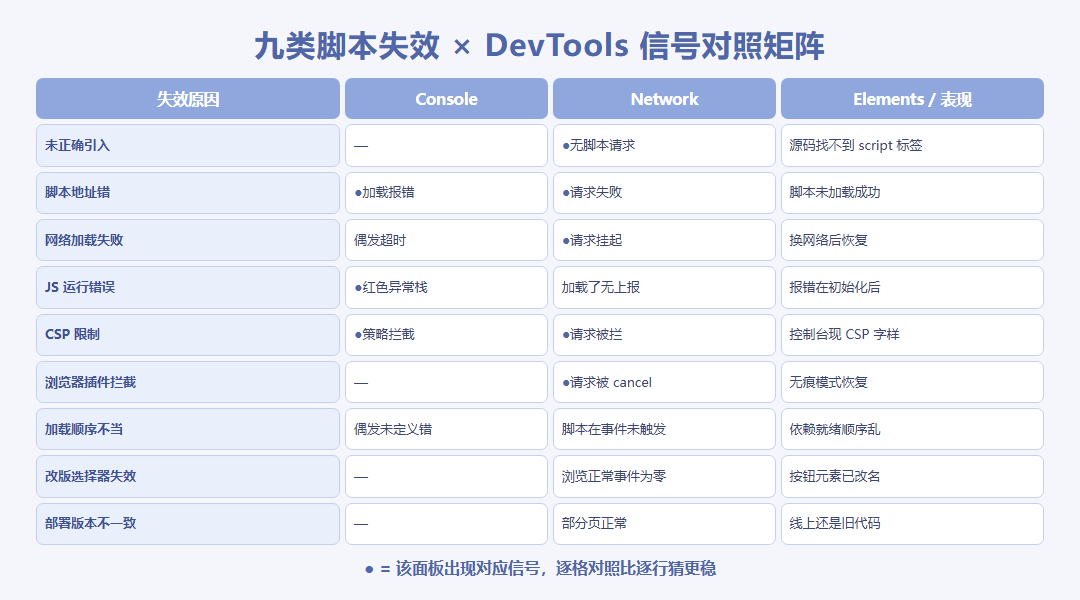
技术沿链路查到某类页面的脚本在改版后没加载,补上后采集成功率回稳。复核两天数据正常,最后把这次断点、证据、修复动作写进记录。月底统计命中率时,这条被算进真问题;季度复盘时,团队把发版后的观察动作又加进了 SOP。机制就是这样一轮一轮被磨顺的。
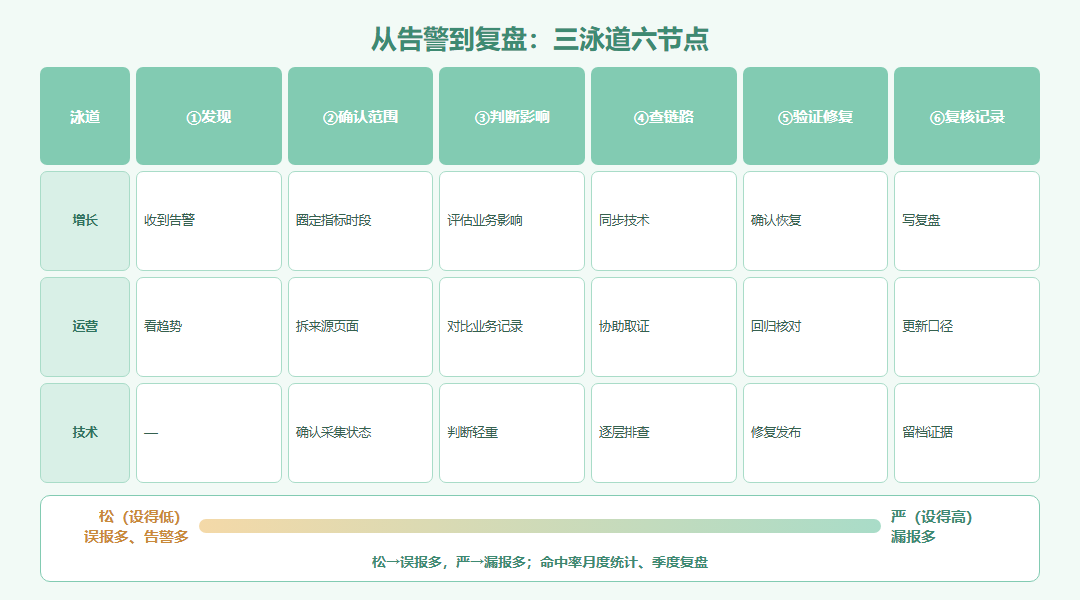
三泳道六节点走完一次告警;阈值轴左松右严,松则误报多、严则漏报多。
▌ 可打印的异常处理 SOP 单页
机制写在文档里没人看,打印出来贴在工位旁才有人用。下面这张单页可以直接照抄,按自己团队填好每一格,比任何长篇流程文档都管用。
把 SOP 打印出来贴在工位
一页纸讲清指标、基线、阈值、负责人、流程和复盘节奏,告警一响谁都知道该干什么。阈值方向也写在这一页上:阈值松(设得低)误报多、告警多;阈值严(设得高)漏报多;命中率月度统计、季度复盘,按历史规律和业务目标逐步调整。新同事入职,先看这一页就知道数据出问题该找谁。
| 项目 | 这一页上要写清的内容 |
|---|---|
| 指标 | 关键指标有哪几个,各自由谁盯 |
| 基线 | 正常波动区间是多少,攒了几周数据 |
| 阈值 | 松误报多、严漏报多,按业务目标逐步调 |
| 负责人 | 告警响了第一个找谁,谁来收尾 |
| 流程 | 十步闭环每步大概花多久、产出什么 |
| 复盘 | 命中率月度统计、季度复盘一次 |
监控不是配几个告警就完事,真正的工作量在画基线和写处理流程。456数据的智能预警在基础版起即可设置,具体档位以官网定价页为准,但告警只是起点,命中率和复盘节奏才决定这套机制有没有用。你把这张 SOP 单页打印出来跑两个季度,阈值松严怎么调、告警响了谁先动,团队心里自然有数。要不要现在就动手,先把五条关键指标和它们的负责人写下来,是你下一步要做的事。
▌ 实操补遗:一次阈值设定的算例
算例(示例值,合并提炼):先选三个最痛的指标(全站 UV、核心转化事件、关键来源流量),基线取近 28 天同时段均值加减两个标准差。刚上线时阈值太紧,一天告警七八次,团队麻木;放宽到两个标准差后,每周两三次,每次都值得看。触发后流程是:确认真假(拆来源与页面)→圈定范围→查采集链路→验证修复→复查恢复。
落地四步:选指标(不超过五个,先跑最痛的)→建基线(至少 28 天历史)→定阈值(宁松勿紧,按月校准)→定负责人(每条告警有归属)。监控机制的价值不在告警多,而在每条告警都能在当天闭环。
▌ 内容缺口复盘与改进优先级
本文没有展开的部分:值班排班与 SLA 的设计、告警收敛与降噪的工程实现,以及多级告警的路由策略。本文只给机制框架。
按落地顺序排列改进项:P0——先把最痛的三五个指标监控起来,不追求一步到位;P1——跑一个月后按误报与漏报校准阈值;P2——机制稳定后再扩指标数量与自动化程度。
延伸阅读
▌ 参考资料
- 网站统计常用指标说明,支撑关键指标与转化类指标的口径依据。
- 网站统计接入指南,支撑采集链路与异常排查的接入背景。
- 隐私政策,支撑数据留存与监控记录的公开说明。
- 产品价格与套餐说明,支撑智能预警等能力档位的查看入口。
- MDN Navigator.sendBeacon 文档,支撑采集上报链路的技术背景。