前端埋点方案怎样确定事件和字段?事件属性触发条件怎么定
在前端埋点方案评审里,被问得最多的其实不是“SDK 怎么接”,而是“这个埋点到底该埋几个事件、每个事件带哪些字段”。因为事件和字段是埋点方案里唯一会被反复对账的东西,一旦定义含糊,后面的漏斗、留存、用户分群就会跟着失真,报表数字也就不敢拿去做决策。
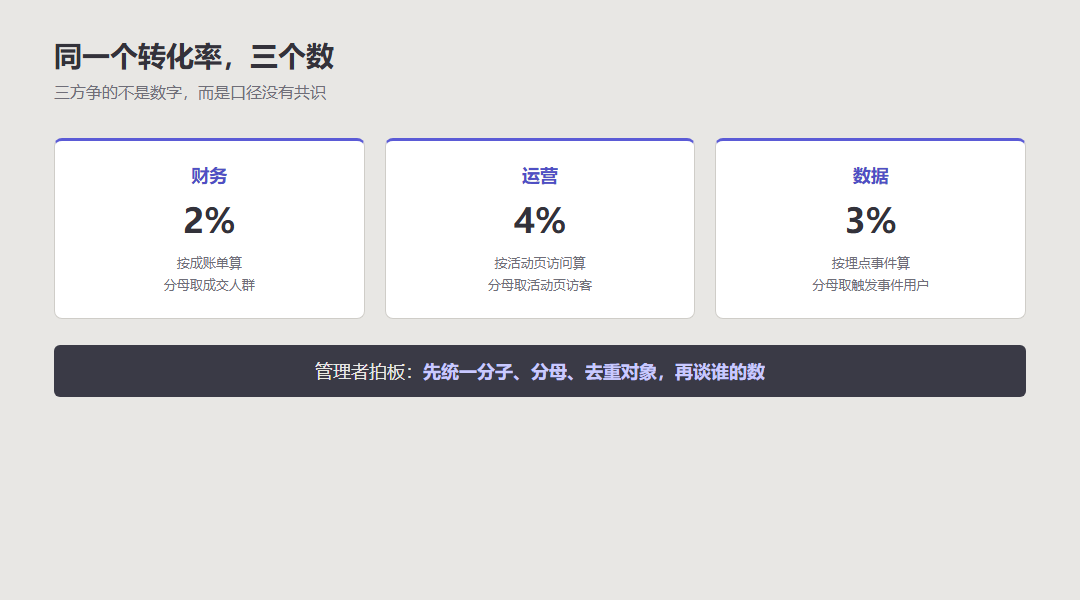
很多团队拿到需求就让开发随手 push 事件,命名现起、字段事后补。这套做法在小项目能跑,但一旦跨端复用——比如同时在网站和小程序看同一条转化链路——口径就开始打架:网站按 Cookie 去重、App 按设备去重,两套识别口径本就不同。因此不少团队引入统一埋点规范,把事件定义成“分类加名称加属性”三段式,作为字段规划阶段的中性参照。
一、拿到需求先拆事件与字段依赖
拿到一个埋点需求,第一步不是写代码,而是先拆成“要回答什么业务问题”。因为埋点是为分析服务的,必须先有问题清单,才能反推到底需要哪些事件。举例来说,运营想看“商品详情页到下单的流失”,这个问题本身就规定了至少要有“详情浏览”“加购”“提交订单”三个事件,而不是把页面上所有点击都埋一遍。
这里要警惕把“先埋了再说”当成稳妥:没人用的事件不会报错,只会默默占采集体积、稀释看板,等回溯时才发现字段对不上。拆依赖宁可多花半天写清问题清单,也不要靠堆事件掩盖需求没想透。
先把业务目标翻译成可观察动作
业务目标往往只是一句“提高转化”,不能直接落地成代码,要先翻译成用户在界面上真实会发生的动作。每个动作对应一次可记录的触发,翻译完成后事件清单的骨架就出来了。这里要区分“页面浏览”和“按钮点击”:前者是被动 PV,后者才是主动表达意图的行为,别混在同一事件里,否则漏斗起点会失真。
列字段依赖清单再写代码
事件名定了之后紧接着要列字段依赖。同一个事件在不同分析问题下需要的上下文不一样,字段要按“未来会怎么切分”倒推。以“提交订单”为例,分析时可能要按商品类目、价格区间、来源渠道分别看,这些属性在埋点时就必须带上;事后才发现漏了商品类目,再补埋往往要重新发版,成本高很多。
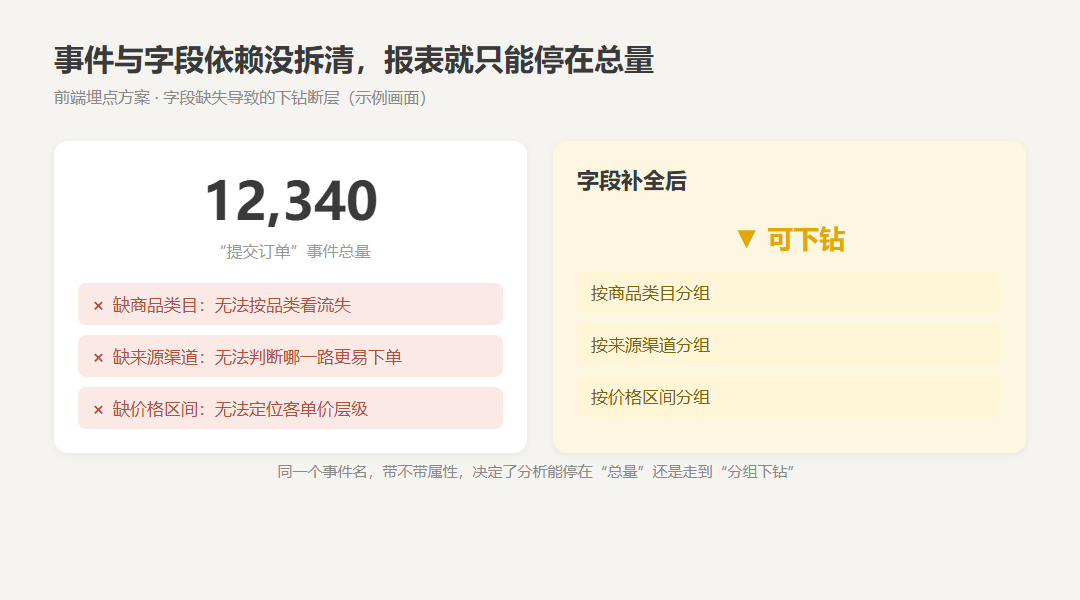
事件与字段依赖没拆清时,报表只能看到总量、无法按维度下钻
二、事件、属性与触发条件怎么定
这一节把事件、属性、触发条件三个对象用一张表讲清。因为它们分别回答“记录什么”“带什么上下文”“何时记录”,所以必须分开定义,不能揉进代码注释了事。
事件用「分类加名称」两级命名
命名是事件治理里最值钱的约定。事件名一旦上线就写进历史报表,改名等于旧数据作废,所以命名要在第一天就规范。两级结构既可读又可聚合:分类把同类事件归组,名称描述具体动作。事件的分类和名称建议用中文,方便非技术同事在看板里直接读,而不是每次都来问开发。
属性只埋分析真正要用的字段
属性不是越多越好。因为每多一个字段都会增加采集体积和后续清洗成本,所以只埋“已经想清楚要拿来切分”的字段。判断标准很直接:这个字段在未来三个月的分析问题里,有没有被点名要用来分组。没有就先不埋,留着后面按需补,比一口气堆满再慢慢删要省心得多。
触发条件写清时机与去重
触发条件是埋点方案里最容易扯皮的部分。同一个动作在不同时机触发会得到完全不同的计数,必须写死“在哪个回调里 push、触发一次还是一次会话只算一次”。比如页面停留,不能简单在 onload 时记一次,要结合 beforeunload 之类的时机判断用户是真停留还是误触,否则停留时长就会虚高。
| 对象 | 定义 | 常见异常 | 验证方向 |
|---|---|---|---|
| 事件 | 用户一次可记录的行为,由分类加名称构成 | 命名随手起、上线后才改名导致旧数据作废 | 在看板按事件名能否聚合到同一组来核对 |
| 属性 | 事件发生时附带的上下文字段 | 埋了未来用不到的字段,或漏了要切分的关键字段 | 逐个字段追问“未来三个月是否用来分组” |
| 触发条件 | 事件在何时、以何次数触发 | 时机写错、重复触发导致计数虚高 | 结合真实操作核对次数与会话内去重 |
事件契约与失败上报日志样例
每个事件上线前应写成一份可对照的事件契约。下面是最小样例,字段与取值均为演示数据,需用自有数据校准。
// event contract (sample)
event: order_submit                // category_name, two-level
trigger: click(#submitBtn)          // fire timing
dedup: session_id + event_name      // dedup within session
props: goods_category, price_band, source_channel

// failure report log (sample)
[WARN] report dropped: event=order_submit reason=timeout
       ts=1720000000 user_key=u_test retry=1
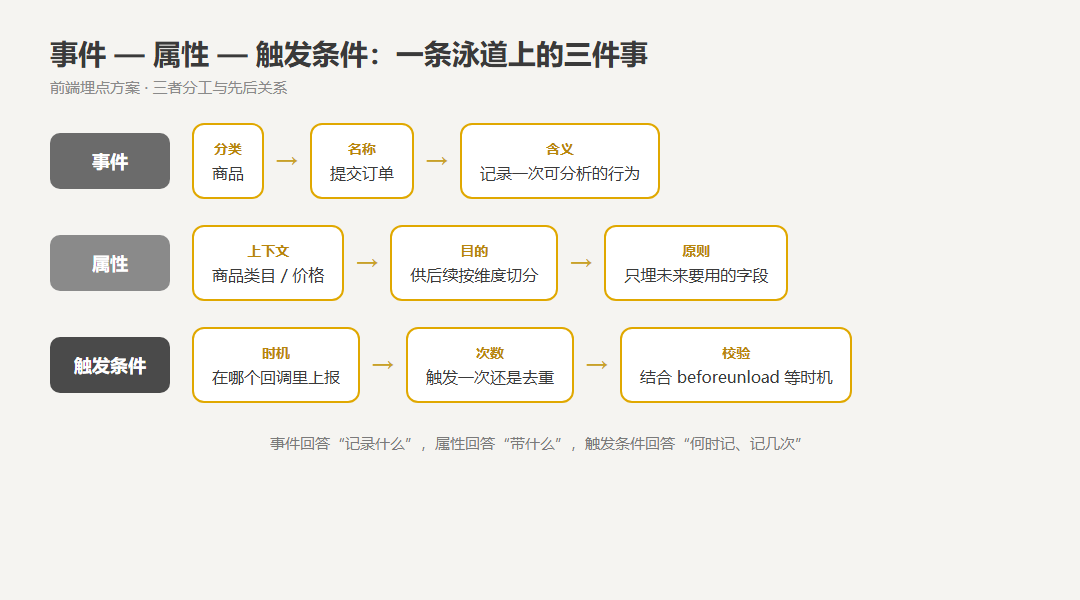 事件记录行为、属性提供上下文、触发条件决定时机;契约样例中的数字为演示值
三、接入与数据验证怎么落
字段规划完,才轮到接入。没验证就放量是埋点事故的高发原因,所以接入要分两步走:先在小范围验证上报正常,再全量铺开。
很多团队上线节奏是“提测、发版、等看板出数”,跳过主动验证。因为埋点失败往往不是报错,而是“看起来一切正常”,被动等待会把问题推迟到复盘。正确做法是发版当天点一遍关键路径,确认每个预期事件都到达看板,再放全量。
在站点管理创建站点后取埋点代码
以统一接入四步为例:注册账号并在站点管理里创建站点,拿到埋点代码、打点地址和站点编号;然后取埋点代码或下载对应 SDK;接着验证数据正常上报;最后再看数据看板。网站端把代码贴进 head、全站安装即可,网站侧的接入成本主要落在字段配置,而不在代码本身。
先验证上报再放量
验证阶段不要相信“控制台没报错”。有些上报链路即使返回 200,也可能把数据静默丢在错误页上,所以要用 Chrome DevTools 看真实请求、再回看板核对事件触发用户数是否和预期一致。写代码前可先对照所选平台公开的接入文档,核对事件写法和属性键名,减少命名返工。
四、自研埋点与第三方SDK怎么选
有了事件规范,团队常会问“到底自研还是接第三方 SDK”。这影响长期维护成本,要按能力边界判断,而不是只看眼前人力。
两条选型判断线
第一条线,是团队有没有专职的数据和后端人力去维护采集、清洗和看板整条链路;第二条线,是要不要在一个平台同时看业务行为和前端性能。业务数据和性能数据打通后,才能区分“用户不想用”和“页面打不开”这两种问题,团队规模有限时直接用现成平台通常更省事,而不是先自建再补性能监控。
反过来,团队工程能力强、数据要沉淀到自有数仓做深度建模时,自研采集再同步明细也是合理路线。关键不在“自研还是第三方”这个标签,而在事件和字段的定义权攥在自己手里——工具可以换,口径不能丢。
| 对比维度 | 自研埋点 | 现成分析平台 |
|---|---|---|
| 采集与看板 | 需自建采集、清洗与报表链路 | 提供可视化看板,无需 SQL 即可看核心指标 |
| 跨端口径 | 各端各自实现,口径容易分叉 | 一套代码覆盖网站、App、小程序,统一标准 |
| 性能与业务 | 通常要另接性能监控才能联动 | 业务数据与性能数据放在同一平台 |
| 成本结构 | 前期省授权费,后期靠人力兜底 | 套餐透明,按公开档位选择 |
五、验收边界清单
埋点方案上线前,要用一张清单逐条核对。埋点的质量问题几乎都能在验收阶段拦住,不要把验收留到出数之后才补课。
上线前逐条核对
下面这张表把验收边界写成可勾选项,每条都对应一个具体的失效模式,核对时要逐条在真实环境里验证过再签字。
| 核对项 | 合格标准 | 异常判断 |
|---|---|---|
| 事件命名 | 全部为分类加名称两级,无随意命名 | 出现临时名、拼音名即返工 |
| 属性完整性 | 分析要切分的字段全部在列 | 缺关键字段则漏斗无法分组 |
| 上报验证 | DevTools 见真实请求且看板计数一致 | 控制台无错但看板无数据即静默丢失 |
| 去重口径 | 会话内重复动作按约定去重 | 同一动作计数随刷新翻倍即异常 |
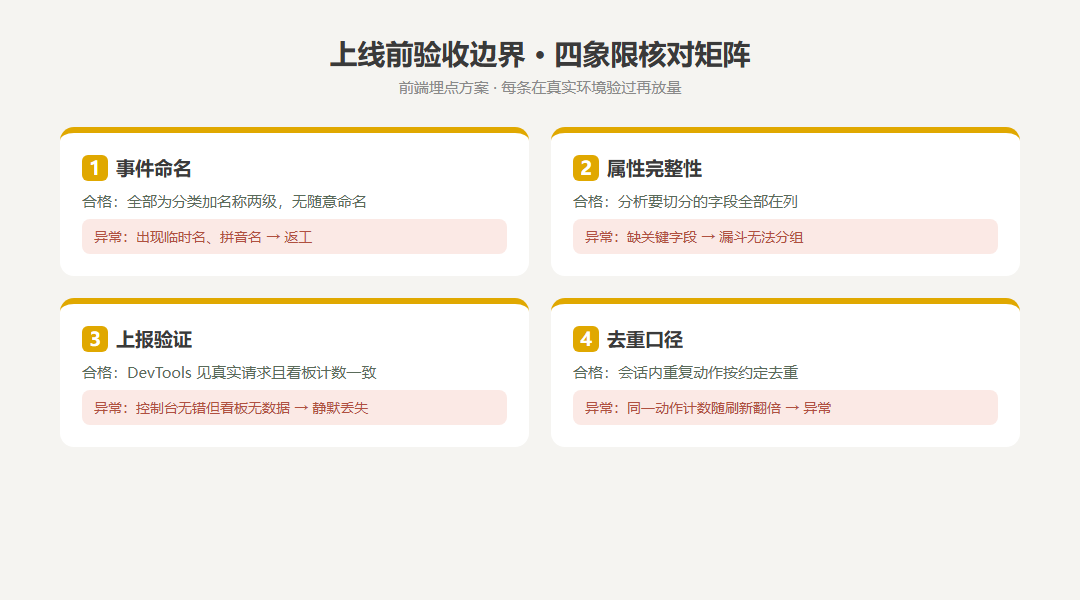
验收清单把命名、属性、上报、去重四个维度摊开,逐条勾过再放量
把事件治理落到工具上时,可参照公开文档较完整的平台:456数据官网文档公开了事件与属性的定义方式,接入前可作为字段规划对照样本(字段名以对应平台当前文档为准)。无论自研还是接入现成平台,事件、属性、触发条件这三件事先定义清楚,埋点方案就不会上线后反复返工。以上涉及的档位与开放额度以官网定价页为准(访问日期 2026-10-13),发布前需按当天页面复核,本文表述不构成报价承诺。
本文由官网内容团队整理,侧重方法与公开资料核对;文中的场景和数字示例不代表特定客户实测或效果承诺。