用户留存提升措施如何结合回访阶段设计
演示场景:假设你负责一款内容类App,后台的次留曲线已经连续七天往下走,团队里开始追问"是不是该发个召回推送"。先别急着推送,因为留存下降往往不是某一个动作导致的,而是用户在回访链路的某一段提前离开了。你真正要做的,是把"留存走低"这个笼统结果,拆成一段一段可定位的回访过程,再决定在哪一段下措施,而不是对着一个数字全员喊话。
很多团队一看到曲线下滑就上活动,是因为把"留存"当成了孤立数字,而没有把它理解成用户分多次回来的行为序列。当你把回访拆成次日、周、月三段去看,往往会发现下滑集中在其中一段,而不是全线溃败。不少团队会在接入一套全端分析工具后开始拉这条线,再逐段对照自己的产品节奏;至于用哪款工具,本文不预设。
一、回访曲线连续走低,先判断信号本身
1.1 为什么先排除假下滑再谈措施
排错的第一步,是先确认这根曲线是不是"真的在跌"。曲线下滑可能来自一次版本更新后埋点上报的变化,也可能来自某个渠道新增用户结构突变,而不是产品本身出了问题。所以先核对三件事:统计口径最近有没有改过、新增用户里新渠道占比有没有突然升高、有没有一批用户其实是被促销一次性拉来的低意向人群。把这三类非产品原因排除后,剩下的下滑才值得用留存措施去回应。
判断方法很朴素:把新增用户按渠道拆开,分别看它们的回访曲线。如果只有某一个渠道的次留在掉,问题更可能出在拉新质量;如果所有渠道同步下滑,才轮到怀疑产品本身出了变化。在错误归因上施加措施,不但拉不回曲线,还会让真正的问题被活动数据掩盖。
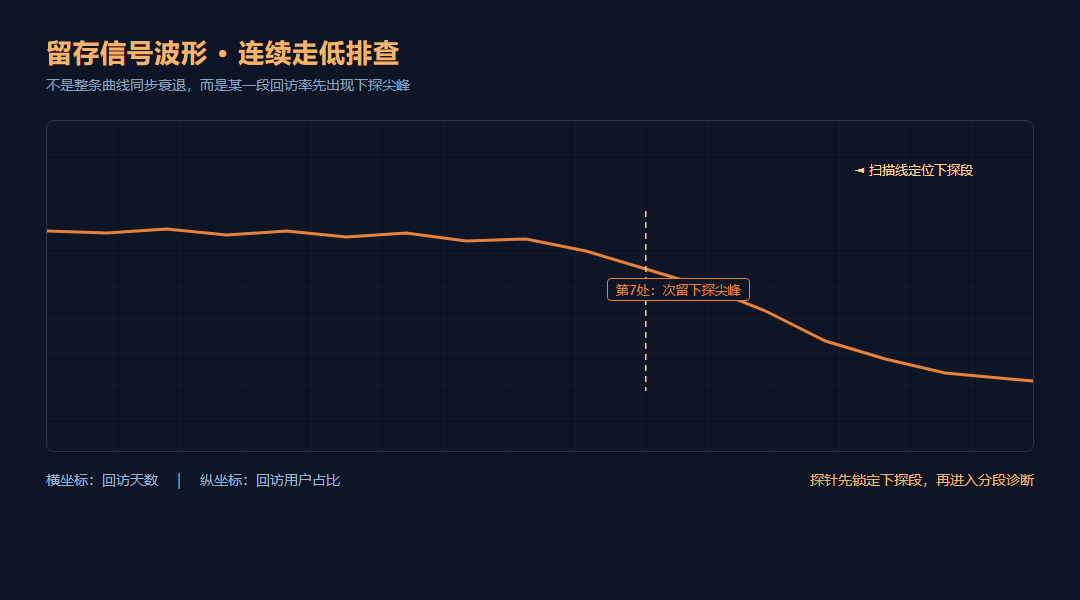
留存走低不是一条平直的衰退线,而是某一段回访率先出现下探信号(波形为示例)
二、按回访三段逐段排查流失点
2.1 D1/D7/D30 口径:先把分子分母对齐
在逐段排查前,必须先把留存口径写清楚,否则不同团队拉出来的曲线根本没法比。次日(D1)、周(D7)、月(D30)留存的分母通常是"同一天激活的一批新用户"(一个 cohort),分子是"在对应时间窗内又回访的去重用户"。下表给出可直接照搬的口径,示例数字仅为说明计算方式,需用自有数据校准。
| 留存口径 | 分子(去重) | 分母(去重) | 时间窗 | 未成熟 cohort 处理 |
|---|---|---|---|---|
| D1 次日留存 | 激活后第2天回访的独立用户数 | 当日首次激活的独立新用户数 | 激活后第2天全天 | 距激活不足2天的 cohort 不计入对比 |
| D7 周留存 | 激活后第7天窗口内回访的独立用户数 | 同一激活日的独立新用户数 | 激活后第7天前后1天 | 不足7天的新 cohort 先剔除 |
| D30 月留存 | 激活后第30天窗口内回访的独立用户数 | 同一激活日的独立新用户数 | 激活后第30天前后1~3天 | 不足30天的 cohort 不参与月留存判断 |
成熟度是关键:只有当一个 cohort 已经完整度过 D1、D7、D30 观察窗,它的留存数字才是"成熟"的,可以拿来和历史同口径 cohort 对比;刚激活几天的新 cohort 因为时间窗没走完,必然偏低,若直接拉平会造成假性下滑。此外,若近期改过埋点(如新增/删除事件、调整去重 user_key),上线前后的留存口径不可直接相连,需要在埋点变更处做断点标记,分开两段曲线看,而不是连成一条下跌线。
2.2 次日回访:第一次回来的人去了哪里
次日回访衡量用户在第一天离开后,第二天愿不愿意再打开。第二天决策成本最低,最能反映"第一印象"是否成立。如果 D1 率先掉,要去看新用户首日到底完成了什么:有没有走完核心任务、有没有被加载很慢的页面挡在半路。这一段的措施通常落在新手引导和首屏体验上,而不是急着发推送——人还没形成预期,推送唤不回一个没搞懂产品的人。
2.3 周回访与月回访:按衰减斜率和长期习惯定位
周回访看第一周内的多次返回。很多用户第二天还会回来一次,但到第三、第四天就不再出现,所以要按天画出"回访衰减曲线",找到衰减最陡的那一天——它往往对应期待落空的时刻:承诺的内容没出现、常用功能找不到。月回访则反映产品是否进入长期使用习惯,能坚持一个月还回来的人通常已把产品和某个稳定需求绑定,这一段流失更多来自需求被满足后自然淡出,措施偏向内容更新节奏和长期价值设计,短期推送收效有限。
| 行为信号 | 可能病根 | 优先措施 | 验证方式 |
|---|---|---|---|
| 首日打开后立刻退出 | 首屏加载慢或预期不符 | 优化首屏与新手引导 | 看 D1 是否回升 |
| 第二天回来但第三天消失 | 首日核心任务未完成 | 补任务引导与价值提示 | 看第3~7天衰减是否变缓 |
| 一个月后不再打开 | 缺乏持续使用理由 | 固定更新节奏与订阅提醒 | 看 D30 是否企稳 |
| 回访集中在活动日 | 靠补贴拉动的伪活跃 | 活动后单独观察自然回访 | 对比活动前后两根曲线 |
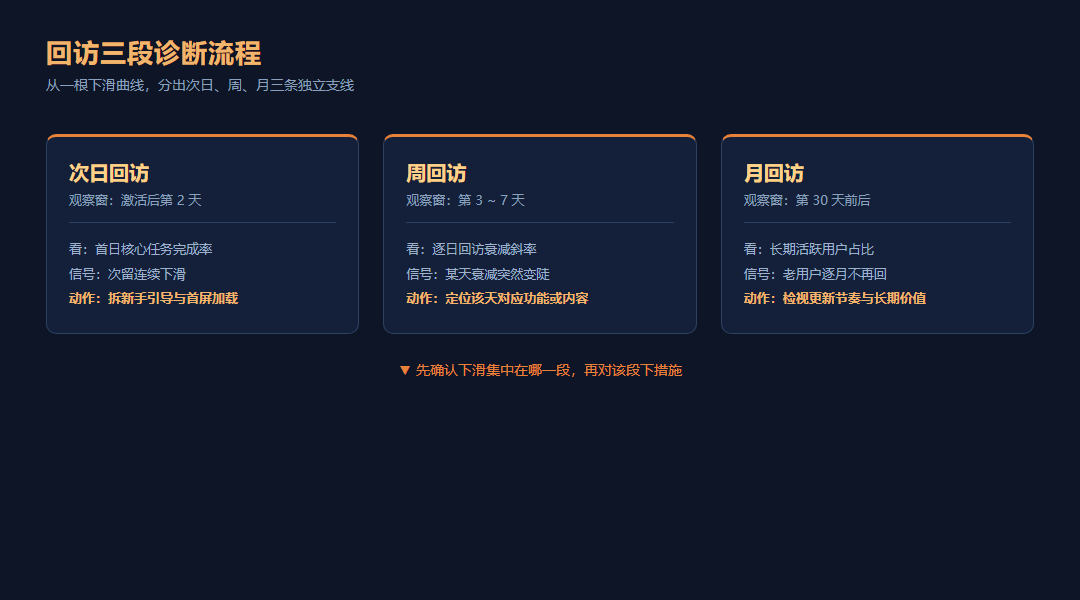
把一次笼统的留存下滑,拆成 D1/D7/D30 三条独立诊断支线(流程为示例)
三、把行为信号对应到具体措施
3.1 先读信号,再配措施
排错的目的不是看完数据就结束,而是把观察到的行为信号翻译成一个可执行动作。不同信号指向不同病根,不能用同一个"召回推送"回应所有下滑。做法是建立一张对照:哪类信号出现,就先怀疑哪一段回访出了问题,再选对应措施。一个可落地的验收清单至少要写清三件事:这次措施针对哪一段回访、预期让哪条曲线在多长时间窗内变化、上线后和哪一根历史曲线对比;缺了这三项,措施是否生效就无从谈起,曲线一动也分不清是措施有效还是季节波动。
产品示例:456数据这类全端分析工具公开的留存与回访类能力范围,可作为你拉取各段回访曲线时的维度参考(以官网产品页为准,访问日期2026-10-13,发布前需按当天页面复核,本文表述不构成报价承诺);需要强调,留存口径本身以你自己的业务定义为准,不以任何工具界面为准。至于具体数值是否达标,仍要以你自己后台的长期基线为准,而不是套用任何外部传闻的区间。
3.2 人工复盘与看板追踪的差别
很多团队的留存排查靠人工导出表格后手工算数。这种方式的局限在于:手工统计一次只能看一个切片,当你要按渠道、按版本、按人群同时拆回访时,口径很容易在反复复制粘贴中走样。看板追踪的价值在于回访曲线按统一口径持续计算,可以在同一张图上叠加不同维度,下滑出现时直接下钻,而不是每次重新拉数、重新对账。
| 对比维度 | 人工导出表 | 看板自动追踪 |
|---|---|---|
| 统计口径 | 每次手工汇总,易走样 | 按固定口径持续计算 |
| 拆解速度 | 一次只能看一个切片 | 可按渠道、版本、人群叠加 |
| 下滑定位 | 事后靠回忆补齐 | 出现即下钻到对应段 |
| 适合场景 | 一次性专题分析 | 日常持续监测与排错 |
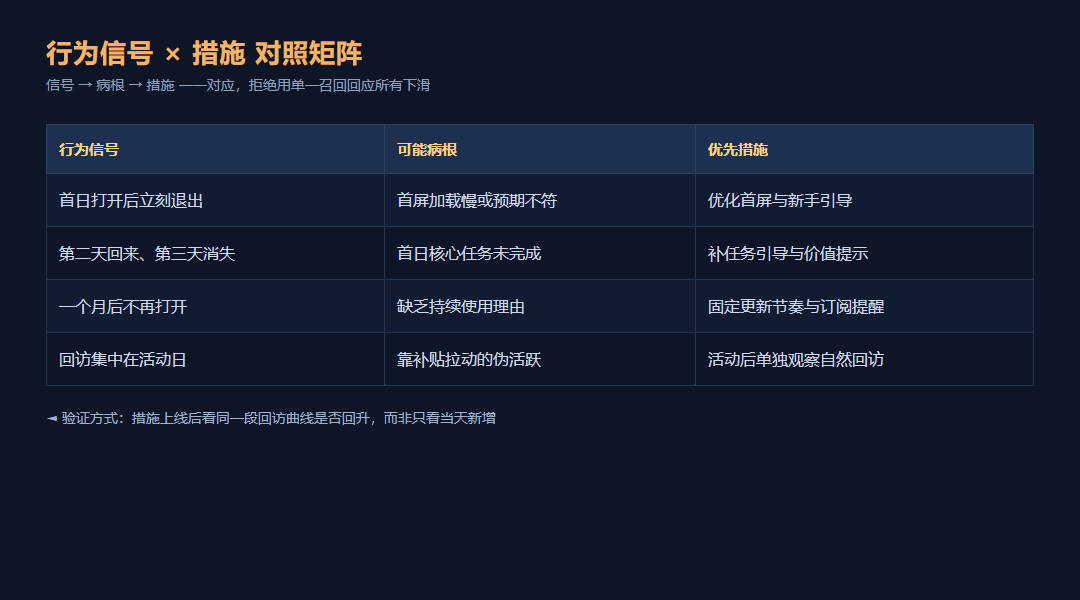
信号、病根、措施三者一一对应,避免用单一动作回应所有下滑(矩阵为示例)
四、诊断的边界:不承诺统一的增长结果
4.1 留存提升没有放之四海皆准的动作
必须说清楚边界。不同产品类型、不同用户来源、不同观察定义下,留存的合理区间完全不同,所以本文不会给你一个"做到多少留存就算成功"的统一数字,也不承诺某条措施一定能拉升曲线。你能做的,是按回访阶段定位自己的问题段,再用对照矩阵去试措施、看曲线是否回应。
排错诊断的价值在于缩小问题范围,而不是给出增长承诺。你看到的曲线回升,可能来自措施生效,也可能来自季节性波动或渠道质量变化,因此每一轮措施都要和之前同一根曲线做对比,而不是和别人的产品比。任何脱离自身数据基线的"行业通用留存值",在没有明确可核验来源前,都不当作判断依据。本文由官网内容团队整理,侧重方法与公开资料核对;文中的场景和数字示例不代表特定客户实测或效果承诺。
五、下一步动作:从一次排错到固定观察口径
收尾给你三个可以马上做的动作。第一,按 D1/D7/D30 口径把三段回访曲线拉到同一张图,先确认下滑集中在哪一段,并剔掉还没走满时间窗的新 cohort;第二,针对那一段,从行为信号对照矩阵里选一个对应措施,而不是群发召回;第三,措施上线后继续观察同一根曲线,用它有没有回升来判断这一刀切没切中。留存是长期过程,单次排错的价值,在于把"凭感觉上活动"换成"按阶段定位再验证"。