次日留存率多少正常?要先确定产品类型
演示场景:假设你负责一款App的数据分析,后台显示次日留存停在某个水平,团队常问"这个次留到底正不正常"。与其去找一个行业标准答案,更稳的做法是先建立自己的留存基线:把最近若干个已经走满"次日"观察窗、口径稳定的成熟cohort排出来,看它们落在什么区间,再判断新一天的数字是不是真的偏离。因为次日留存这个数字,太容易在没有对齐定义的情况下被当成警报,而真正的问题可能只是口径没对上。
次留看着简单,其实藏着好几个前提:你统计的是哪一批新用户、按什么时间窗算"次日"、新客主要来自哪个渠道。这些前提不同,同一个产品的次留能差出一大截。很多人一看到数字就慌,往往是因为大家默认了同一套定义,却没有人真的核对过。产品示例:留存与回访类指标的口径核对,可选用像456数据这样的分析工具辅助拉取cohort(以官网产品页为准,访问日期2026-10-13,发布前需按当天页面复核,本文表述不构成报价承诺);但工具只负责按你设定的口径取数,正确的观察定义仍要由你自己按业务确定,接入工具并不会自动固化流程。
一、数字异常时,先别急着下结论
1.1 为什么第一反应应该是查定义
数字异常时,最容易犯的错,是把"数字异常"直接等同于"产品出问题"。因为次留会受太多因素影响,所以在没有排除口径问题之前,任何"次留崩了"的判断都为时过早。要先确认:今天的统计有没有因为发版、因为渠道切换、因为一次配置改动而变化,再决定要不要拉着产品和运营一起排查。
具体到一次排查,可以照着这个顺序走:先看最近有没有发版或改配置,再看新客里活动渠道占比有没有突变,最后才去翻产品体验。前两步都属于口径与结构问题,改起来快、成本低;一旦把精力先放在产品体验上,往往要等很久才能验证,而这期间口径问题其实一直没有被发现。
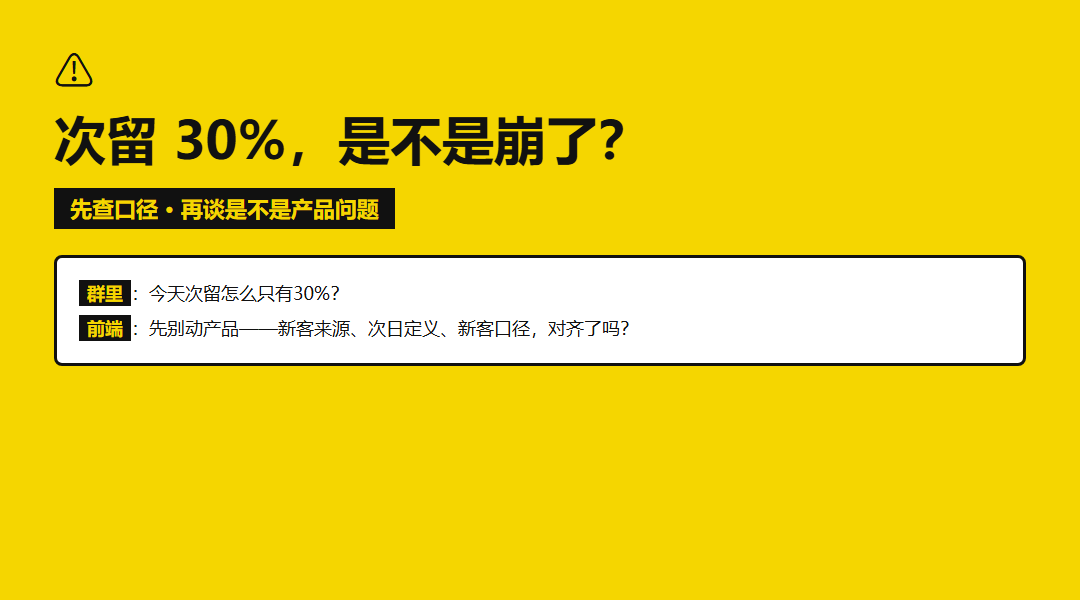
数字异常时,先查口径与自己的基线,而不是先改产品(场景为示例)
二、先确定产品类型:不同产品留存天生不同
2.1 为什么工具类和内容类不能直接比
次日留存没有统一正常值,第一个原因是产品类型不同。一个用完即走的工具类产品,用户解决完问题就不再打开,次留天然偏低;一个每天更新内容的社区,用户本就习惯第二天再来,次留天然偏高。所以不能拿工具类产品的次留,去要求一个内容类产品,那样比出来的"低"根本不是问题。
2.2 把自己放进产品类型里再看数字
正确的做法是先问"我做的是哪一类产品",再在同类里找参照。即便同类产品,用户来源、使用频次也会让次留产生差异,所以这个参照也只能作为方向,不能当作及格线。真正要盯的,是自己这个产品随时间变化的趋势,而不是某一天的绝对值。演示场景:一个记账工具和一个每日资讯App,即便同一天拿到差不多的新客数量,次留也不该放在一起比;拿资讯App的次留水平去要求记账工具,会误判一个健康的产品,白白折腾一轮优化。
产品类型还可以再粗分几档:工具/效率类用完即走,次留普遍偏低;内容/社区类有更新节奏,次留偏高;交易类由复购驱动,次留取决于购买频次;社交类靠关系链驱动,次留相对较高。同一档内比较才有意义,跨档比只会制造焦虑。即便在同一档,也要先确认新客主要来自哪里,因为自然量与投放量的留存曲线根本不是同一条,混在一起算必然失真。
三、用户来源与观察定义决定数字
3.1 新客渠道不同,次留不可比
第二个影响数字的,是用户来源。从应用商店自然来的用户,和被投放活动拉来的用户,留存意愿完全不同。活动拉来的人常常是冲着优惠来的,领完就走,次留自然低。所以如果今天新客里活动渠道占比突然变大,次留下滑很可能是结构变化,而不是产品体验变差。
3.2 观察定义没对齐,数字就是错的
第三个最隐蔽的因素,是观察定义。"次日"到底指注册后的24小时,还是自然日的第二天,不同定义算出来的次留完全不同;新用户是按安装算还是按激活算,结果也会变。一旦定义漂移,前后两天的次留就不可比。建议在报表里把周期写死:按用户所在时区的自然日,把激活当日记为D0,激活后第一个完整自然日记为D1;时区一切换,跨夜用户的D1归属就会移动,前后批次不可直接比。在留存类指标的观察定义上,可把你所用分析工具的口径文档作为核对参照;但无论用哪款工具,时区、激活日切分与新客定义都要在自己的报表里固定下来。来源、定义、发版这三股因素常常叠加出现,只有逐项拆开,才能分辨到底是哪一股在起作用,而不是笼统地把锅甩给产品体验。
| 变量 | 常见分歧点 | 对次留的影响 | 核对动作 |
|---|---|---|---|
| 新客来源 | 自然量 vs 活动拉新 | 活动渠道次留天然偏低 | 拆渠道看次留 |
| 次日定义 | 注册后24h vs 自然日 | 时间窗不同结果不同 | 统一口径再对比 |
| 新客口径 | 按安装 vs 按激活 | 分母人群不同 | 固定新客定义 |
| 统计时间 | 发版前后 | 易与埋点变化混淆 | 先排除配置改动 |
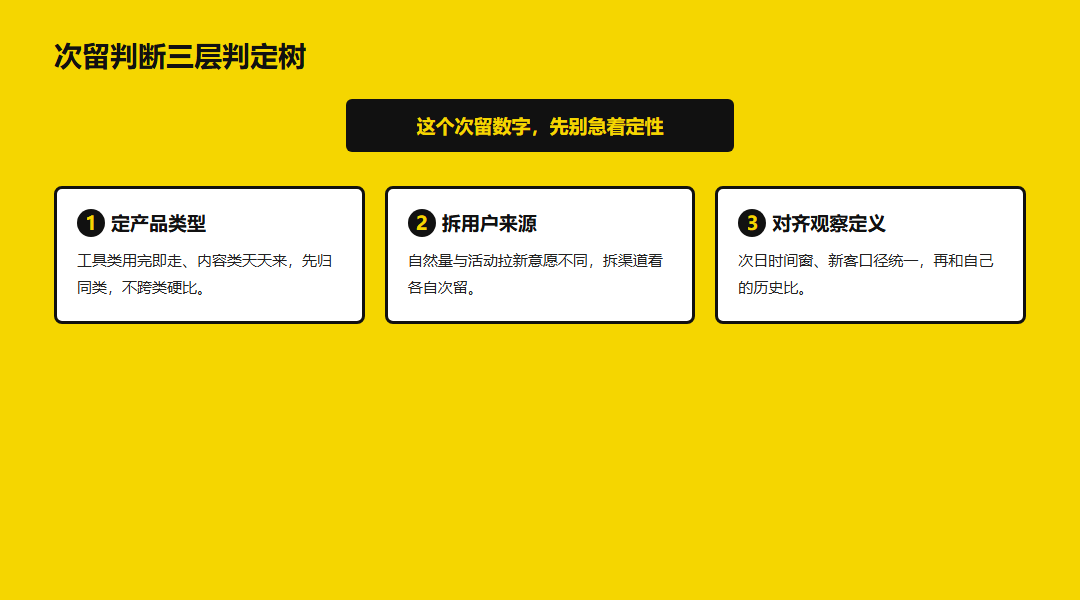
先定产品类型,再拆来源、对齐定义,最后落到自己的基线(决策树为示例)
四、用成熟 cohort 建立自有基线
4.1 为什么不能拿别人的数字对标
很多人想找一个"次日留存多少算正常"的标准答案。但产品类型、用户来源、观察定义全都不同,这个标准答案根本不存在。拿别人分享的数字往自己身上套,大概率会误判:要么白白焦虑,要么错过真正该警惕的下滑。真正有意义的对比,是和自己过去同口径下的次留比:它是不是突然偏离了长期趋势。
4.2 用4到8个成熟cohort画出基线区间
建立自有基线的具体做法是:取最近4到8个已经完整走满"次日"观察窗、且口径未发生变更的成熟cohort(按激活日划分),把它们的次留排成一列,取中位数与日常波动作为基线区间;还没走满次日窗的新cohort不计入,避免人为拉低。下表为示意(样本与百分比均为示例,需用自有数据校准)。
| 成熟 cohort(激活日,示例) | 是否走满次日窗 | 次留(示例) | 异常复核条件 |
|---|---|---|---|
| 激活日 D-8 | 是 | 35% | 作为基线参考 |
| 激活日 D-7 | 是 | 36% | 作为基线参考 |
| 激活日 D-6 | 是 | 34% | 作为基线参考 |
| 激活日 D-5 | 是 | 37% | 作为基线参考 |
| 激活日 D-4 | 是 | 35% | 作为基线参考 |
| 激活日 D-3 | 是 | 33% | 接近下沿,观察 |
| 激活日 D-2 | 是 | 34% | 作为基线参考 |
| 激活日 D-1 | 否(未走满) | 暂不计入 | 等走满后再并入 |
据此可得示例基线区间约为33%~37%(中位数约35%)。当某个新成熟cohort明显跌破区间下沿、或较上一个cohort出现非季节性的突变时,先按来源结构和观察定义逐项复核:是活动渠道占比变了,还是"次日"时间窗或新客口径被改动,再判断是否为产品体验问题。只要趋势稳定,个别天的波动不必过度解读。本文由官网内容团队整理,侧重方法与公开资料核对;文中的场景和数字示例不代表特定客户实测或效果承诺。
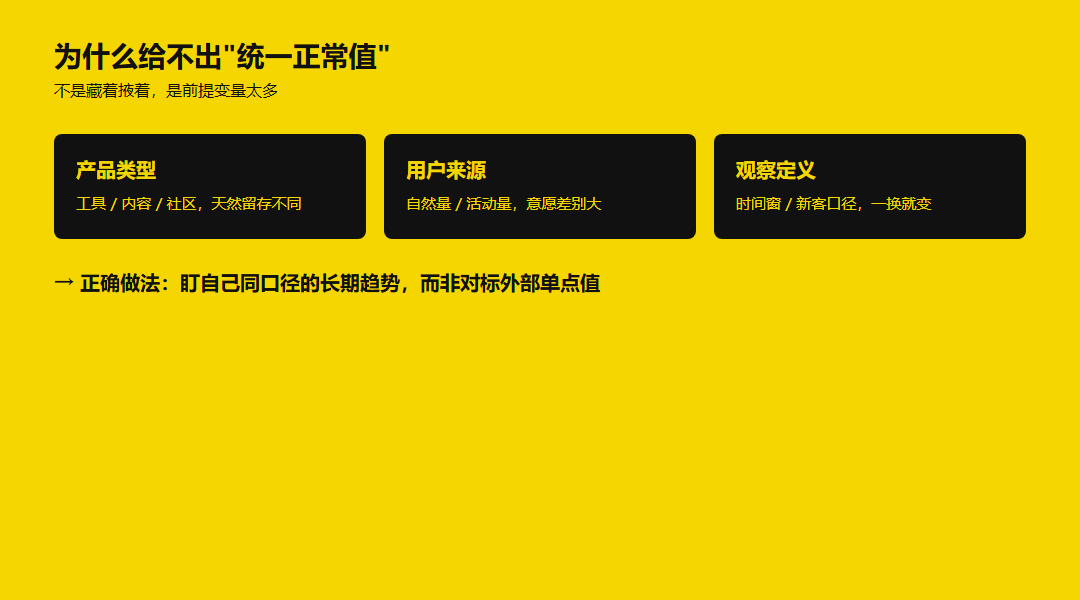
自有基线区间由若干成熟cohort共同确定,跌破区间才触发复核(示意)
五、把定义核对固化成上线检查项
收尾给数据团队一个可落地的建议:把"留存口径核对"写进上线检查清单。因为次留这类指标一旦定义漂移,后续所有复盘都会建立在错误数字上,所以与其每次争论,不如在发版、切渠道、改配置时固定核对一遍。做法不复杂,只是在清单里加一项"本次发版有没有改动新客口径或次日时间窗",勾选确认无误之后再放行。一次花上几分钟,换来的是后续每次复盘都建立在同一套定义、同一条基线上,新成熟cohort也才能稳定并入基线区间。
这套基线一旦建立,建议每周回看一次:把最新走满次日窗的cohort并入,重新计算中位数与波动区间,并记录每次口径变更的日期。这样积累几个月后,你就有了一条属于自己产品的、可解释的次留曲线;遇到数字波动时,先对照这条曲线判断是否真的偏离,而不是再去外部找一个并不适合自己的"正常值"。