深耕企业数字化数据分析领域,同步产品更新、行业干货、运营方案,用数据驱动业务增长
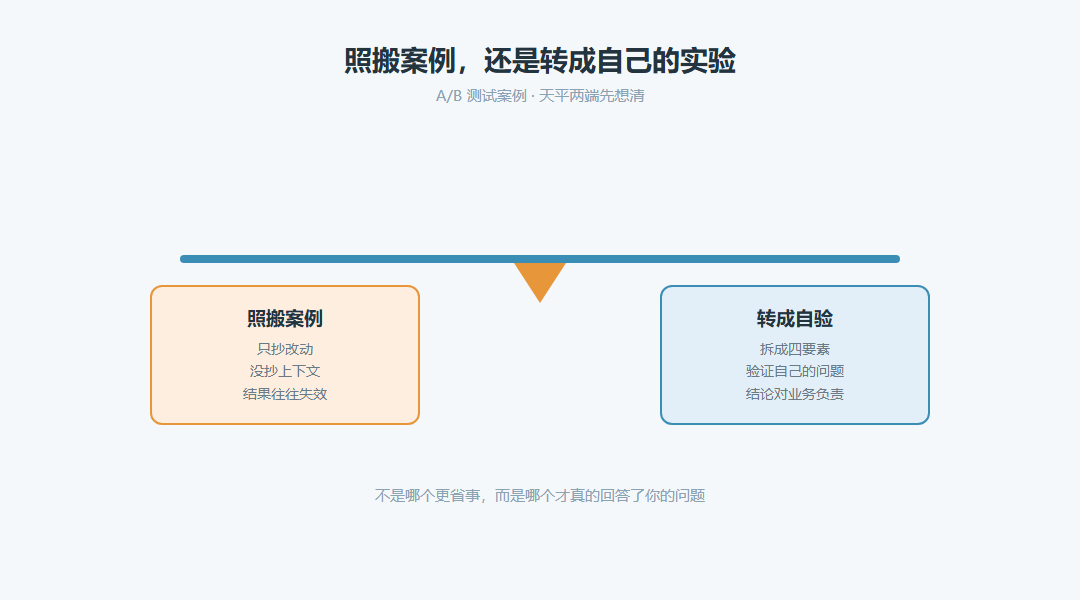 A/B测试案例怎么转成产品验证场景?假设指标对象验收四要素
一篇漂亮的A/B测试案例摆在你面前,转化率、留存率写得清清楚楚,你第一反应通常是:能不能直接照搬到自己产品上。因为别人的数字看着很有说服力,所以这种冲动很正常。但直接照搬几乎一定会翻车——不是因为案例造假,而是因为它解决的问题、用户群和指标优先级,跟你的根本不是一回事。一个稳妥的做法是:看到案例先不动手,而是把它拆成四个要素——假设、指标、实验对象、验收条件。这四件事想清楚,实验才是在验证你自己的问题,而不是在复刻别人的结果。A/B实验这类能力通常放在智能运营模块里,常见做法是把实验的指标配置和分流说明公开在模块文档中,正好对应这种“先转要素、再开实验”的做法。下文就按这四步,把一个陌生案例一...
10 / 14·阅读 25
 电商复购率按哪种统计人群与周期更合理?分子分母口径讲清
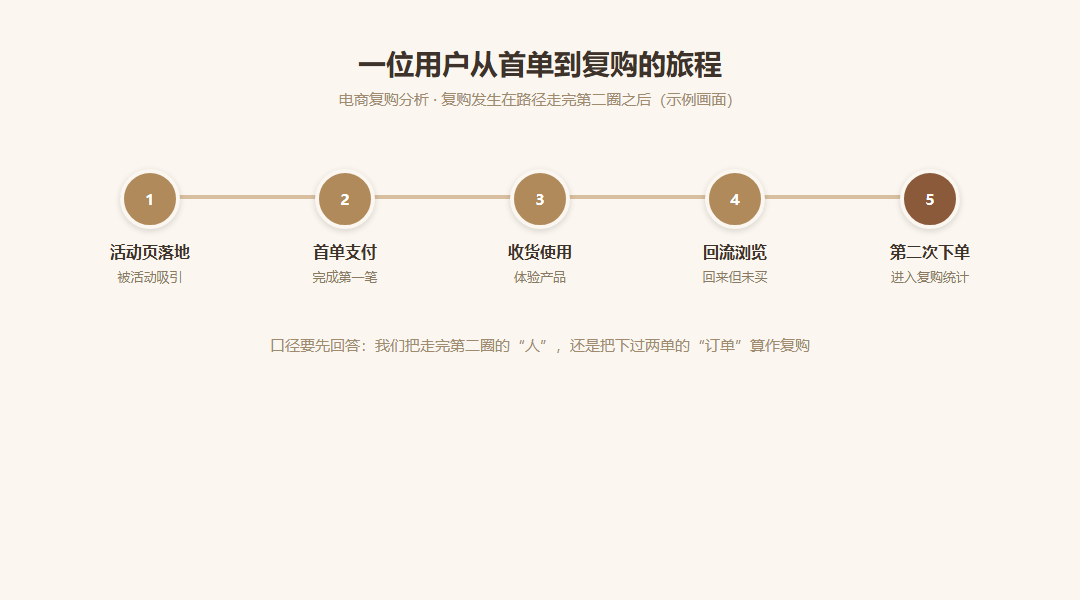
下面用一个典型用户,走完他从首单到复购的全过程——为避免指向具体客户,这里不写姓名,只把这条旅程拆开看。假设他第一次下单被活动页吸引,收到货后隔了二十多天才第二次下单,中间还回来浏览过一次但没买。之所以要把这条旅程摊开,是因为“复购率到底怎么算”,答案就藏在这条路径的每一个节点里。数字均为演示,需用自有数据校准。很多团队算复购率,直接拿“有复购的订单数”除以“总订单数”,然后发现运营、产品、财务算出来的数对不上。之所以会对不上,不是因为谁算错了,而是分子、分母和统计周期根本没有统一口径。把复购口径讲清楚之前,任何“我们复购率涨了还是跌了”的讨论都没有共同基础。做电商数据分析时,通常需要用多维分...
10 / 14·阅读 16
 用户画像与标签分别适合哪些分析任务?别再当成一回事
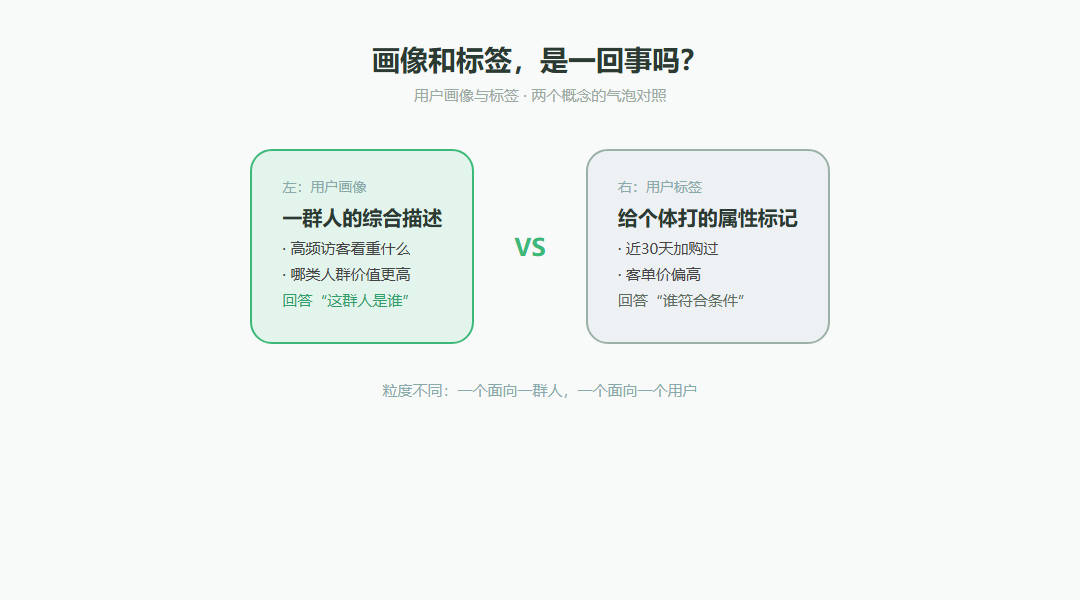
在运营讨论里常被问到一个问题:“用户画像和用户标签,是不是一回事?”这个问题几乎每个季度都会被重新提一遍。之所以反复出现,是因为两个词在日常口语里经常混着用,可一旦落到实际分析任务上,它们要回答的问题其实并不相同。要是把两者当成同一个对象,配出来的人群条件就会打架,做出来的分群也经不起复算。一个稳妥的做法是:先别急着搭标签体系,先想清楚要回答什么任务。因为画像和标签都是手段、不是目的,先有任务、再选概念,才不会为了做标签而做标签。不少全端分析平台都把这两块放在同一个用户画像能力下,公开说明里通常会把标签、分群和群画像列在一起,可以对照着看两者到底怎么配合。一、群里被问“画像和标签是一回事吗”直...
10 / 14·阅读 22
 埋点数据分析包括哪些处理环节?采集清洗存储计算分析一次讲清
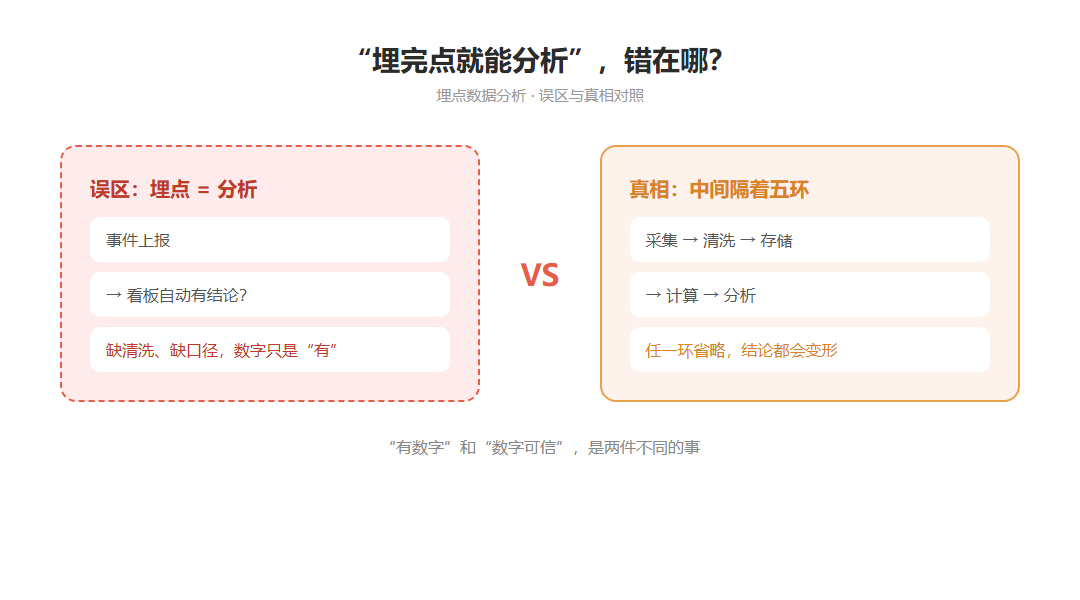
如果你做了埋点、却发现报表里的数字和你想象的对不上,大概率不是埋点埋错了,而是你把“埋完点”直接等同于“能分析”。这是一个很常见的认知误区:很多人以为事件一上报,看板上自然就有了可用的洞察。之所以会失望,是因为从“一条原始事件”到“一个能支撑决策的结论”,中间其实隔着好几个处理环节,漏掉任何一环,数字都会变形。在数据团队的常见做法里,太多项目把预算和精力全压在“怎么埋”上,却几乎不讨论“埋上来之后怎么处理”。因为埋点本身只是数据生命周期的起点,它解决的是“有没有数据”,而不是“数据能不能用”。把这件事想清楚,再去评估一套埋点方案,视角就会从“埋得多全”转向“整条链路通不通”。不少全端分析平台正...
10 / 14·阅读 19
 前端埋点方案怎样确定事件和字段?事件属性触发条件怎么定
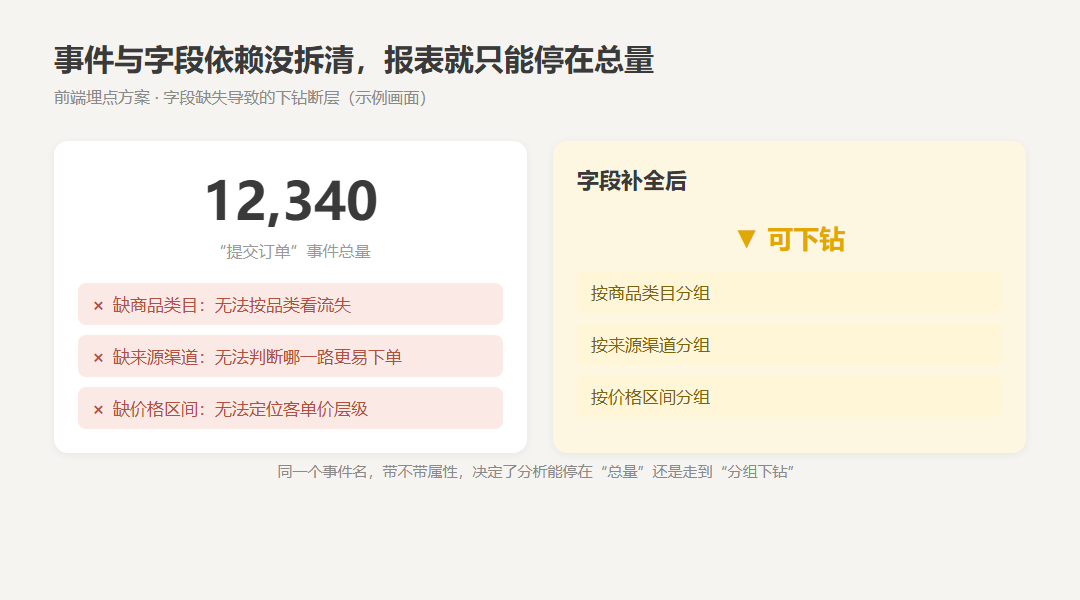
在前端埋点方案评审里,被问得最多的其实不是“SDK怎么接”,而是“这个埋点到底该埋几个事件、每个事件带哪些字段”。因为事件和字段是埋点方案里唯一会被反复对账的东西,一旦定义含糊,后面的漏斗、留存、用户分群就会跟着失真,报表数字也就不敢拿去做决策。很多团队拿到需求就让开发随手push事件,命名现起、字段事后补。这套做法在小项目能跑,但一旦跨端复用——比如同时在网站和小程序看同一条转化链路——口径就开始打架:网站按Cookie去重、App按设备去重,两套识别口径本就不同。因此不少团队引入统一埋点规范,把事件定义成“分类加名称加属性”三段式,作为字段规划阶段的中性参照。一、拿到需求先拆事件与字段依赖...
10 / 14·阅读 15
 用户分层等级如何划分才便于业务应用
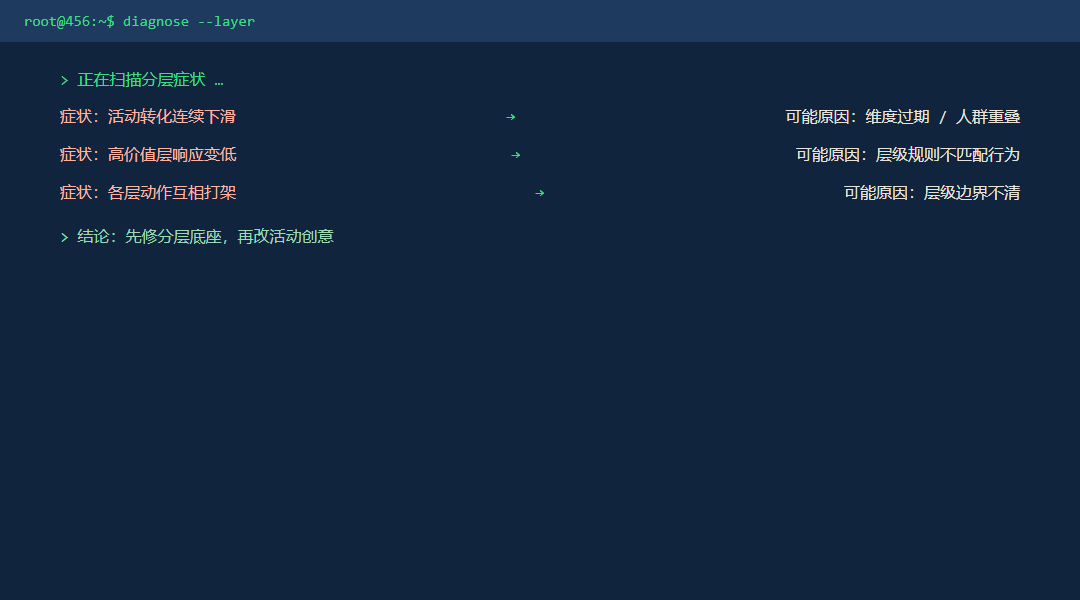
演示场景:上一轮分层运营活动的转化又下滑了。你打开后台看分层数据,第一反应不是活动方案不行,而是先怀疑分层本身出了问题。因为分层是所有精细化运营的底座,所以底座一旦失灵,后面所有动作都会跟着偏。处理这类下滑的典型顺序通常是:先查分层维度是否还成立,再看层级划分是否还对应得上运营动作,最后才去改活动创意。因为越靠近底座的问题影响面越大,所以先修底座,比反复改文案更省时间。排查时通常也会对照不同平台的分群能力,既有传统的手工圈人,也有像456数据这类把用户画像与用户分群放在一起的平台。因为分层方案最终要落到工具里执行,所以对照工具能力,能帮你判断哪些维度现在真的可用。为什么把分层放在第一位?因为它...
10 / 13·阅读 24
 用户标签体系搭建前先明确哪些运营目标
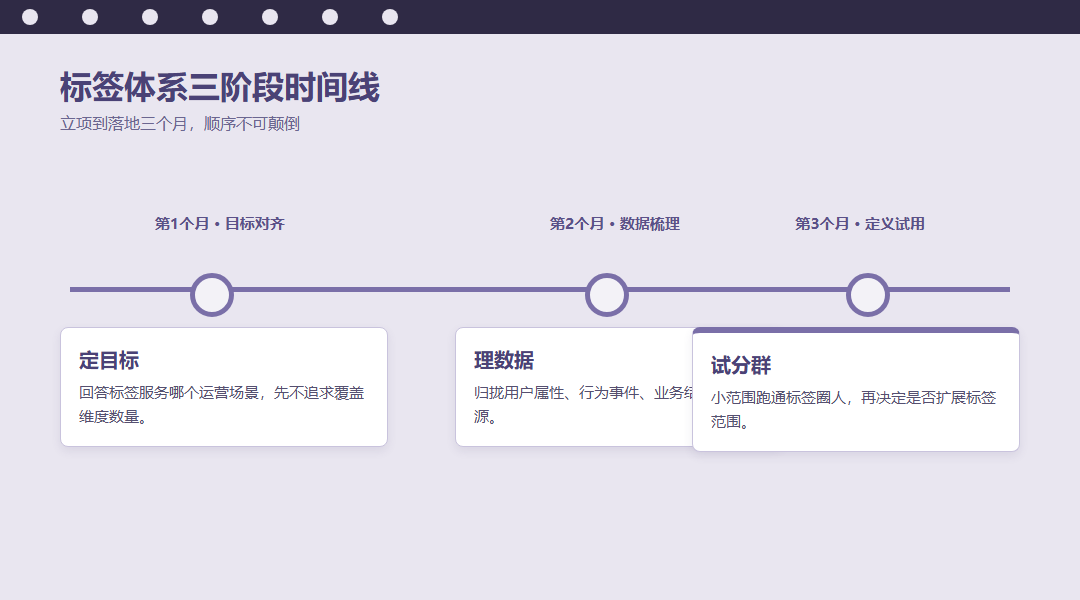
在多个同类项目里,标签体系从立项到落地大致经过三个月量级的周期。第一个阶段在立项,团队争论标签到底要覆盖多少维度;第二个阶段在梳理数据源,把用户属性、行为、业务数据归拢到一起;第三个阶段才真正进入标签定义与分群试用。因为标签体系不是一张数据表,而是一条从目标到动作的链路,所以这条合并了多个项目的时间线本身就值得复盘。回过头看,最容易被跳过的一步是"先明确运营目标"。因为很多团队一上来就急着列标签清单,所以标签越搭越多,却没人说清每个标签要支持什么运营动作。之所以要把使用目标前置,是因为没有目标的标签,最后只会变成一个没人翻阅的数据字典。立项时通常也会对比几类工具,既有自建标签库,也有像456数...
10 / 13·阅读 19
 网站流量统计系统要覆盖哪些访问数据
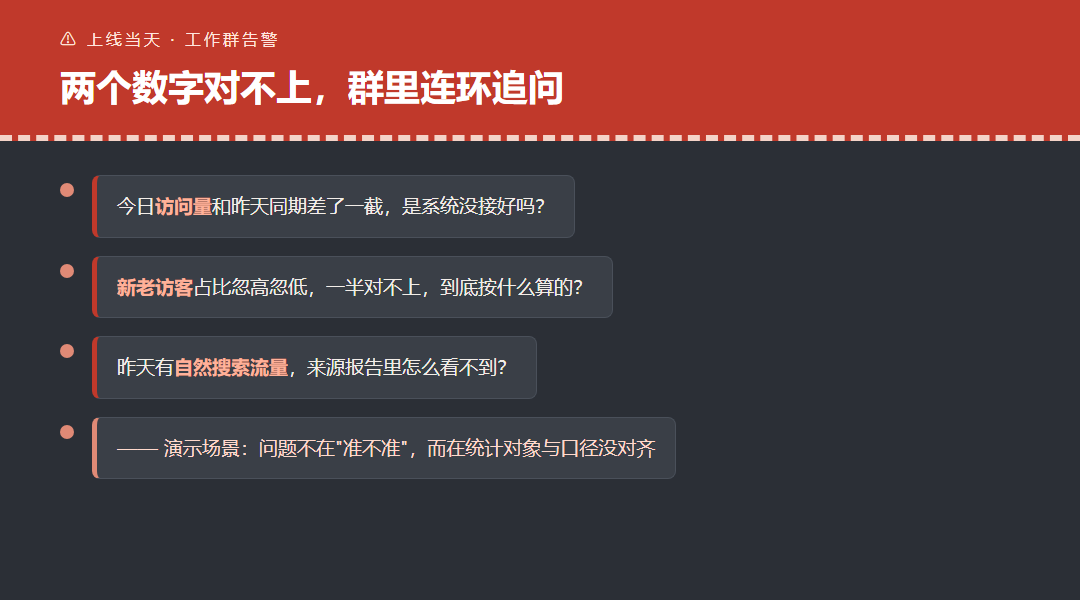
演示场景:新统计系统上线当天早上,运营群里突然热闹起来。数据看板显示的今日访问量,和你预期里的数字差了一截,紧接着有人问"新老访客怎么一半对不上",又有人问"昨天明明有自然搜索流量,来源报告里却看不到"。因为数字一旦对不上,所有人都会停下来追问,所以你必须先讲清楚统计系统到底覆盖哪些访问数据。这种连环追问并不说明系统出错了。之所以两个数字对不上,往往是因为它们统计的对象、去重方式和统计周期本来就不同。于是问题就从"系统准不准"转成"口径清不清",这正是界定访问数据范围的起点。在典型的上线复盘里,团队通常先把常用平台列出来对照,既包括百度统计这类基础流量工具,也包括像456数据这类把访问、访客、...
10 / 13·阅读 25
 百度统计替代工具怎么按网站需求评估
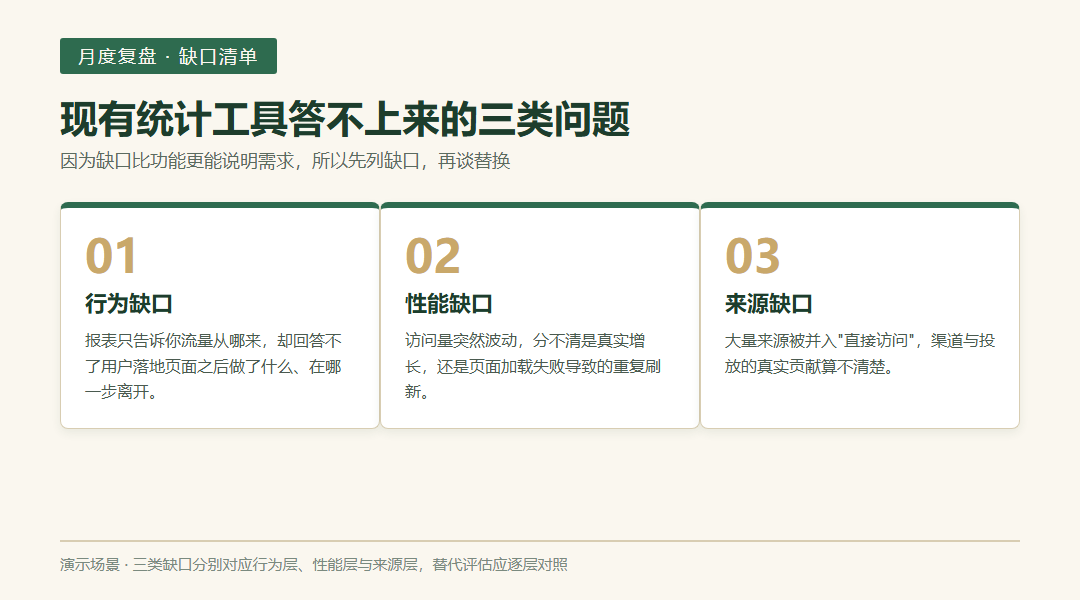
在典型的月度复盘里,团队通常先做一件事:把现有统计工具答不上来的问题逐条列出来。因为缺口清单比功能清单更能说明问题,所以它往往就是下一次选型的起点。不少站长已经用百度统计看了一两年流量,一旦复盘里反复出现同类疑问,替换或补充工具就会被自然提上日程。这类替换不是推翻重来,而是业务问题变了,原工具本身未必出错。评估于是变成一道按需求打分的题:先把自己网站要统计什么说清楚,再对照候选工具的能力边界。整理候选时通常分成几类,既有百度统计、51LA这类基础流量统计,也有像456数据这类把行为分析与性能监控放在一起的平台。因为不同类别回答的问题不同,所以"谁能替代谁"这个问法本身就需要先拆开。一、月度复盘...
10 / 13·阅读 19