深耕企业数字化数据分析领域,同步产品更新、行业干货、运营方案,用数据驱动业务增长
 App留存基准差异怎么拆:版本、渠道、口径、样本四维核对
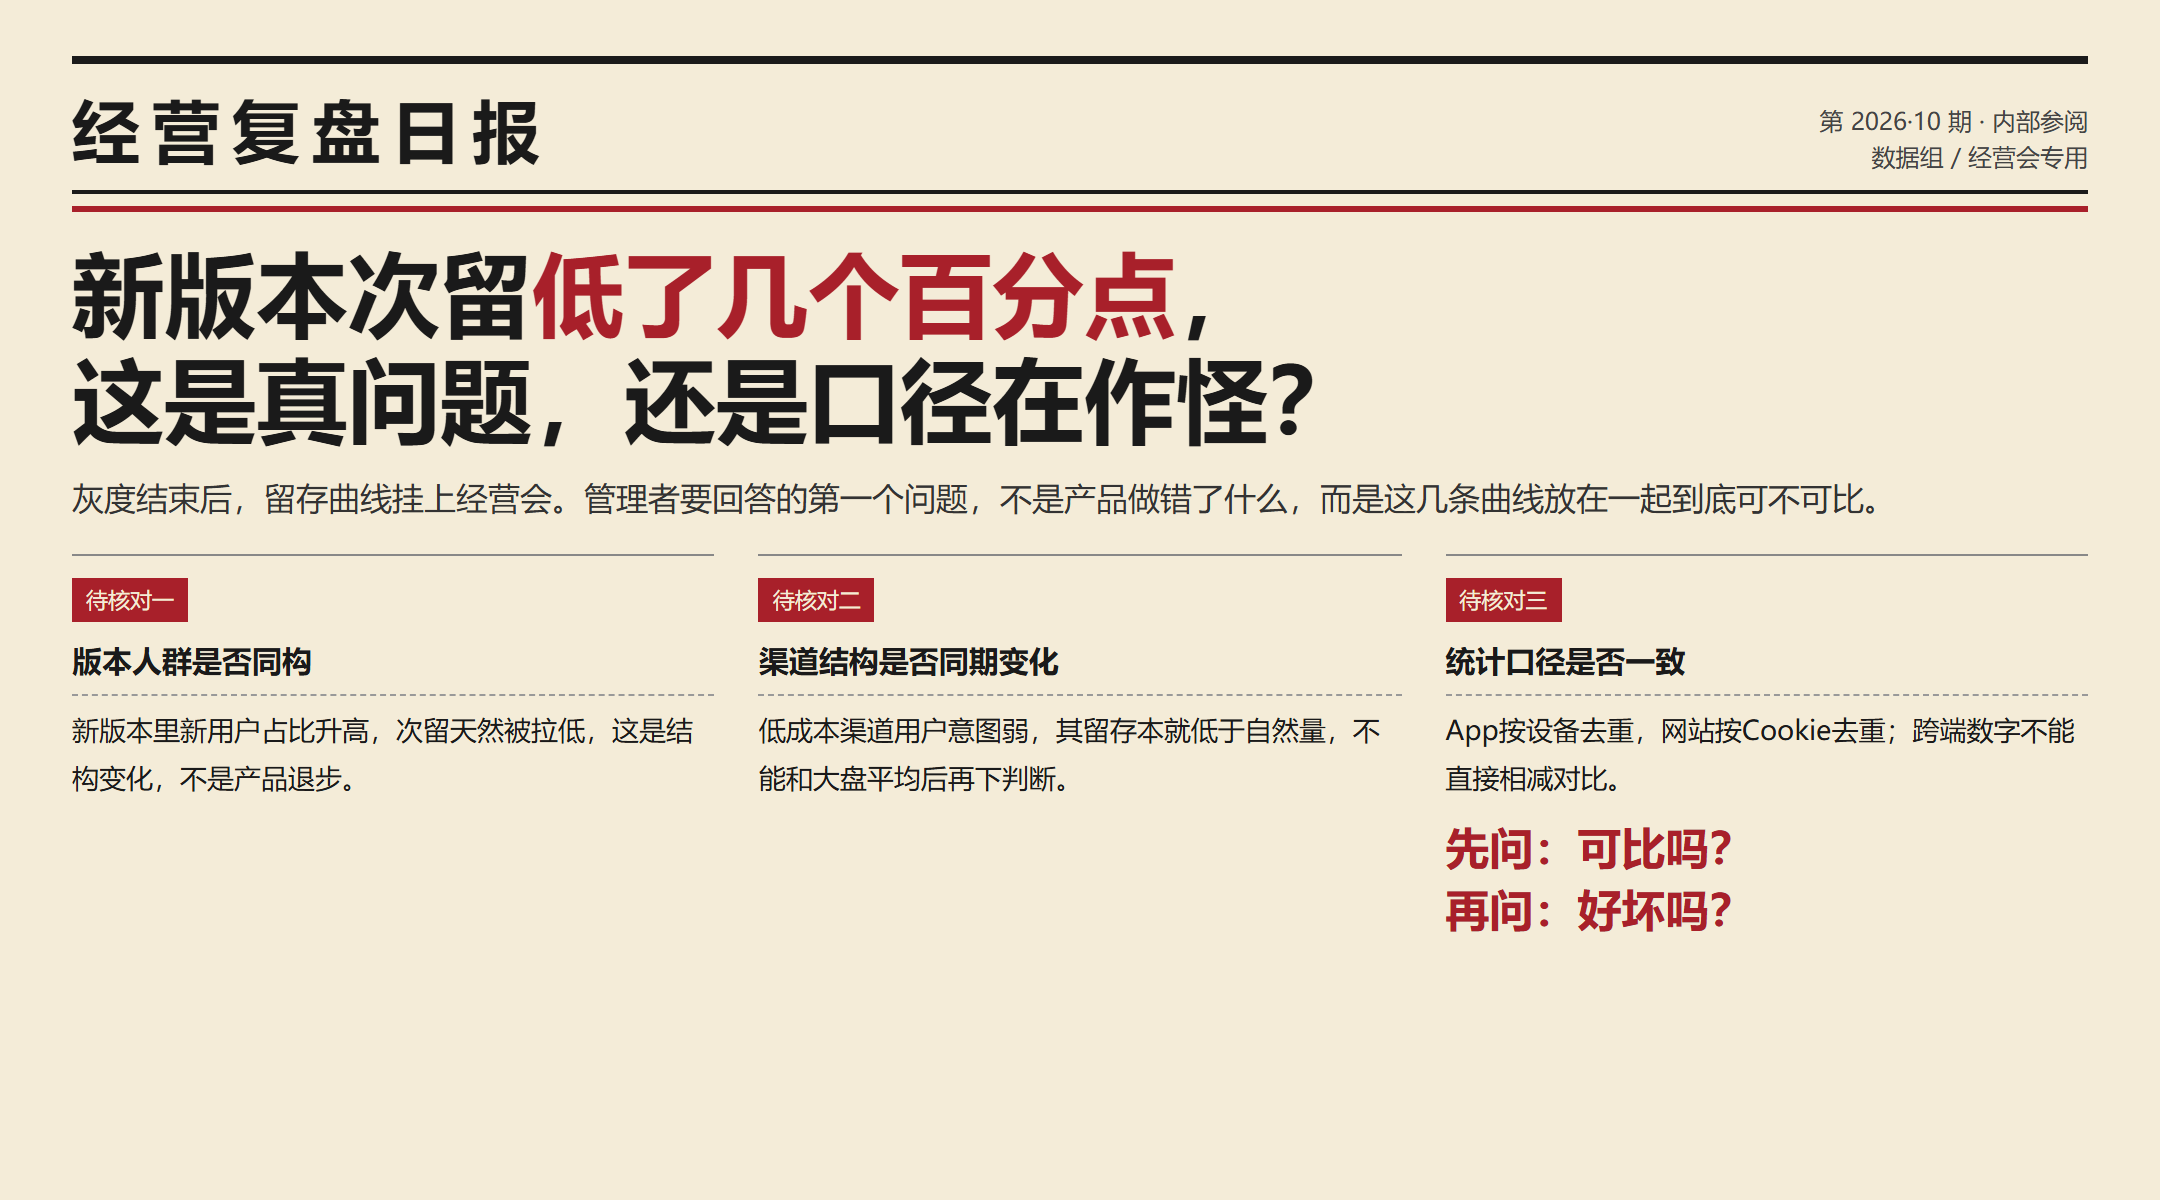
一次版本灰度结束后,数据组把留存曲线挂到经营会上:新版本的次留较旧版本低了几个百分点。这时候首先要回答的,不是"产品这一版做错了什么",而是"这几条曲线放在一起,到底可不可比"。留存差异可能来自真实体验下滑,也可能来自版本覆盖人群、投放渠道、统计口径在同一时间悄悄发生了变化。复盘阶段的第一个动作,是把"数字跌了"翻译成"差异由哪几部分构成",再决定后续方向。先说结论:本文不给出"次留应该达到多少"这类统一阈值。不同品类、不同获客渠道、不同产品阶段的留存曲线形态差异很大,外部没有一条可直接套用的及格线;团队能依赖的,只有基于自身历史数据建立的内部基准。下面按这个思路展开:为什么要自己建基准、内部...
10 / 09·阅读 40
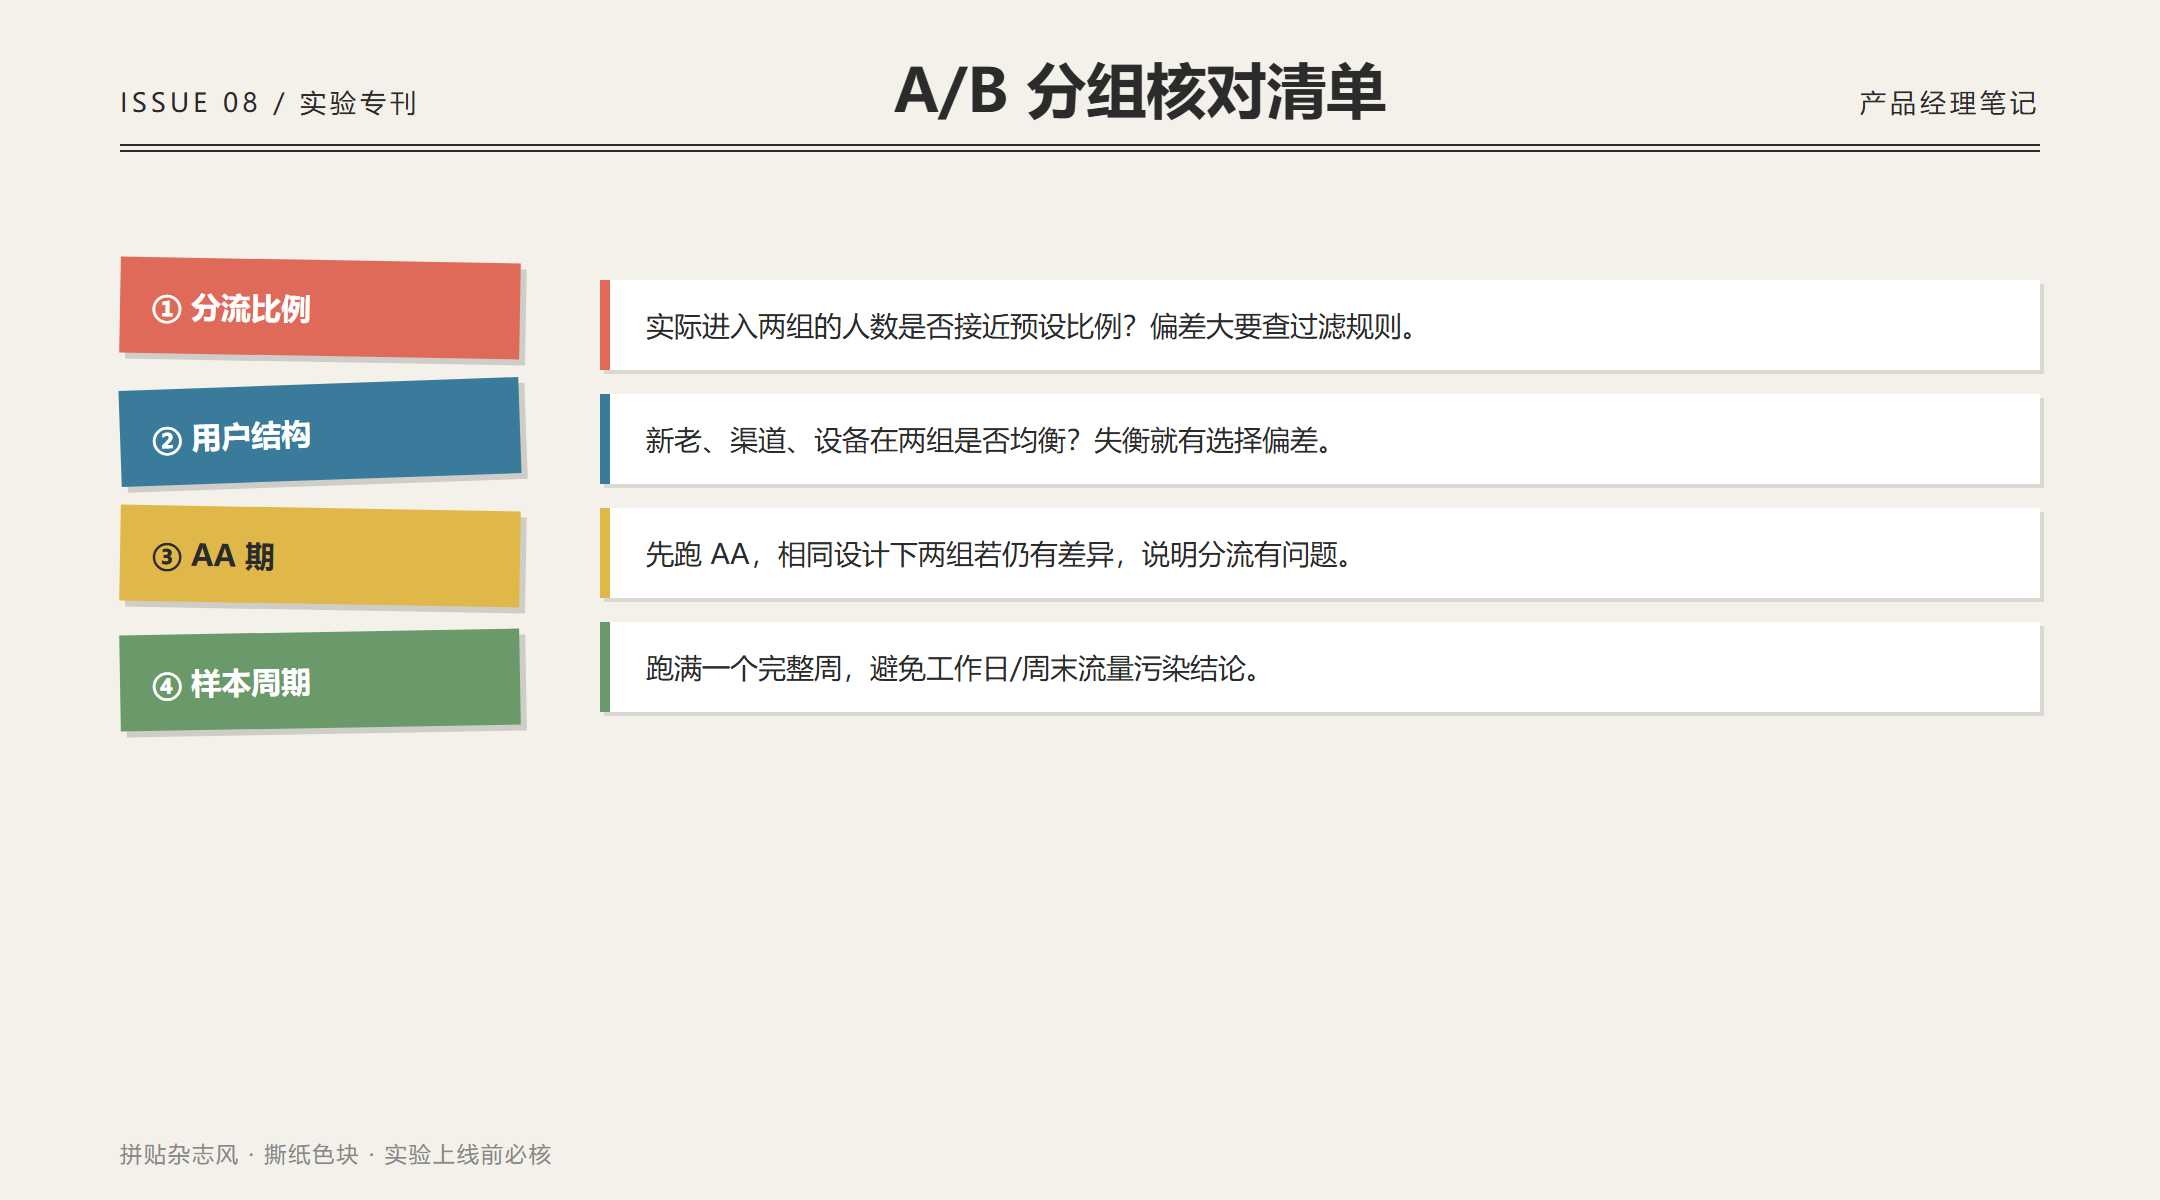 企业版实验平台:如何核对 A/B 分组是否可靠
一次实验上线前的例行核对,往往不是被一个大错误卡住,而是被一连串小偏差慢慢带偏:分流比例偏了几个点、两组里新进用户占比不一样、实验周期恰好只跨了一个工作日。这些偏差单看都不致命,叠在一起就会让"改版有效"的结论站不住。本文按一次分组核对的推进顺序整理:先看分流自己跑不跑得稳(AA、SRM、完整周期),再看多个实验并行会不会互相污染,结果出来后按均衡性、样本量、护栏指标依次复核,最后说明工具边界与尚未解决的问题。图:实验从设计到出结果需要逐关核对的分组要点上线之前,先让分流自己跑稳样本攒够之前,看到的差异往往是噪声分流本身需要时间收敛。实验刚启动时进入的是第一批流量,样本量小,两组之间的差异很容...
10 / 09·阅读 39
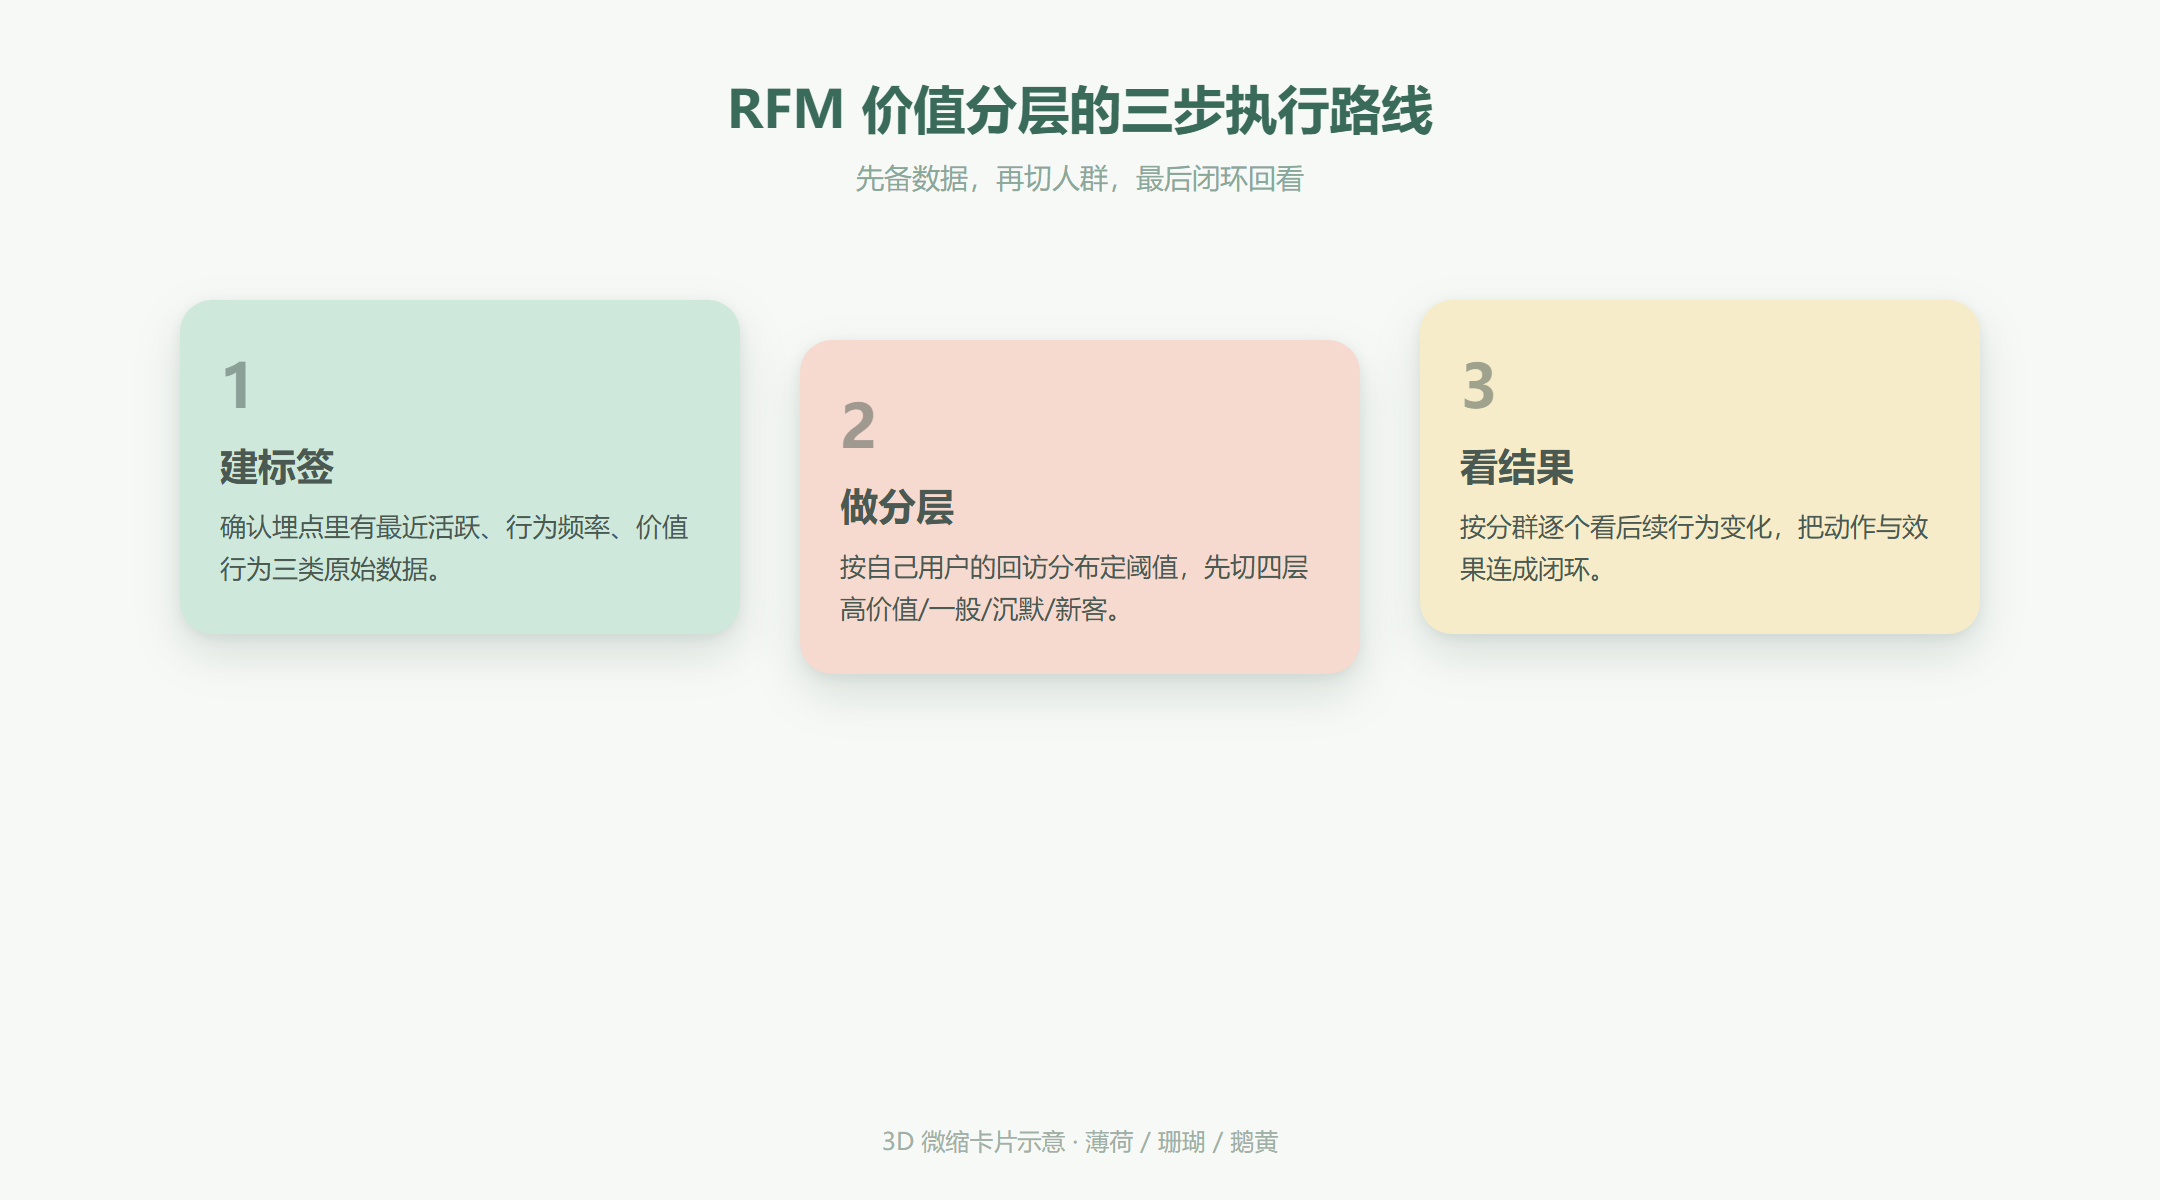 RFM模型工具:如何用价值标签做用户分层
做增长的人都听过RFM,但真到落地时,团队往往卡在同一个地方:数据散在各处,不知道先建什么标签。RFM听起来像一个现成功能,实际上它是一套分层思路,需要先把可用的行为数据凑齐。下面按落地笔记的顺序展开——先讲前置条件(数据备不齐,分层无从谈起),再讲分层实施(标签怎么切),然后是无法靠自动化完成的判断,最后是边界与未决问题;每一处都标清楚哪些能力已经开放、哪些仍需以后台为准。图:从建标签到看结果的三步执行路线一、前置条件:先确认R、F、M的原始行为齐不齐R、F、M各自需要什么原始行为RFM三个字母分别代表Recency(最近一次活跃距今多久)、Frequency(一段时间内的访问或行为频率)、...
10 / 09·阅读 35
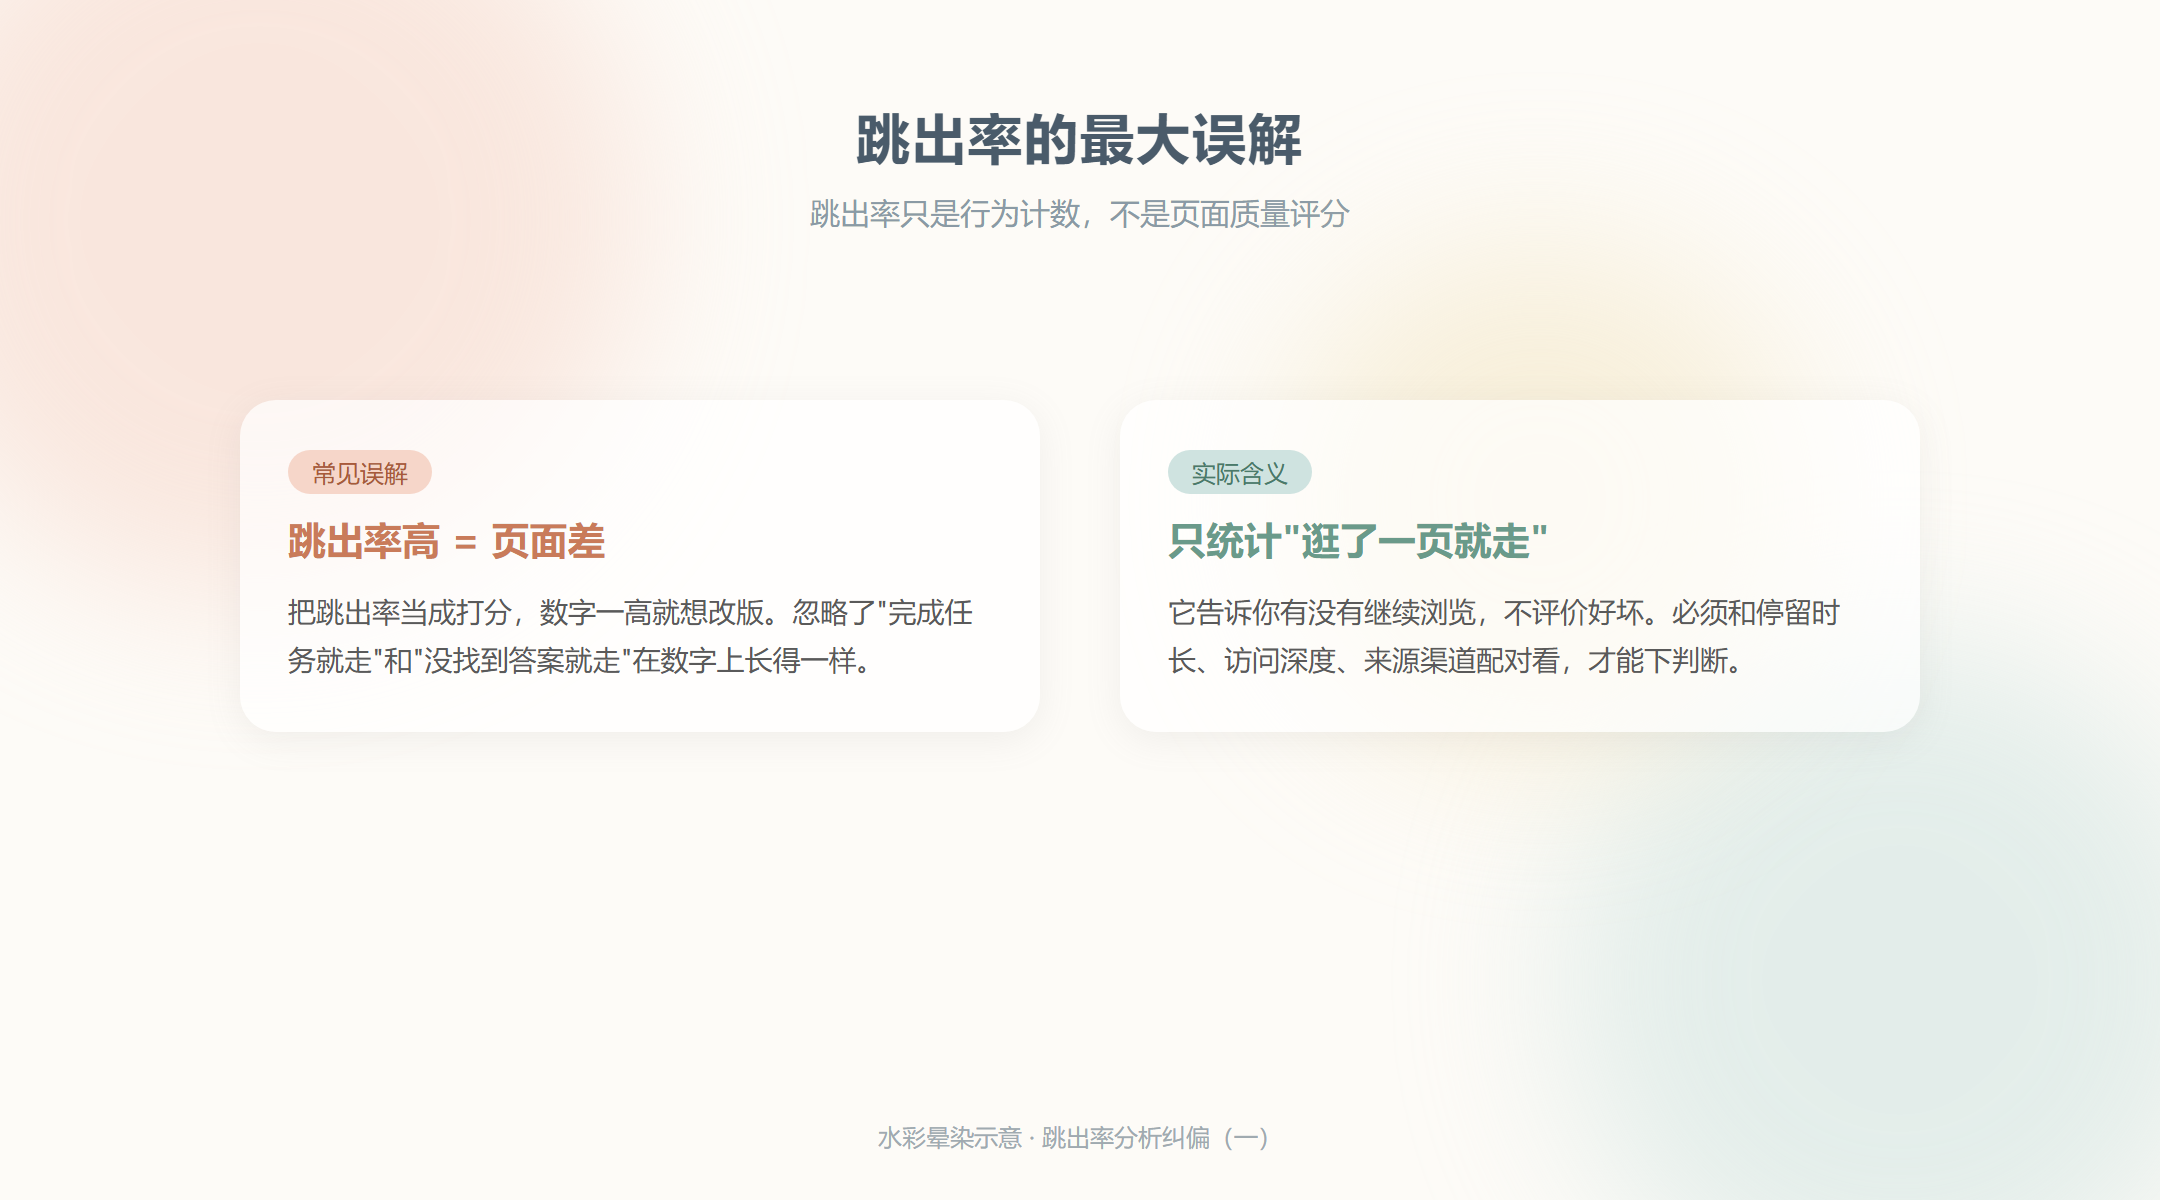 跳出率分析工具:如何分页面类型比较跳出率
在内容团队做数据分析内训时,常抛出一个问题:"跳出率高,是不是就说明这个页面做得差?"抢答"是"的人不在少数。这个答案错得整齐,根源在于大家把跳出率当成了页面质量评分。事实上,跳出率只是一个行为计数,它本身不评价好坏。官网对跳出率的定义很直白:只浏览了一个页面便离开网站的访客数占总访客数的百分比(指标口径词典docs/7,最后更新2026-07-03,本文核验日期2026-10-09)。这个口径决定了它只能告诉你"有没有继续逛",不能直接告诉你"页面好不好"。下面先把口径讲清楚,再给分页面比较的方法、容易误用的边界,最后是仍未解决的问题。本文采用的口径:跳出率=只浏览了一个页面便离开网站的访客...
10 / 09·阅读 35
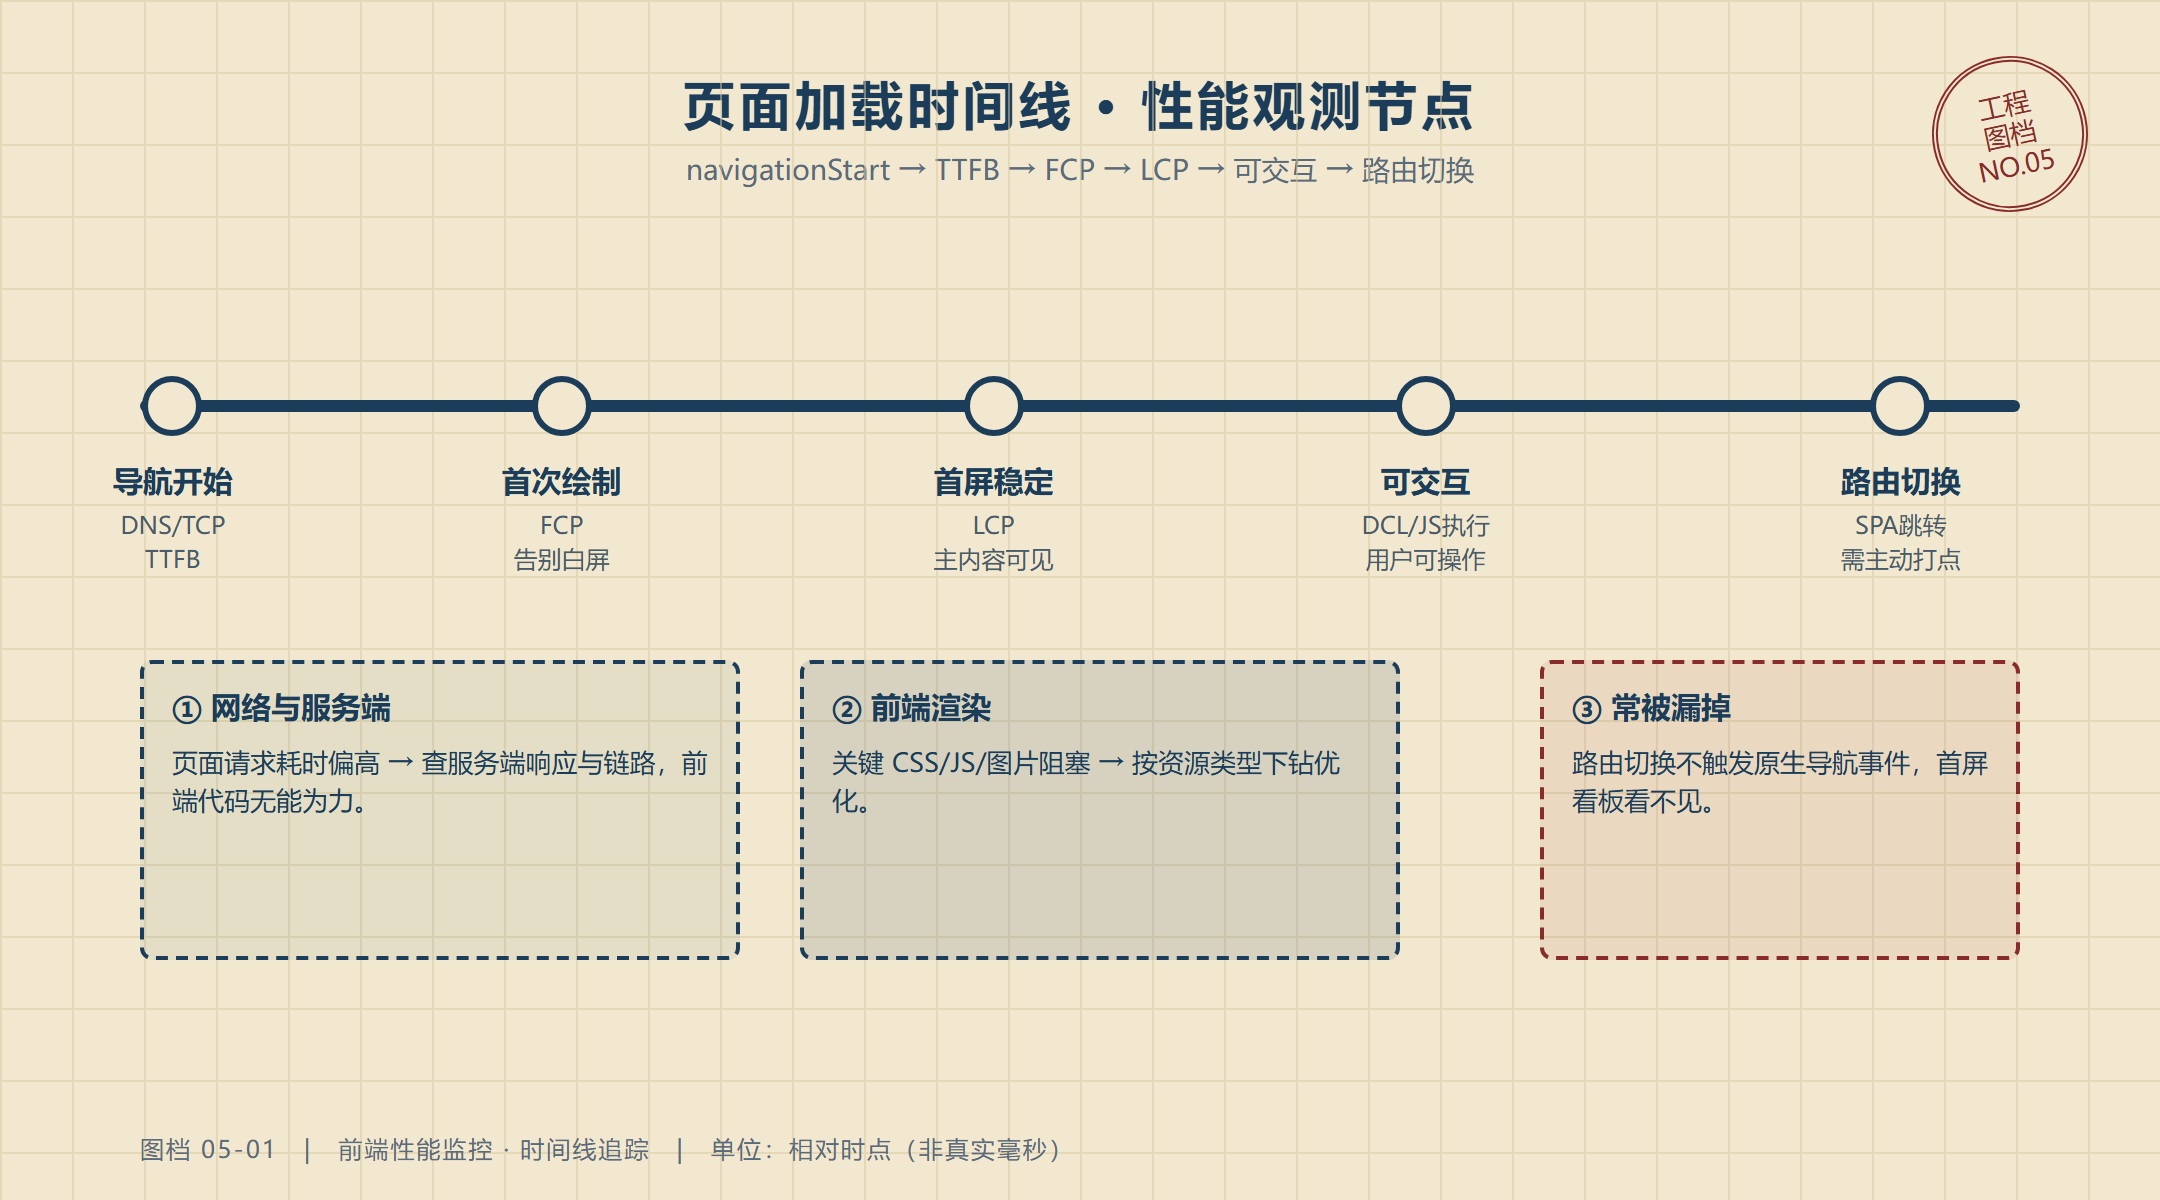 前端性能监控:如何区分路由切换与首屏体验
先看一个演示场景(不指向任何真实工单或客服记录):假设看板上的首屏加载时长看起来正常,客服却收到用户反馈说"点了菜单要等好几秒页面才出来"。这种对不上的原因在于,首屏指标记录的是用户第一次打开站点的那一段旅程,而用户抱怨的其实是进入站点之后的路由切换。前端性能监控如果只盯着首屏,就会漏掉后半段体验。下面按一次首屏性能核查的推进顺序展开——先对齐首屏口径,再看核查过程,然后是SPA路由这一常见盲区,最后交代工具能承接什么、仍有哪些未决问题。图:一次页面访问从导航开始到可交互的关键时间节点导航开始到TTFB:第一段延迟往往不在前端TTFB偏高,问题通常不在前端代码时间线的起点是浏览器发起导航。用户...
10 / 09·阅读 36
 用户流失分析:用行为路径、漏斗与性能排查锁定流失信号
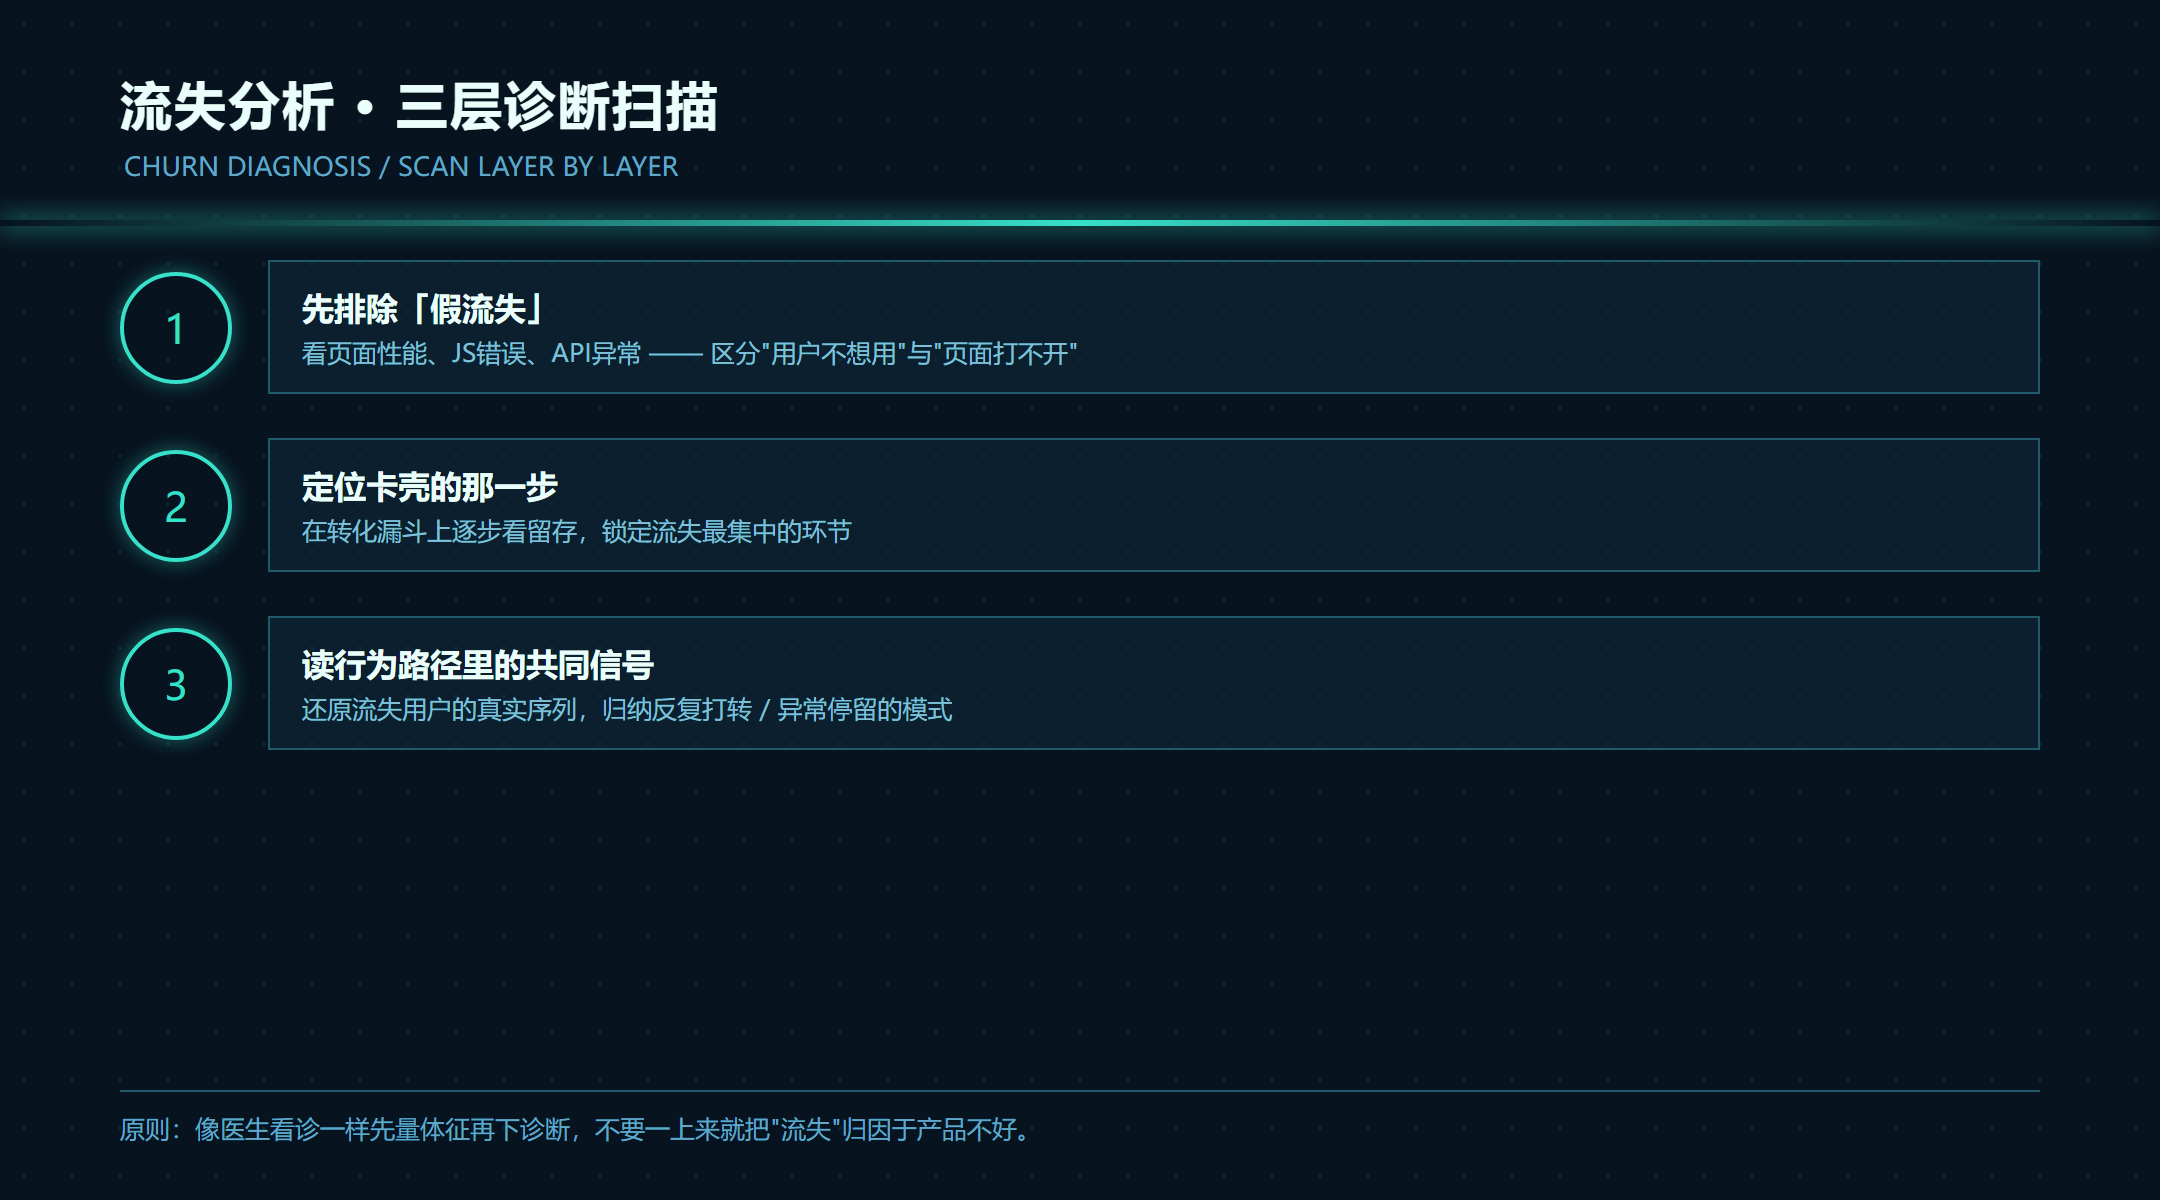
整理流失分析选题时,最常被业务方拿来的一句话是:"流失这么严重,肯定是产品不好用。"这句话跳过了所有诊断环节,既冤枉了产品,也耽误了真正该解决的问题。做流失分析和医生看诊是一个道理:病人说头疼,医生不会立刻开药,而是先量体温、测血压,把那些"看起来像头疼、其实不是"的原因一个一个排除掉。流失分析也一样——你看到的"流失",可能根本不是用户不想用了,而是页面根本没打开、加载超时或者干脆报错。要强调"先排除、再归因",是因为很多团队一看到留存下降就直奔产品体验改起,结果改了半天数据没动。真正的流失信号,藏在用户离开之前走过的那条行为路径里。下面就按一次流失分析实际推进的顺序,把这条路径逐层扫一遍。...
10 / 09·阅读 33
 用户行为分析工具:456数据如何匹配团队任务
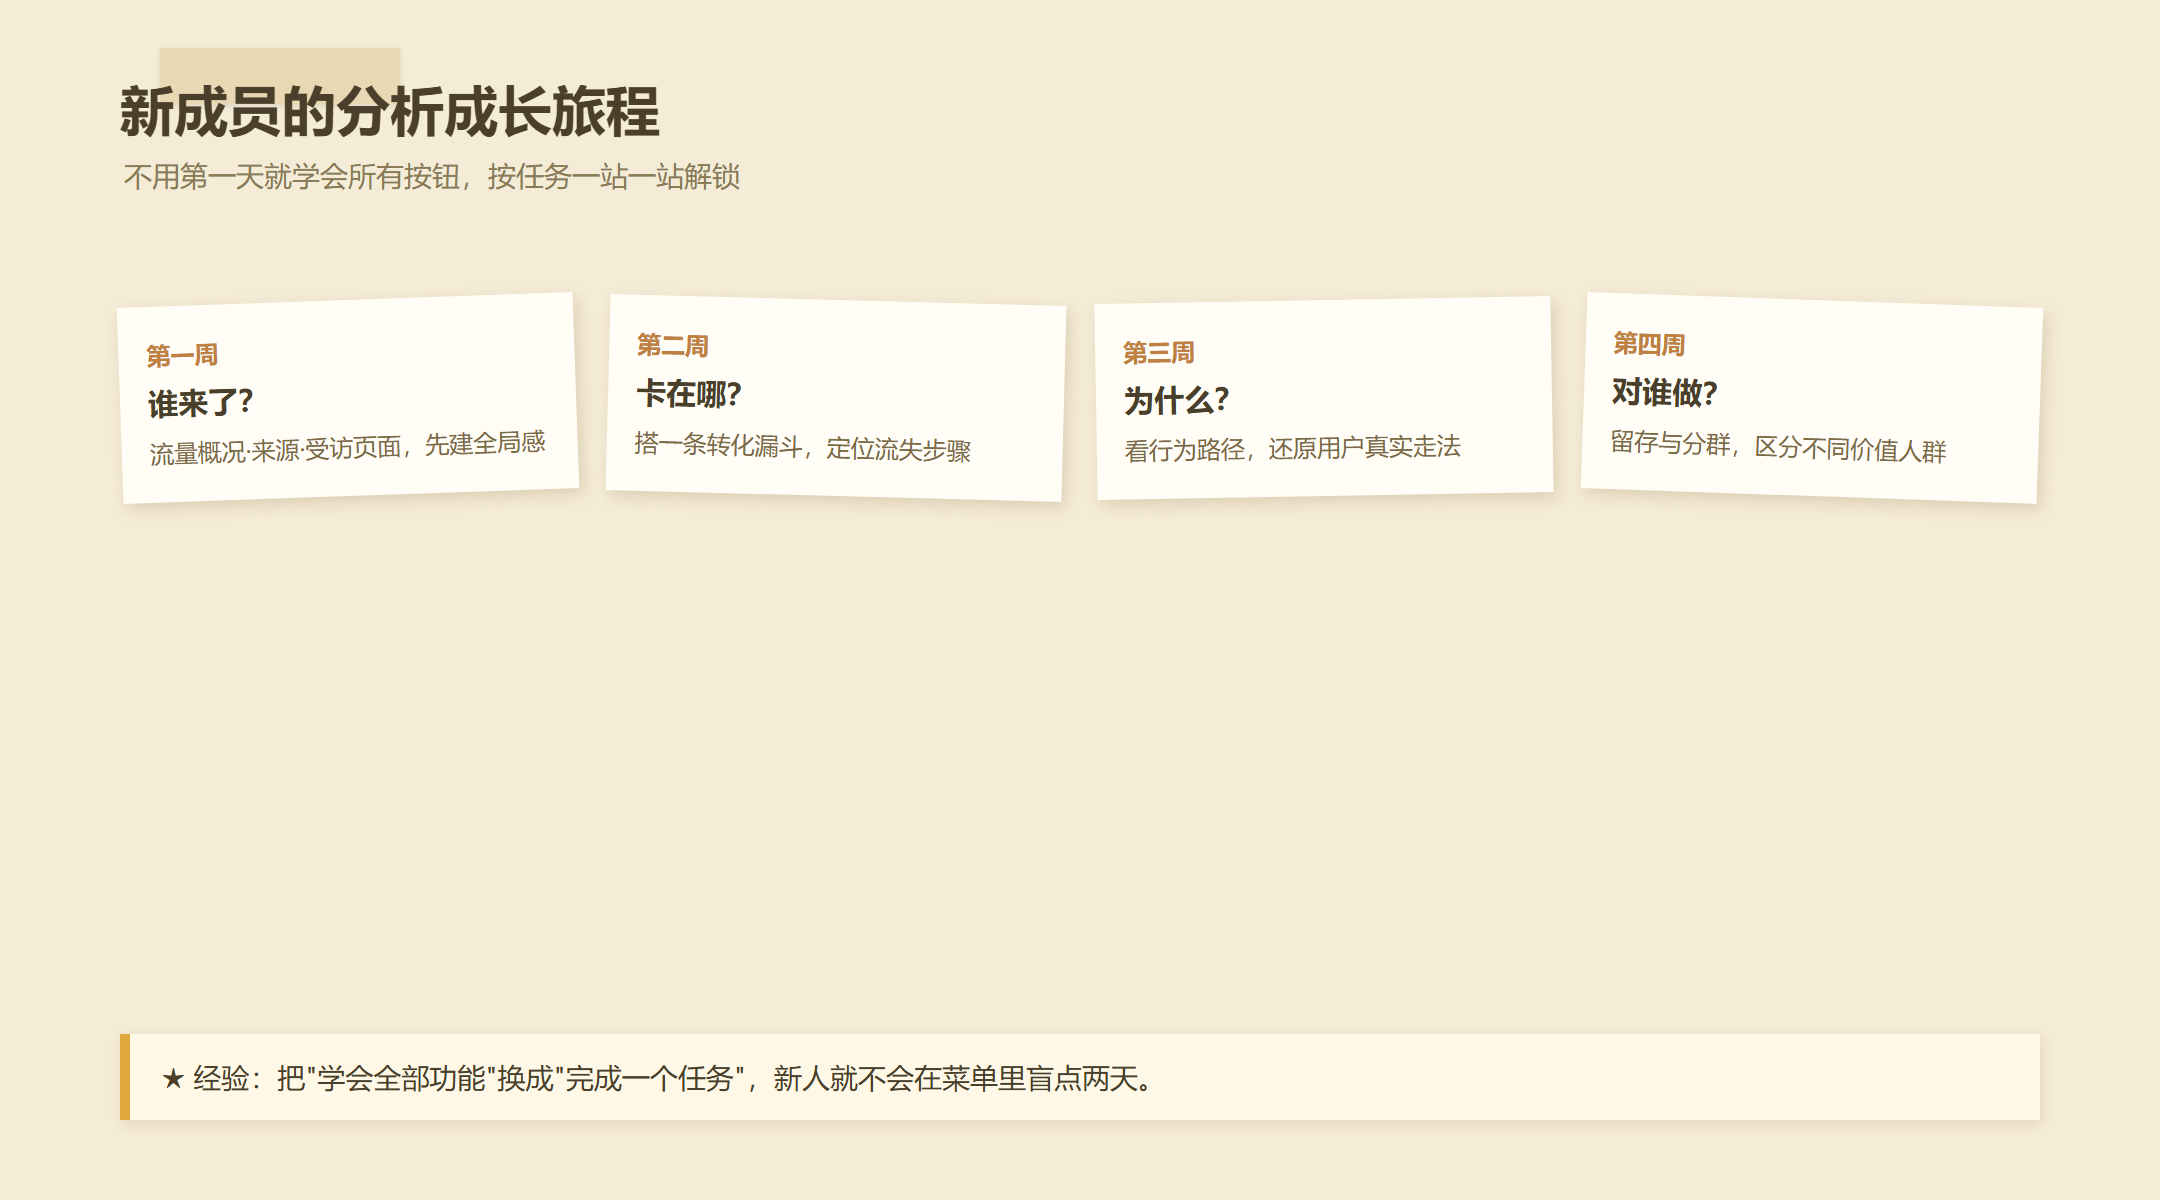
演示场景(不对应任何真实入职记录):新人入职第一周,Leader丢下一句话——"你先熟悉一下数据,看看用户都在干嘛"。她打开后台,看到事件分析、漏斗分析、行为路径、留存分析、用户分群一排菜单,每一个点开都是陌生的图表。没有人告诉她这些按钮分别对应团队里的哪类活,她整整两天都在"点点看看",却始终说不清自己到底在分析什么。工具买了、账号开了,能力却没有和团队任务挂上钩——这是内容团队在整理选型问题时反复见到的一类情形。用户行为分析工具的价值,不在于"功能多",而在于每个功能背后都有一件具体的团队任务在使用它。下面按团队真实会接到的几类任务逐项对照:这一类活团队自己要做什么、工具能承接什么、什么事...
10 / 09·阅读 33
 网站流量指标三层看板:PV、UV、跳出率的阅读顺序
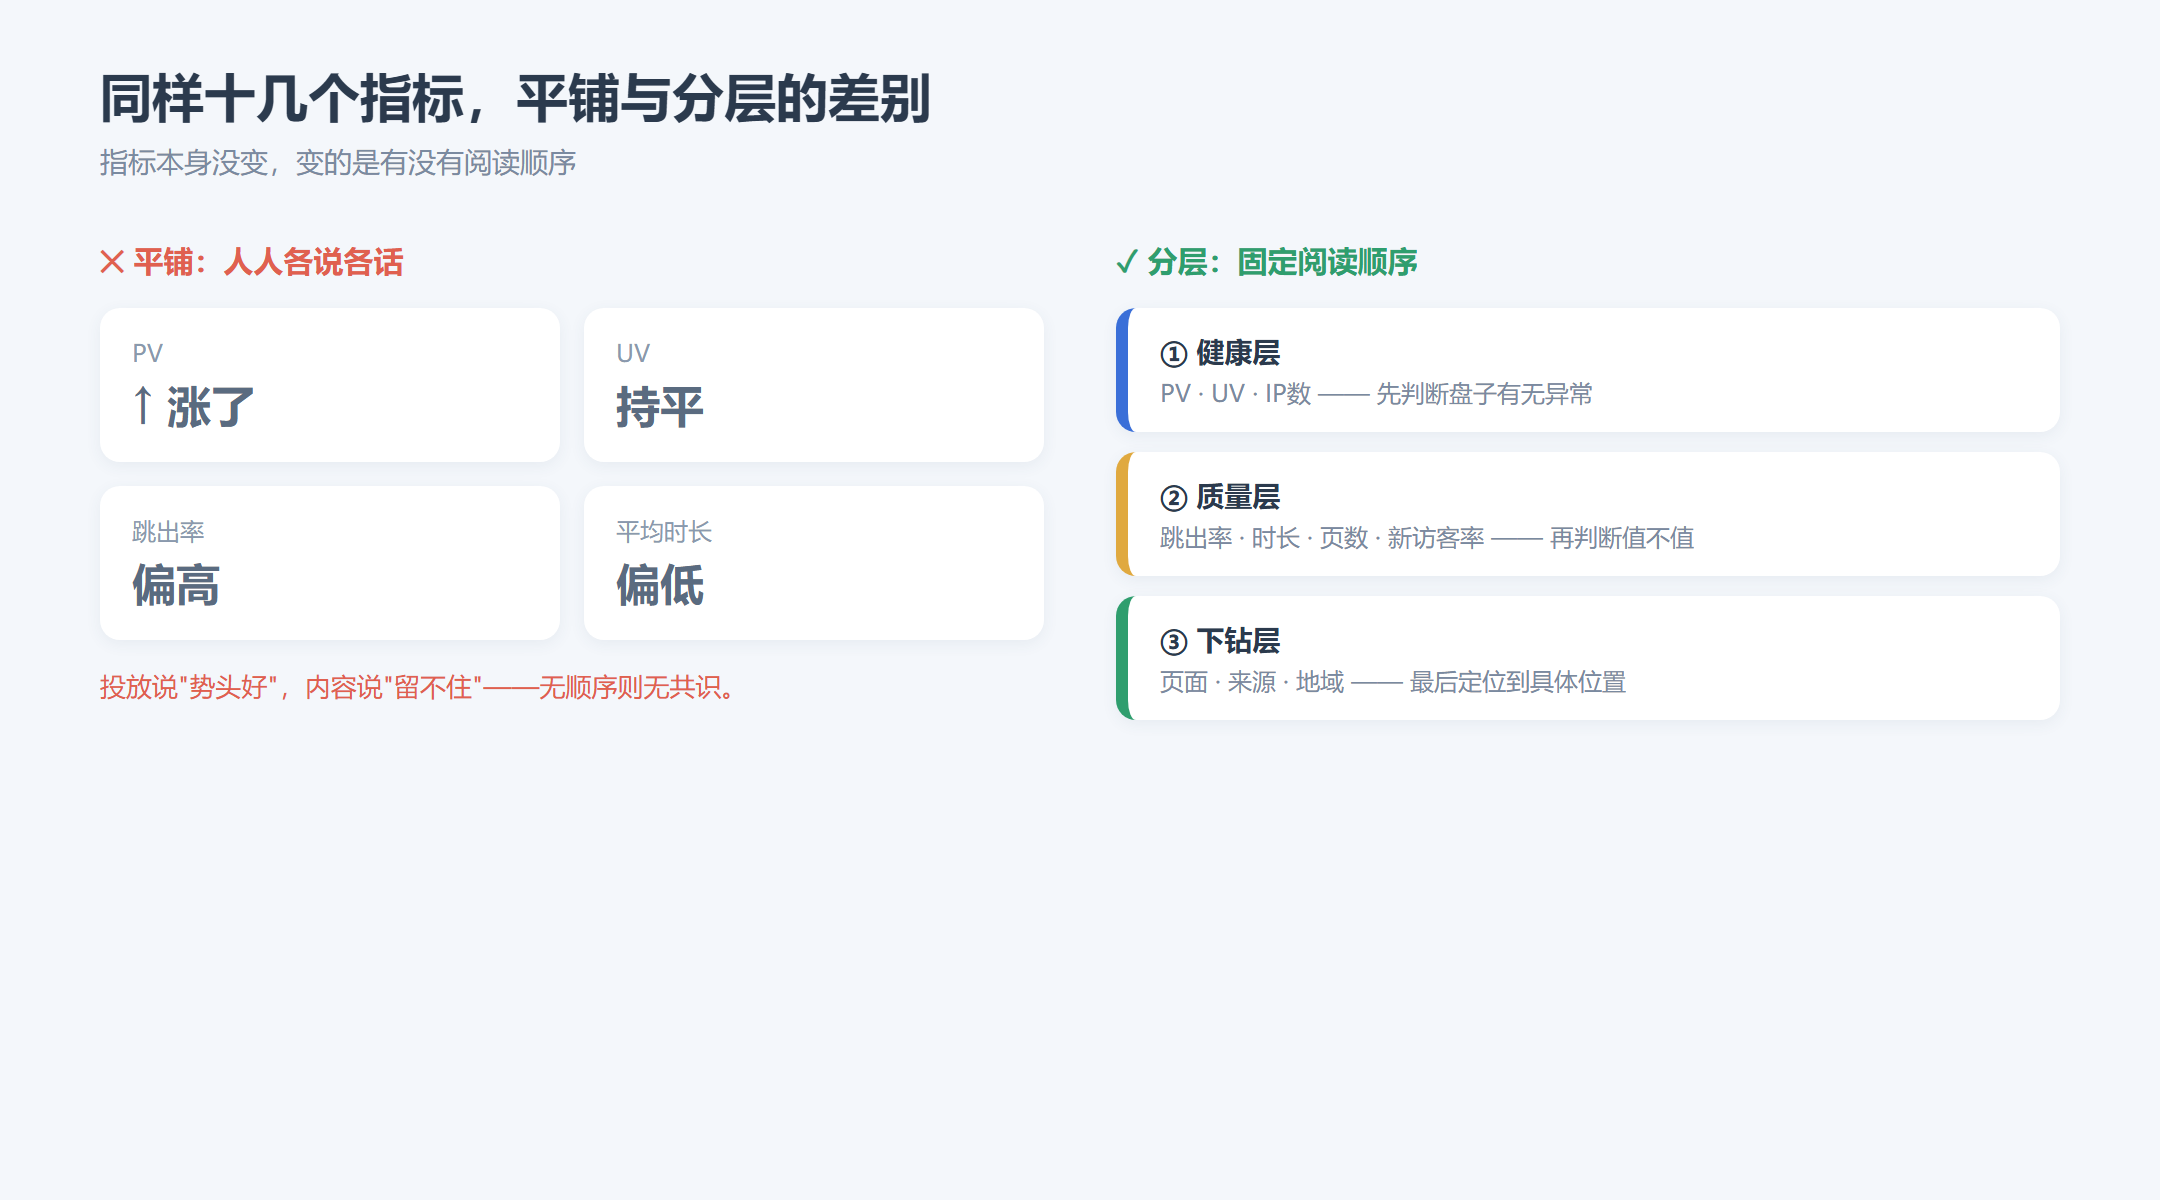
先看一个演示场景(不代表任何真实会议记录):月初的复盘会上,负责投放的同事指着大屏说,这个月PV涨了不少,势头很好;负责内容的同事却摇着头,说跳出率偏高,留不住人。两个人盯着同一块看板,得出了相反的结论。问题不在谁对谁错,而在于十几个指标被平铺在同一屏上:PV、UV、IP数、新访客率、跳出率、平均浏览时长、平均浏览页数,谁也说不清开会时到底该先汇报哪一个——指标一多,没有层级,讨论就会退化成各说各话。多数流量统计工具默认把所有指标一股脑摆出来,却不说明它们之间的从属关系。一个成熟的看板不应该是指标的堆砌,而应该是一棵有顺序的树:先看哪几个判断"健不健康",再看哪几个判断"为什么",最后才下钻到...
10 / 09·阅读 28
 456数据埋点方案文档:怎样明确事件负责人
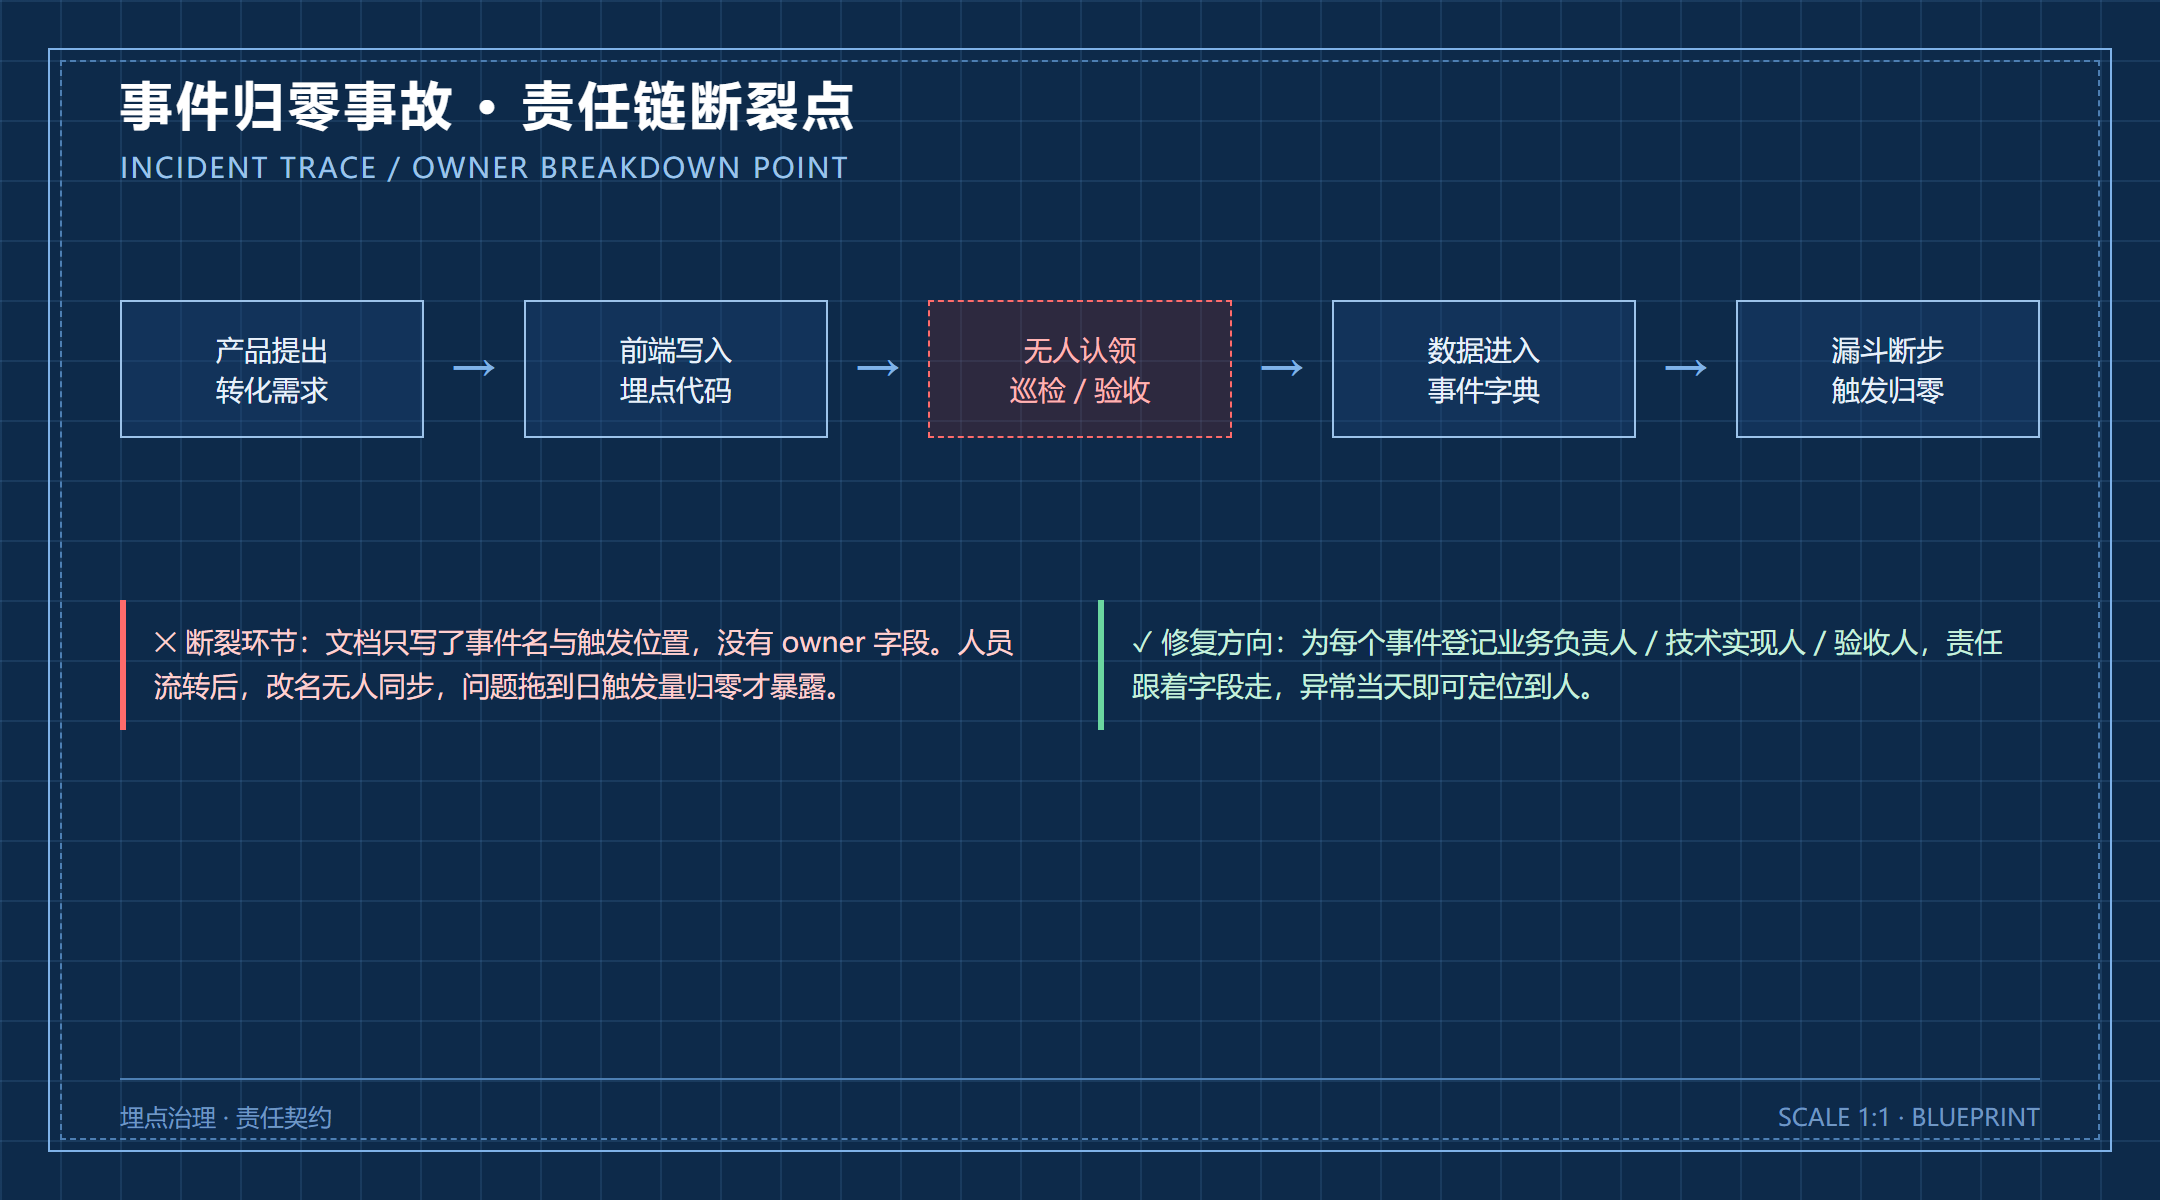
先看一个演示场景(不指向任何真实事故记录):假设网站端某转化事件的日触发量突然掉到零。值班同学先怀疑是前端发布事故,回滚之后数据依旧是零;再去翻数据平台,发现事件其实还在上报,只是事件名称在某次代码重构里被改动了一个字符。真正棘手的并不是这个字符本身,而是没有人能立刻说清:这个事件当初由谁定义、由谁验收、出了问题该找谁。埋点方案文档里只写了事件名和触发位置,没有写负责人。一旦人员流转,这个事件就成了"无主之物"。埋点本质上是一套跨端、跨团队的"事件接口":接口没有负责人,就等于接口没有owner。事故爆发不是因为缺工具,而是责任边界在文档阶段没有被显式定义。下面按复盘顺序展开:先看根因,再看处...
10 / 09·阅读 30