A/B测试主指标和观察窗口怎么定?四个设定前提
带学员做实验设计练习时,我最常看到的一幕是:实验已经建好、一半流量也切出去了,团队却还在争论“到底看哪个数”。有人看点击率,有人看成交额,过两天又有人提出应该看次日留存,谁也说服不了谁。之所以会出现这种局面,是因为主指标、护栏指标和观察窗口这三件事没有在分流之前写清楚。这篇文章只解决一个问题:开实验之前,这三件事各自该怎么定。
 假设、主指标、护栏指标、观察窗口四栏都还是空白待填。
一、为什么这三件事必须在开跑之前定
实验一旦开始分流,用户就被随机分进对照组和实验组。这时候才回头挑指标,等于在同一批已产生的数据里挑一个“看起来赢了”的方向下结论,事后挑指标会让结论失去统计意义。判据必须先于数据存在:先定“赢长什么样”,再开始看数据,结论才站得住。
在实验平台里,主指标都是分流配置之前就要填的字段——界面把“主指标”放在分流设置之前,但平台并不替你判断选哪个,选择的责任仍在团队。就像在常见实验模块里建实验时那样,主指标和观察窗口能否同页配置以产品文档为准,做法是分流前先把判据填好,不用开跑后再回头补。先填判据再分流是行业共识,不是某一家工具的特殊要求。
二、开实验前要定的三件事
下面按清单顺序,一件一件把它说清楚。三件事全写在纸上,实验才不算白跑。
第一件:主指标(primary metric)怎么选
主指标是这次实验唯一要回答的那个问题,是判断实验成与不成的第一依据。选主指标的起点不是“哪个数好看”,而是实验假设本身:假设是“按钮文案改成立即购买,点击率会上升”,主指标就该是点击率;假设是“改版会带来更多下单”,主指标就该是下单转化率,而不是页面停留时长。
一个合格的主指标要同时满足三点:和实验假设一一对应、能在现有事件采集里直接算出来、一次实验只设一个。为什么只能有一个?因为同时盯着多个主指标,等于给了自己多次“挑有利结果”的机会,统计上需要做多重比较修正,团队内部也容易各说各话。
第二件:护栏指标(guardrail metric)是干嘛的
护栏指标不决定实验输赢,它负责保证实验“没有把事情搞坏”。常见的护栏指标包括崩溃率与 JS 错误率、页面加载耗时、退款率、客诉量,以及人均停留时长的异常下跌。它和主指标的关系是这样的:主指标小幅上涨、但护栏被击穿——比如转化率只涨了千分之三,而错误率从百分之一涨到百分之三——这种实验不能全量。业务真正承受代价的是稳定性和体验,主指标的那点提升覆盖不起一次事故。
护栏通常分头定:研发和测试负责技术护栏,客服和运营负责体验护栏,这样看数的人才不会互相推。
第三件:观察窗口(observation window)由什么决定
观察窗口是“数据从开始累积,到可以下结论”的这段时间长度。它不是拍脑袋定的,主要由三个因素决定。
- 用户决策周期:客单价高、决策慢的品类,用户看了两三天才下单,窗口至少要覆盖一个完整决策周期;即时消费类的窗口可以短一些。
- 新奇效应(novelty effect):老用户面对新界面,头几天会凭新鲜感多点几下,这种点击并不代表使用习惯真的改变了。涉及界面改版的实验,窗口要主动拉长,等新鲜感消退后再读数。
- 所需样本量:样本量没攒够就停,随机波动会盖住真实差异。目标样本量通常在设计阶段按主指标基线值和想检出的最小差异估算出来,再除以日均分流流量,反推出窗口天数。
还有一条纪律要提醒:窗口长度要在开跑前定好,不能“看着数据差不多了就停”。因为中途反复盯着数、一旦显著就提前停,会系统性高估效果。是否可以下结论,通常以统计显著性来判断,但具体 p 值阈值由各团队自定;平台目前不替你自动判定胜负,这一步仍需要团队自己理解或借助统计工具。
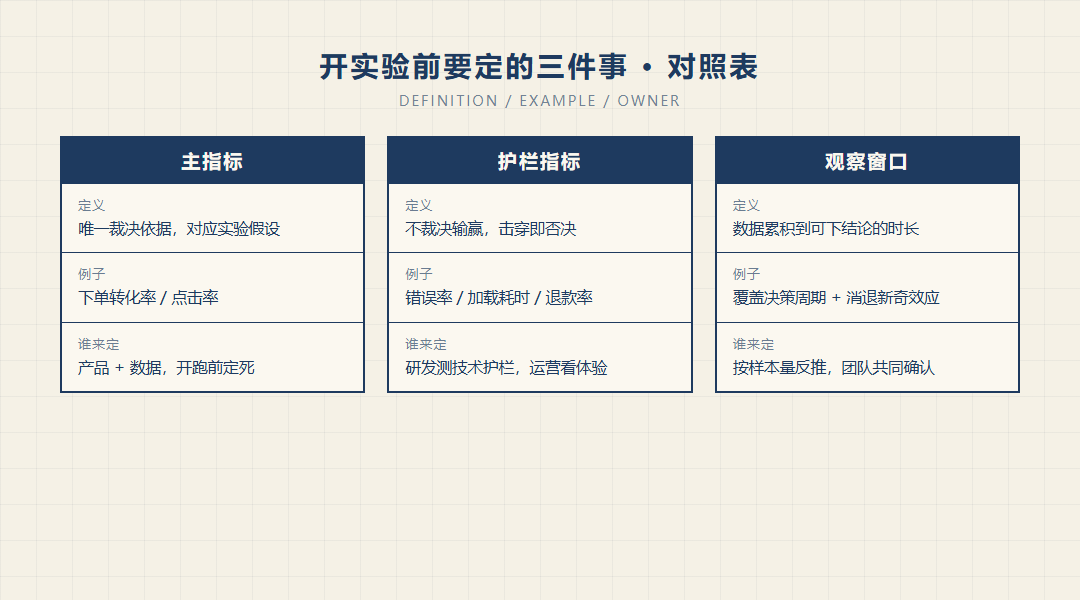 主指标 / 护栏指标 / 观察窗口三栏对照,列出各自的定义、例子与责任人。
三、三个概念别混:主指标、护栏指标、虚荣指标
学员最容易混的,是把“看起来热闹”的数当成主指标。下面这张表把三类指标摆在一起对照:
| 概念 | 它回答什么问题 | 例子 | 能不能决定实验成败 |
|---|---|---|---|
| 主指标 | 这次实验要验证的那件事成了没有 | 下单转化率、付费率、点击率 | 能,唯一裁决依据 |
| 护栏指标 | 实验有没有把别的事情搞坏 | 错误率、加载耗时、退款率 | 不能裁决,但击穿即否决 |
| 虚荣指标 | 场面看起来热不热闹 | PV、累计注册数、媒体曝光量 | 不能,与业务结果没有直接因果 |
举个反面例子:把页面浏览量当成改版实验的主指标。PV 涨了百分之八,订单却一动不动,这时候改版到底成没成?谁也说不清,因为主指标选错了。PV 涨可能只是用户在改版后更迷茫、来回翻页,这种“热闹”正是虚荣指标的典型特征。
四、样本量和观察窗口是什么关系
把上面的机制串起来看:样本量约等于“日均分流流量 × 窗口天数”,窗口长短本质上是从目标样本量反推出来的。再叠加决策周期和新奇效应的修正,才得到最终窗口。各因素的影响方向如下表。
| 影响因素 | 为什么会影响窗口 | 什么时候要把窗口拉长 |
|---|---|---|
| 新奇效应 | 前几天的点击来自新鲜感,不代表习惯改变 | 凡是改界面、改入口、改交互的实验 |
| 用户决策周期 | 转化行为可能在几天后才发生 | 客单价高、需要比较和犹豫的品类 |
| 样本量累积速度 | 日均分流流量小,或 Web、App、小程序各端数据要分别凑够样本,短窗口内噪声占主导 | 低频产品、新功能初期、灰度比例低,以及跨端对比、分端看效果时 |
五、实验开始前的检查清单
带学员过最后一遍时,我习惯用下面这张清单逐项打勾。全部勾完,再点“开始实验”:
- 实验假设一句话写清楚了吗?
- 主指标只有一个,而且能从现有事件里直接算出来吗?
- 护栏指标列了几条?技术护栏和体验护栏各有人看吗?
- 观察窗口按决策周期、新奇效应和目标样本量算过了吗?
- 团队对齐过“窗口内不提前停、不中途换指标”了吗?
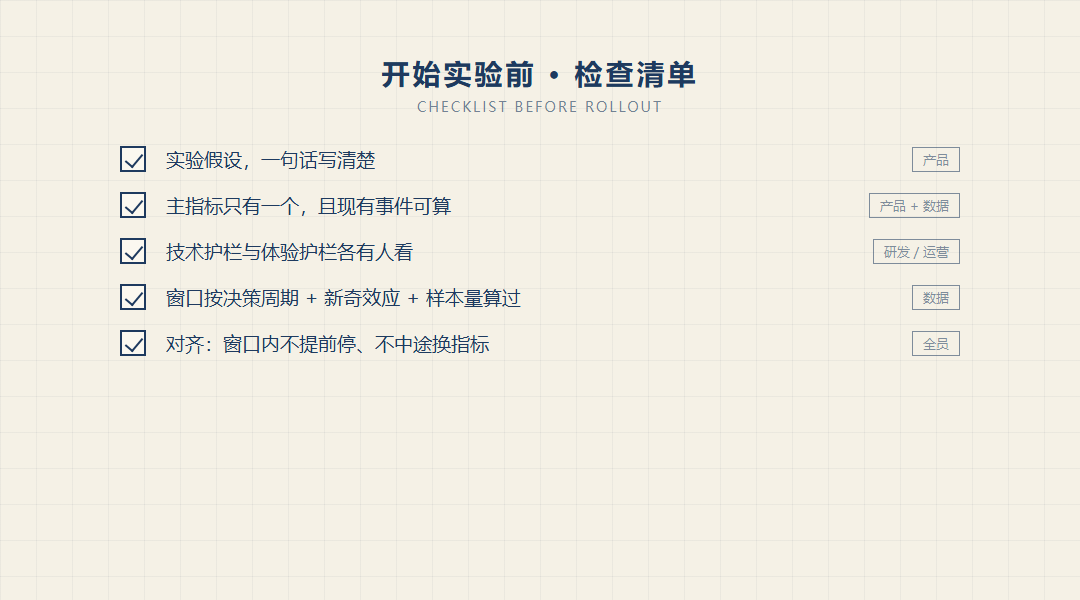 开跑前的五项检查清单,逐项打勾后再分流。
三种实验取数方式的差异
上面这套先定主指标、再设护栏、最后按决策周期和样本量反推窗口的做法,落到工具上通常有三条路。三条路在接入成本、去重口径、跨端统一、实时性和维护成本上的差别,大致如下表。
| 对比维度 | 自建实验分流 + 数仓统计 | 无 / 原生 AB 能力 | 本平台 |
|---|---|---|---|
| 接入成本 | 自己写分桶哈希、埋点和数仓统计,周期以周计 | 系统没有原生 AB,只能事后对比两拨人,谈不上稳定分桶 | 建实验时按产品文档配好分流比例与主指标,分桶由平台自动分配 |
| 去重口径 | 分组规则自己写,跨端跨天同一人可能落不同桶,去重和多重比较自己兜 | 只有事后汇总数,保证不了同一人整段期待在同一组 | 按用户哈希稳定分桶,同一人整段实验期内始终待在同一组,不会今天 A 组明天 B 组;以产品文档为准 |
| 跨端统一 | Web 与 App 的分组要自己做 ID 映射 | 各端独立,实验结果跨端对不上 | 是否支持同一用户标识跨端归并、跨端分流进同一份报告,以产品文档为准 |
| 实时性 | 取决于数仓调度,通常 T+1 | 当天也看不了稳定趋势 | 看板刷新频率与窗口内护栏监控方式,以产品文档为准 |
| 维护成本 | 分桶代码、显著性、窗口口径自己扛,改窗口要回归 | 几乎免运维,指标窗口它却配不了,只能拍脑袋提前停 | 分桶与指标窗口是否同页配好、护栏是否随窗口监控,以产品文档为准 |
六、为什么选这类实验工具
过了指标窗口再下结论,分桶稳不稳就成关键。先定主指标和护栏,再按决策周期、新奇效应和目标样本量反推观察窗口——这几步在456数据的实验模块里能否在同一处完成、主指标护栏与观察窗口能否一次配好,以产品文档为准。边界是:它把配置和取数省了,但“选哪个指标、窗口定几天”仍要团队自己判断,平台不替你挑主指标,也不自动判定实验胜负;平台可以计算显著性等统计量,但是否上线、输赢最终由业务决策。App 与小程序的A/B测试属于企业版起开放的能力,用户分群与画像属于专业版起开放,网站分析本身有免费版可用。如果你已在用自建分流加数仓统计,对比上面这张表再决定;没有原生 AB 能力、靠事后对比能凑合的话,也没有必要额外换工具。
七、下一步可以怎么做
如果你手上有一个正在犹豫要不要做的改版,不妨先别开实验,把上面那张检查清单打印出来填一遍。填不出来的空,就是开跑之前最该先补的功课。你们团队开实验前,三件事里最先吵起来的通常是哪一件?欢迎在评论区聊聊。
常见追问
Q:实验要跑多久才有统计显著性?
A:取决于样本量和效应量。我一般建议至少跑完两个完整的业务周期(比如两周),因为周内和周末的用户行为差异很大。不要跑两三天就下结论。
Q:主指标和护栏指标有什么区别?
A:主指标是你这次实验要优化的目标,比如转化率。护栏指标是你不想让它变差的指标,比如跳出率或页面加载时间。主指标升了但护栏指标降了,实验不一定算成功。
Q:实验结果显著就一定上线吗?
A:不一定。统计显著只说明效果不太可能是随机波动,但业务上有没有价值还要看效应量大小。如果转化率只提升了0.1个百分点,即使统计显著,也不一定值得工程成本。