资源失败率没涨但加载变慢?Resource Timing定位方法
上周有个做电商的朋友约我喝咖啡,坐下没两句他就皱着眉问:“我们监控里资源失败率一直平着,一个告警都没报,可老板最近总说页面越来越慢,这到底是哪儿出了问题?”我反问他一句:你盯的是失败率,那你看过耗时趋势吗?他愣了一下——显然没有。
这其实是个特别典型的错位。失败率和加载耗时,本来就是两件不相干的事:失败率统计“加载失败”的资源占比,耗时统计“加载成功、但花了多久”。一个资源每次都加载成功,只是从 1 秒慢慢变成 3 秒,失败率纹丝不动,用户却实实在在觉得页面变卡了。“监控没叫、老板却在叫”,往往是因为团队的告警只盯着失败率,没有人持续盯耗时趋势。
一、失败率和耗时,为什么会错位
我给他画了张图:左边是四周资源失败率,基本走平;右边是四周平均加载耗时,从第三周起整体抬了一个台阶。两条曲线口径完全不同,所以单看左边系统是“健康”的;单看右边,体验已在悄悄劣化。真正被用户感知到的,恰恰是右边那条线。
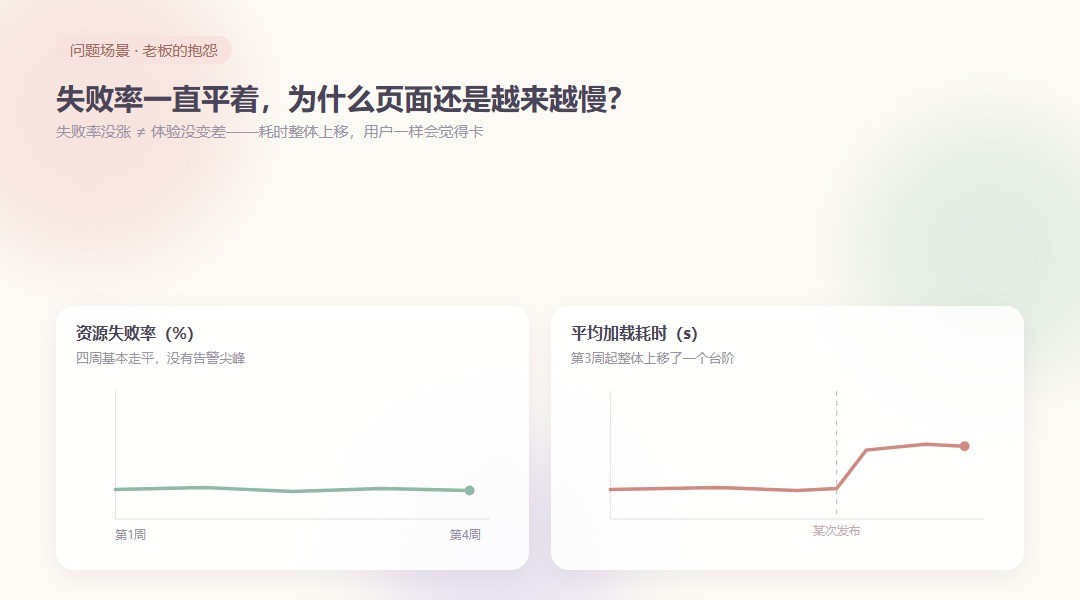 失败率四周走平,平均加载耗时在某次发布后整体上移一个台阶
还有一个容易踩的坑:平均耗时会骗人。大多数资源加载得飞快,少数资源慢得离谱,一平均曲线很好看,但那批慢用户才是真正吐槽的来源。所以看趋势时,我一般不只看平均值,还会留意靠后的分位,比如 P90、P95——中位数代表大多数人,分位靠后的那一段才对应真正觉得卡的人。这也是为什么失败率平着、平均值也没怎么涨,用户依然会抱怨页面慢。
二、有人问我:那慢资源到底从哪儿看起
他顺着又问:“既然耗时会骗人的眼睛,那我该从哪儿下手,把那个拖慢页面的资源揪出来?”我跟他说,不用上来就翻每一条请求,按三个角度各切一刀,慢资源自己会浮出来。
1. 按资源类型切:JS / CSS / 图片 / 接口谁在拖
先把所有资源按类型分开看平均耗时。JS、CSS、图片、接口这四类资源,慢掉的原因和优化手段完全不同:图片大了要压缩,接口慢了查后端,JS 体积涨了查是不是又塞了个大依赖。先粗分类型,能避免一上来就陷进某个资源的细节里。
2. 按页面维度切:是全站慢,还是某几个 PV 页慢
分出类型后,把耗时放回具体页面上看。全站每个 PV 页耗时都同步上移,更可能是公共脚本、公共 CDN 或一次全站发布的问题;只有首页和商品详情页慢,问题就出在这两个页面自己的资源上。按页面切,是为了区分“全局问题”和“局部问题”,两者排查入口完全不同。
3. 按时间趋势切:是慢慢劣化,还是突然变快
最后回看耗时随时间的曲线。耗时一周周慢慢爬上去,更像图片越传越多、依赖越加越大的累积效应;某天突然跳一个台阶,几乎可以肯定是那次发布、新版本或某个第三方脚本变更引入的。时间趋势能直接告诉你该翻哪一天的发布记录。
| 切法 | 看什么 | 它能回答的问题 |
|---|---|---|
| 按资源类型 | JS / CSS / 图片 / 接口各自的平均耗时 | 是图片太大,还是接口太慢? |
| 按页面维度 | 耗时在各 PV 页面上的分布 | 是全站一起慢,还是单页拖后腿? |
| 按时间趋势 | 耗时随天 / 随版本的曲线 | 是缓慢劣化,还是一次变更引入? |
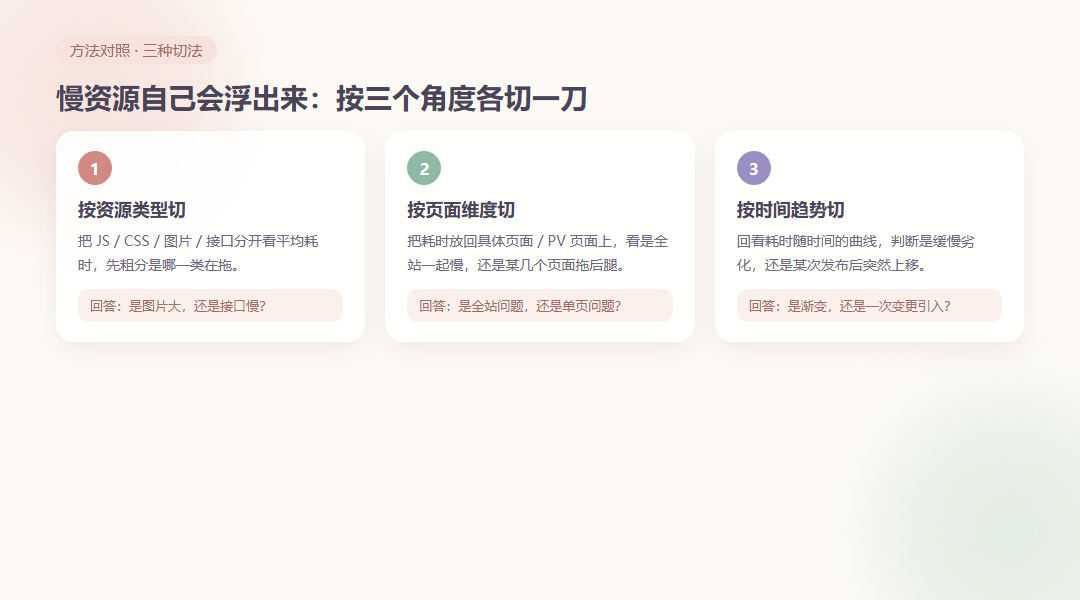 三种切法对应三类问题,先粗分再聚焦
三、再有人问:慢,到底慢在哪一段
他听完又追问:“就算我找到那个慢资源,怎么知道时间花在哪了?”这就要用到浏览器的 Resource Timing API。它把每个资源从发起到加载完成拆成好几段独立时间戳,你能直接读出每一段花了多久,而不是只有一个“总耗时”的黑盒。
| 阶段 | 含义 | 这一段慢了,通常说明什么 |
|---|---|---|
| DNS | 域名解析耗时 | DNS 配置或解析服务器有问题 |
| TCP | 建立连接的耗时 | 网络链路远、握手慢或连接数紧张 |
| TTFB | 首字节时间 | 服务端处理或后端响应慢 |
| 响应 / 下载 | 内容传输耗时 | 资源本身体积太大、传输没压缩 |
这里有个本地复现细节要提醒:在办公室千兆宽带里复现,很可能怎么都复现不出用户的慢。大量用户其实是在弱网环境下打开页面。所以在 Chrome DevTools 的 Network 面板里,把节流档位手动切到 Slow 3G 再刷新,才能贴近真实用户的网络条件,也更容易把那个“下载段特别长”的资源暴露出来。
补一句:分阶段时间戳好用,是因为它能把“慢”从一种感觉变成几个可对比的数字——我在加载分析里就是把 DNS、TTFB、下载分段拆开看的。不过有个采集边界要讲清:跨域资源只有在服务端返回 Timing-Allow-Origin 响应头时,页面才能读到 DNS、TCP、TTFB 这些分段时间;没有这个响应头,这些字段会被浏览器置为 0,这是浏览器的隐私限制,属正常现象,不是监控采集故障,排查时别误判。比如同样是总耗时 2.8 秒,一种情况是 DNS 占了 2 秒、后面飞快,另一种是前面都快、最后下载占了 2 秒——前者要查域名解析,后者要压图片,处理方向完全相反。病根落在不同阶段,优化动作就必须跟着阶段走,而不是笼统说一句“网站慢了,要优化”。
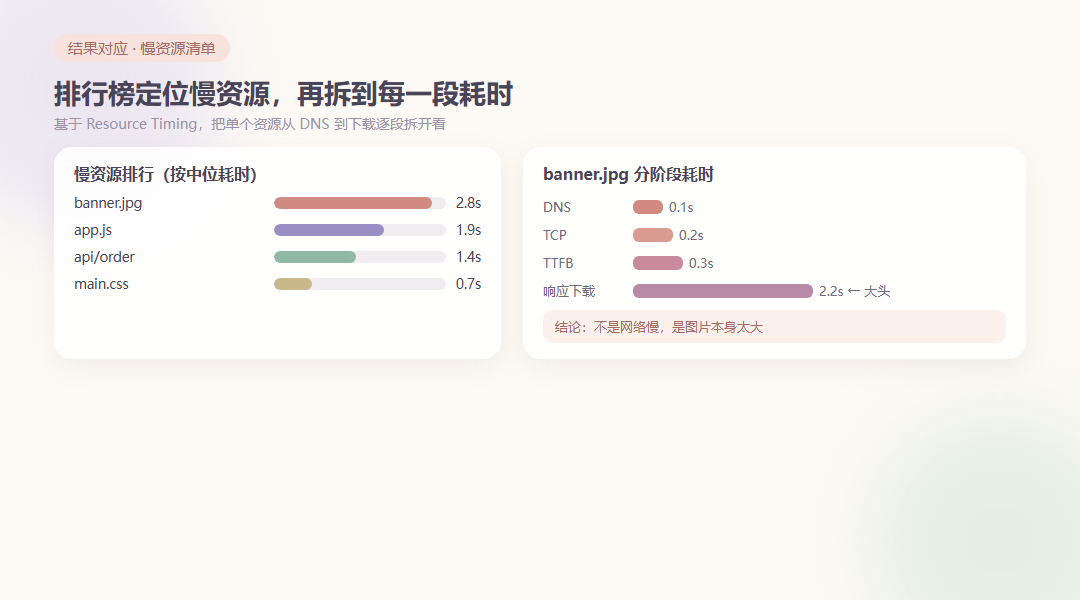 排行榜定位慢资源,再按 DNS / TCP / TTFB / 下载逐段拆解
四、关于“多少秒算慢”,我先把边界说清楚
聊到这儿,他很自然地问:“那超过几秒才算慢?有没有个标准?”这个问题我一般会先泼一点冷水。业内常被引用的 LCP 参考线,是 Chrome 团队在 web.dev 上给的:良好体验建议把 LCP 控制在 2.5 秒以内。但要注意两点口径:第一,这个 2.5 秒应按真实用户访问的第 75 百分位(P75)评估,而不是某次请求测出的单次值——单次刷新可能正好撞上弱网或缓存命中,波动极大,只有 P75 才代表大多数用户的体验;第二,LCP 是 Largest Contentful Paint,即页面最大内容元素的渲染时间,衡量整页可感知加载速度,和前面拆的“单个资源 DNS/TCP/下载耗时”不是一回事,别拿单资源分段耗时去套 LCP 阈值。这只是一个广泛参考的体验阈值,不是某家监控平台的承诺,也不能不加区分地套到每个网站上。不同业务、地区、用户的网络条件差异极大,判断资源慢不慢,更稳妥的办法是和自己过去的基线比——比上周、比上次发布前,而不是照搬通用数字。
我也会顺手提醒他,别把参考阈值直接当考核线。2.5 秒这条线,是给“新用户第一次打开落地页”这类关键体验准备的参考;像后台管理页这种用户本有预期的页面,硬套这条线往往只会制造一堆无效优化。先想清楚哪个页面、哪类用户的体验最影响转化,再定拿哪个数字当目标,顺序才不会反。
三种慢资源定位方式的差异
上面这套按资源类型、页面、时间三个角度下钻,再把单个资源拆成分段的做法,落到工具上通常有三条路:自己写性能采集脚本上报、用浏览器 DevTools 或自带性能面板、用第三方加载分析平台。三者在接入成本、去重口径、跨端统一、实时性和维护成本上的差别如下表。
| 对比维度 | 自建性能采集脚本 | 浏览器 DevTools / 原生性能面板 | 加载分析平台 |
|---|---|---|---|
| 接入成本 | 自己写 PerformanceObserver 注册 resource 条目、再建数仓存分段时间戳,周期以周计 | 浏览器本地打开即可,零接入,但只看得到当前这台机器 | 资源 timing 自动采集,不用自己给每个资源插桩,嵌一段 SDK 即可 |
| 去重口径 | 自己按用户和会话聚合 DNS / TTFB / 下载各段分位,边界容易漏 | 没有聚合,只有单次会话的瀑布图 | 按用户、地区自动聚合分段分位数(P50 / P90 / P95 是否内置、具体口径以产品文档为准) |
| 跨端统一 | Web 端要自己和 App 的性能数据打通 | 只覆盖当前浏览器,App 完全看不到 | Web 与 App 的加载耗时是否进同一份报表,以产品文档为准 |
| 实时性 | 自己搭采集,刷新跟着数仓跑批走 | 实时,但样本只来自你本机 | 耗时分段数据当天可看趋势,看板刷新频率(如分钟级)以产品文档为准 |
| 维护成本 | SDK 升级、跨域 Timing-Allow-Origin 兼容、分位算法都要自己扛 | 后台免维护,线上真实用户的资源耗时却采不到 | 不用自己维护资源性能埋点,采集与发版升级由平台承担,自己只做筛选 |
常见追问
Q:LCP多少算正常?
A:web.dev给出的参考阈值是第75百分位在2.5秒以内算良好。但这是参考线,不是考核线。我建议和自己过去的基线比,因为不同网站的资源体量差异很大。
Q:跨域资源为什么看不到详细耗时?
A:跨域资源默认只传输总耗时,不暴露DNS、TCP、TTFB等阶段。需要跨域资源响应头设置Timing-Allow-Origin,浏览器才会把详细阶段时间给到Performance API。
Q:平均加载时间能代表体验吗?
A:不能。平均值会被少数极快或极慢的样本拉偏。我建议看第75百分位和第95百分位,因为这两个分位数更能反映大多数用户和最慢用户的真实体验。
五、为什么选用456数据
把 DNS、TTFB、下载分段拆完,再谈选工具。先按资源类型、页面、时间三个角度下钻,再把单个资源拆成分段看,这两步在控制台里分别对应按类型、页面、时间的筛选,以及单个资源的分段耗时展示(具体分段字段、是否展示跨域资源细分,以产品文档为准)——不用自己写采集脚本和分位数 SQL,控制台切两下就能拿到。需要说清楚的边界是:它负责帮你把慢资源和慢的那一段定位出来,但“多少秒算慢”没有适合所有业务的通用答案,最终要不要优化、优化到多少,还要结合自己的基线判断。其中各版本(免费版/基础版/专业版)具体开放哪些能力、是否覆盖 App 与小程序性能监控与用户分群画像,以产品官网与后台套餐说明为准。如果你团队已经在用自建采集脚本,对比上面这张表的差异再决定;只靠 DevTools 能看清线上真实用户的话,也没有必要额外换工具。