新增规模忽大忽小?不同批次留存怎么比较
月底复盘会,桌上摊着两张表。这个月新增 12.6 万,上个月只有 4.8 万;一条新渠道刚铺开,老渠道又缩了一半。老板顺口问“哪个月的新增质量更好”,你盯着两个留存率——38% 和 45%——却迟迟不敢开口。可你心里清楚,这两拨人不是一个量级,直接拿数字比大小,很容易被规模带偏。
一、先把留存率的分母讲清楚
很多人之所以会比错,是把“留存率”理解成了“今天有多少人回来”。其实留存率回答的是另一个问题:当初那一批新人,过几天还回来几个。问题问的是“那批人留下多少”,三个常用口径的分母,都必须牢牢锁定在同一批新增用户身上。
- 次日留存 = 该批新增用户里,注册后第 2 天再次回访的人数 ÷ 这批新增总数;
- 7 日留存 = 同一批人里,注册后第 7 天回访的人数 ÷ 这批新增总数;
- 30 日留存 = 同一批人里,注册后第 30 天回访的人数 ÷ 这批新增总数。
分母是“当天那批新人”,而不是全站当天的活跃用户,留存率才能用来衡量“这一批人究竟沉淀下多少”。把不同天、不同渠道进来的人混在一个池子里算,分母就漂了;分母一漂,后面的数字再漂亮也失去了横向比较的意义。
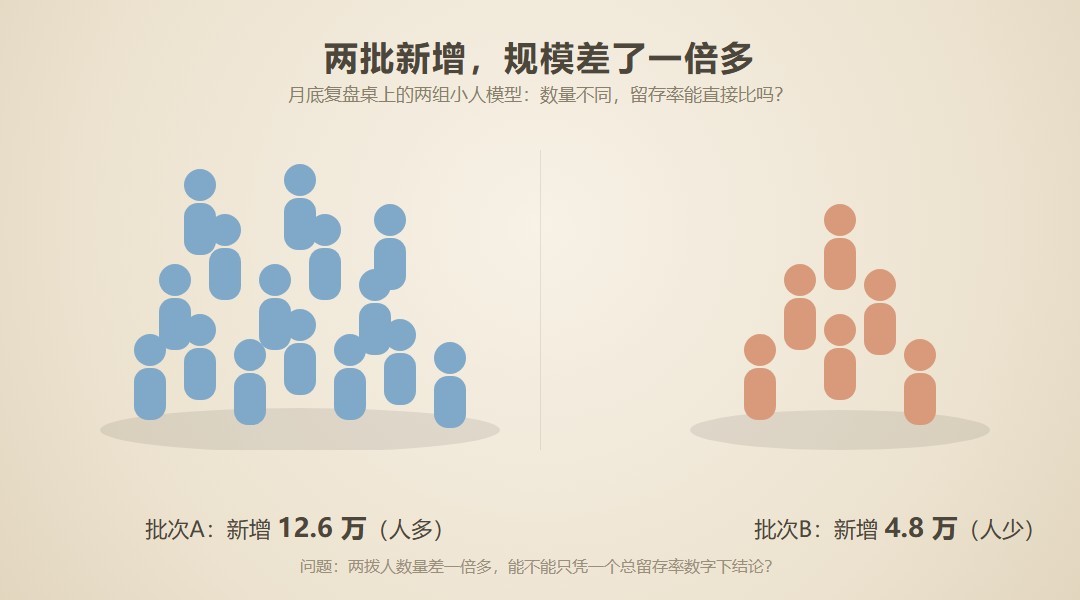 两批新增人群规模差异悬殊,单看一个总留存率无法直接判断质量。
二、为什么规模不同的两批,不能直接比
回到开头那组数字。本月新增 12.6 万里,有 8 万来自一次大促投放;上月 4.8 万则几乎全是自然流量。拿本月总留存 38% 对上月 45%,顺嘴就会得出“这个月质量在变差”的结论。但这个结论之所以可疑,正在于两批人的来源结构完全不同:大促拉来的用户里,本来就掺着更多冲着补贴来、领完就走的低意向流量。规模被一次性投放撑大,留存自然被摊薄——这不是算法出错,而是拿去对比的两群人根本不是同一类。
正确的做法,是把两批人各自放回自己的批次里,按注册日切cohort,再用同一套算法算留存。两种比法并排摆开,差别一目了然:
| 比法 | 分母怎么取 | 会导致什么结论 |
|---|---|---|
| 错误:合并算总留存 | 两批新增混在一个池子里 | 规模大的批次把整体留存摊薄,容易误判为“质量下滑” |
| 正确:分批次算 | 每个批次各自以当日新增为分母 | 每批在自己口径内可比,多批叠加后看曲线形状 |
一个被稀释掉的中间值
举个小例子就清楚了。假设 A 批当天新增 100 人,第二天回来 40 人,次日留存是 40%;B 批当天新增 1000 人,第二天回来 300 人,次日留存只有 30%。如果把两批揉成一个池子,你会拿 340÷1100≈31% 去和别的月份比,这个数字既不代表 A 批、也不代表 B 批,只是被规模稀释后的混合值。之所以混合值没用,是因为它把“质量”和“数量”压成一件事,你再也分不清哪批出了问题。
三、用 cohort 把两批新增放进同一张表
要做到同口径,动作固定为四步,缺一步都会让比较失真:
第一步:按注册日圈定各批次
输入:一段时间内的全部新增用户。动作:按注册日把新增切成一个个批次(cohort),一天一批、不跨天合并。输出:N 个独立批次名单。
第二步:对齐各批次 D1/D7/D30 口径
输入:每个批次名单,以及统一的“回访”定义。动作:固定每批当日新增为分母,用同一套 D1/D7/D30 算法统计回访人数,中途不换口径。输出:每个批次在 D1/D7/D30 上的留存率。
第三步:同图叠加比曲线形状
输入:各批次的 D1/D3/D7/D14/D30 留存率。动作:把多条留存曲线叠在同一张坐标里,横轴=注册后第 N 天,纵轴=该批仍回访用户占比。输出:一组可比较走向的曲线。
第四步:判断是真实留存差异还是口径不一致
输入:叠加后曲线的高低与斜率。动作:核对两批是否同一回访定义、同一用户标识去重、同一第 0 天起点。输出:是真实留存质量差异,还是口径不一致造成的假象。
在 cohort 留存模块里,按注册日分组、直接看到每个批次的 D1、D7、D30,这一档基础能力以实际开通版本与产品文档为准;配好后能省掉自己写 SQL 对齐分母的功夫。之所以强调“同一张表长出来”,是因为这样两批人口径天然一致,不会出现 A 批按自然日、B 批按回访周期这种暗坑。
还有个容易忽略的点:分组那天,必须和“这批人从哪一刻开始算”严格一致。注册日当天还在摸索产品的人,和已经逛完一圈的人,第二天回来的概率本来就不同;有的批次从注册日起算、有的批次从首次关键行为起算,曲线在起点就被人为掰歪。固定用注册日作为第 0 天,两批人才站到同一起跑线上。
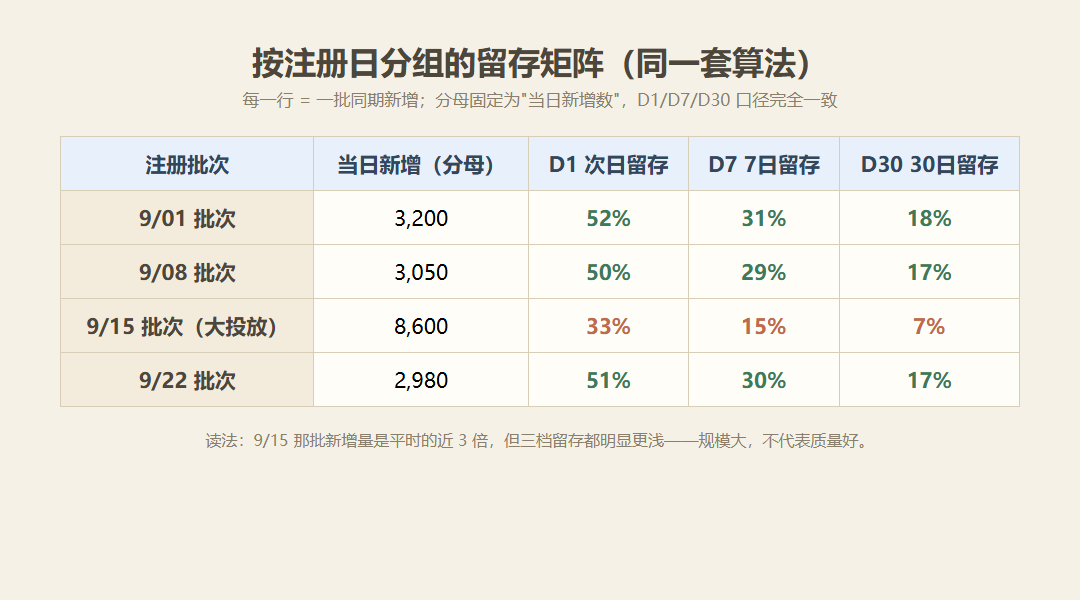 按注册日分组的 cohort 留存矩阵,每一行分母都是当日新增数。
四、同口径叠加之后,到底看什么
很多人拿到矩阵就急着挑“最高的那一行”,这又掉进另一个坑。不同品类、客单价的产品,天然留存基线差别很大,这里不提供行业基准值,也不预设哪个渠道“应该”更高。真正可比的,是同一张坐标里两条曲线的走向:
| 口径 | 分母 | 这一档主要反映什么 |
|---|---|---|
| D1 次日留存 | 当日新增 | 新人第一天体验完,第二天还愿不愿意回来 |
| D7 7 日留存 | 当日新增 | 一周内有没有初步形成回访习惯 |
| D30 30 日留存 | 当日新增 | 一个月后还沉淀下多少核心用户 |
看斜率,而不是孤立的点
如图,批次 A 规模大,但 D1 之后斜率很陡,说明拉新量大却意向浅;批次 B 规模小,但曲线走得平,说明这拨人虽少却留得住。要叠在一张图里看形状,别孤立报某一天的点:单点数字分不清“本来就这样”和“掉得更快”,斜率才把两批人的后劲拉开。
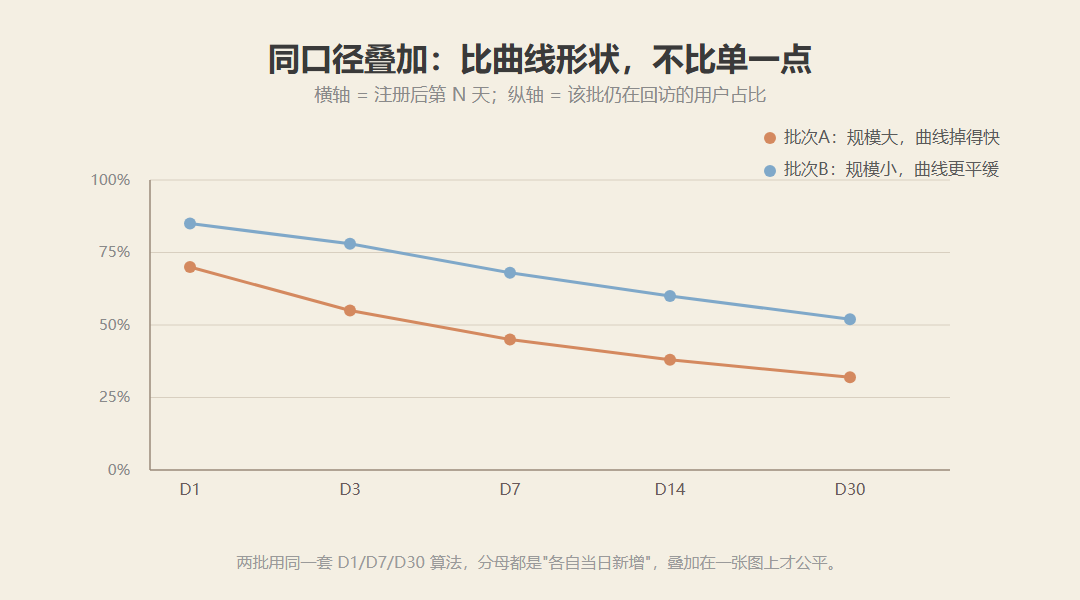 同一套算法、同一分母下,两批留存曲线叠加对比。
五、能力边界要先讲清楚
这里把话说在前面:这套方法只能做“同口径下的横向对比”,它不会告诉你行业平均留存是多少,也不会替你判断哪个渠道更值得投。外部基准会随品类、客单、拉新价格剧烈波动,硬套进来反而干扰判断。另外,cohort 留存的基础口径在基础版开放;按渠道、按端再往下拆的更细分群能力,要看对应套餐是否包含。
动手前先核对回访定义
动手对比前,还有件事值得先花十分钟核对:两批人是不是按同一个“回访”定义在统计。只要一端要求打开 App 才算回访、另一端把 H5 浏览也算作回访,分母里的“人”和分子里的“回访”就对不上,曲线叠上去也是假象。先按同一套用户标识跨端去重、回访只认主动打开,再谈两批谁高谁低,结论才站得住。
三种取数方式的差异
上面这套按注册日切批次、固定分母、再用同一套 D1/D7/D30 叠曲线的做法,落到具体工具上通常有三条路:自己写代码埋点和数仓、用网站或 App 自带的后台看板、用第三方分析平台。三条路在接入成本、去重口径、跨端统一、实时性和维护成本上的差别,大致如下表。
| 对比维度 | 自建埋点/代码方案 | 网站/App原生后台 | 456数据 |
|---|---|---|---|
| 接入成本 | 要为注册事件和每日回访分别上报、再按注册日把人归批建数仓,周期以周计 | 后台默认开通,零接入 | 嵌入一段 SDK,按文档配上注册与回访事件、选好分群日即可 |
| 去重口径 | 谁归进哪一批、回访按谁去重全凭自己写,跨天跨端很容易把人算错批 | 通常只给整体活跃留存,不按注册日把人分进不同 cohort | 按首次使用日或周把用户分进不同 cohort,同批人后续每天每周追踪回访,分组去重自动完成(具体口径以产品文档为准) |
| 跨端统一 | 要自己做多端 ID 映射,两端回访才能算进同一批 | 网站和 App 后台各自独立,留存口径对不上 | 多端回访按同一人归并,进同一张留存矩阵 |
| 实时性 | 回刷批次绑在数仓定时任务上 | 自带后台多为 T+1 或准实时 | 看板更新频率以实际配置为准,当天可看批次留存变化 |
| 维护成本 | 回访定义一改、cohort 切分日一调,整条留存矩阵都要重跑 | 开箱即有,却分不出不同批次的留存对比 | 升级节奏交给平台,自己只维护 cohort 口径与回访事件 |
为什么选这类第三方分析工具
把不同批次的人摆到同一时间轴上一比,工具的差别就出来了。按注册日切批次、固定当日新增为分母、再用同一套 D1/D7/D30 叠曲线。这几步在这类工具里通常已经预置——按注册日分组、两批矩阵长在同一张表里(具体以产品文档与开通版本为准),配置得当可以省掉自己拼 SQL、反复对齐分母的重复劳动,月底复盘时不用再花半天向上解释“这两个数为什么不能直接比”。其中网站分析本身有免费版可用,App 与小程序的 cohort 留存属于基础版起开放,按渠道、按端再往下拆的分群能力需要专业版起。如果你团队已经在用自建方案,对比上面这张表的五项差异再决定;原生后台够用的话,也没有必要额外换工具。
你们月底复盘时,是先盯新增总量,还是先拉分批次的留存曲线?有没有被一个“看起来很高”的总留存数字骗过?欢迎在评论区聊聊。
常见追问
Q:留存率看D1还是D7?
A:取决于你的产品类型。工具类产品D1更重要,因为用户第二天还来不来说明产品有没有用;内容类产品D7更重要,因为用户可能周末才来。我习惯D1、D7、D30都看。
Q:怎么判断留存下降是产品问题还是流量问题?
A:先按渠道拆分批次留存。如果某个渠道的批次留存明显低于其他渠道,那是流量质量问题;如果所有渠道都在降,那更可能是产品体验或竞争环境变化。
Q:新用户量突然变大,留存会被稀释吗?
A:会。如果新用户主要来自营销活动,他们的留存通常低于自然流量。所以比较留存时,一定要按获客渠道拆批次,不要把不同来源的用户混在一起算。