事件次数涨但触发人数降?三步排查重复触发来源
我做数据分析师这几年,被拉去开得最多的会,不是“增长了多少”,而是“这个数为什么和我感觉的不一样”。最典型的一幕是这样:早上例会,运营同事指着大屏说某个按钮的点击事件这周涨了三成,准备加预算;我把同一段时间的触发用户数拉出来,曲线却是往下走的。两条线一张嘴一闭嘴,当场就有人问,到底哪个是真的。
这种各说各话的局面,根子在于“事件次数”和“触发用户数”根本就不是同一个口径。很多团队把事件次数当成活跃人数在看,自然得出“次数涨了就是用户变多了”的结论。这个结论之所以危险,是因为它只统计了“发生了多少次动作”,却没有回答“这些动作到底来自多少个人”。下面我按自己排查这类问题的顺序,把口径、原因和定位方法拆开讲清楚。
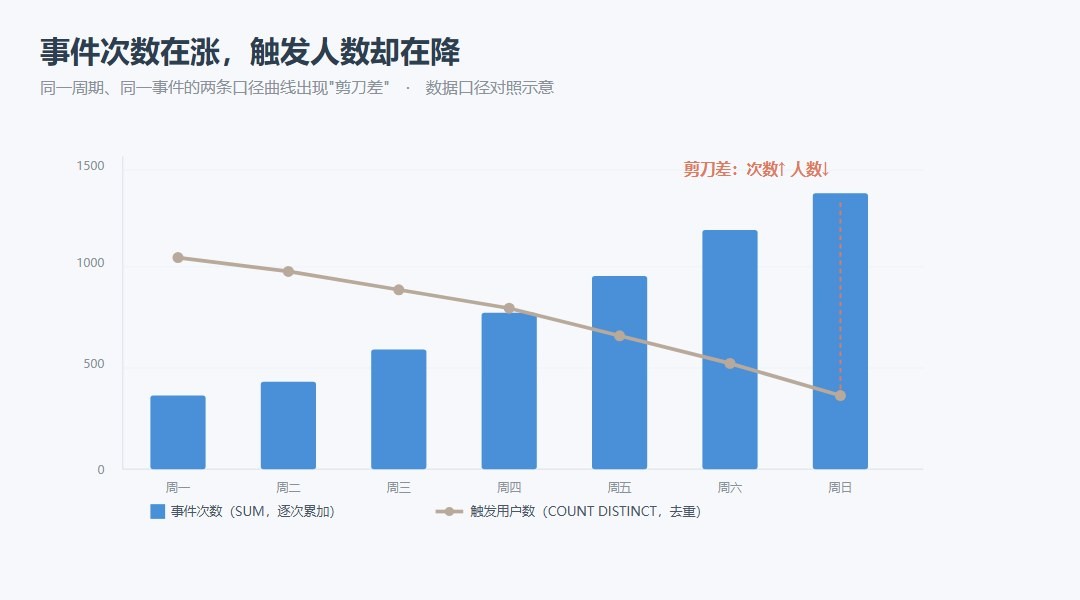 图1 同一周期内事件次数上行、触发用户数下行的“剪刀差”,是这类问题的典型信号
先把两个口径摆到同一张图上
要判断一次上涨是不是真的活跃增长,第一步不是去看为什么涨,而是先确认你看的到底是哪个指标。事件次数回答的是“这个动作一共被触发了多少回”,它对每一次上报都计数;触发用户数回答的是“这段时间里有多少个不同的人至少触发过一次”,它对同一个人只算一次。一个人可以在一段时间里反复触发同一个事件,次数天然大于等于人数,两者之间的比值,就是人均触发次数。
我习惯把这两个口径并排画在同一张看板上——在分析工具里把这两个指标放在同一张图里对比,不用自己写SQL拼表。如果次数往上走、人数也往上走,那大概率是真的有更多人在用;如果次数往上走、人数却往下走,说明增量来自“老用户点得更勤”,而不是“新用户变多了”。这两种情况对应的动作完全不同,前者可以考虑承接流量,后者要回头去查为什么老用户在反复点。
| 对比项 | 事件次数 | 触发用户数 |
|---|---|---|
| 统计方式 | 对每一次上报累加计数(SUM) | 对触发过的用户去重后计数(COUNT DISTINCT) |
| 回答的问题 | 这个动作发生了多少回 | 有多少不同的人用过这个动作 |
| 同一用户触发两次 | 计为 2 | 仍计为 1 |
| 典型用途 | 衡量功能被使用的强度 | 衡量功能触达了多少人 |
| 误读后果 | 把重复操作当成新增活跃 | 把人均高频误判成用户规模扩大 |
举个例子,我们团队以前在看一个电商App的“加入购物车”事件时,就犯过把次数当人数看的错。当时事件次数连续两周上涨,大家以为拉新见效,直到把去重用户数拉出来才发现,新增的次数几乎全部来自一小撮在比价页反复点选规格的老用户。当时只用了累加计数、没有做去重,次数涨了,真实触达的人却没有增加。
为什么次数会“虚涨”:三类重复触发
次数涨而人数不涨,本质上是同一个人被反复计了多次。在我经手的排查里,重复触发的来源通常分成三类,它们的成因和处理方向完全不同。第一类是真实的用户行为重复,比如用户在两个商品之间来回比较,反复点同一个按钮;第二类是埋点重复上报,比如页面没有正确去重,一次操作发了多条相同事件;第三类是异常重试,比如接口失败后前端自动重试,或者用户因为页面没反应而连续点击。这三类原因都能让次数上涨,背后的业务含义却天差地别,必须先分清是哪一类,再决定动不动产品。
| 重复来源 | 典型现象 | 去重前后的差异 | 排查入口 |
|---|---|---|---|
| 用户真实重复操作 | 人均触发次数明显升高,集中在比价、详情页 | 去重后人数平稳,次数仍高 | 看人均触发次数分桶 |
| 埋点重复上报 | 短时间内同一用户瞬间爆出大量相同事件 | 去重后次数仍异常偏高,时间戳集中 | 核对SDK上报逻辑与触发时机 |
| 失败重试/连点 | 事件集中在某个出错页面,伴随接口报错 | 去重后次数与人数接近,但停留异常 | 结合前端报错与网络请求看会话 |
这里有个容易被忽略的点:埋点重复上报属于技术问题,它和真实业务波动混在同一条次数曲线里,单看趋势图分不开。要把它剥离出来,就得回到用户粒度,看单个用户到底在什么时间、以什么节奏触发了这个事件。
三步定位重复触发用户
在确认两个口径出现剪刀差之后,我通常按下面三步把问题定位到具体的人。这三步的目的不是马上下结论改版,而是先搞清楚“多出来的次数到底是谁点出来的”。
第一步:用去重计数拿到真实人数
先把这个事件按天做两条线:一条是事件次数(SUM),一条是触发用户数(COUNT DISTINCT)。这两条线都来自同一份原始上报,放在一起对比就能算出每天的人均触发次数。如果人均触发次数突然从1.2涨到3.5,而总人数没动,说明次数上涨几乎全部由人均行为变化贡献,而不是由新增用户贡献。
第二步:按人均触发次数给用户分桶
接下来把这段时间触发过该事件的用户,按人均触发次数分成几桶,比如只触发1次的、2到5次的、5次以上的。真实的比价行为通常只集中在少数用户身上,我会重点看5次以上那一桶贡献了多少次数。如果这一小撮人贡献了本周增量的大头,那次数上涨就不是普适现象,而是一群重度用户的行为放大。
第三步:锁定高频用户回看会话
最后挑出分桶里最高频的几个用户,回看他们那段时间的完整会话路径。只有回到具体操作序列,才能判断他们是在有目的地来回比较,还是因为按钮没反应在连点,又或者是埋点本身重复发了。这一步往往能直接把“用户行为问题”和“埋点技术问题”区分开。
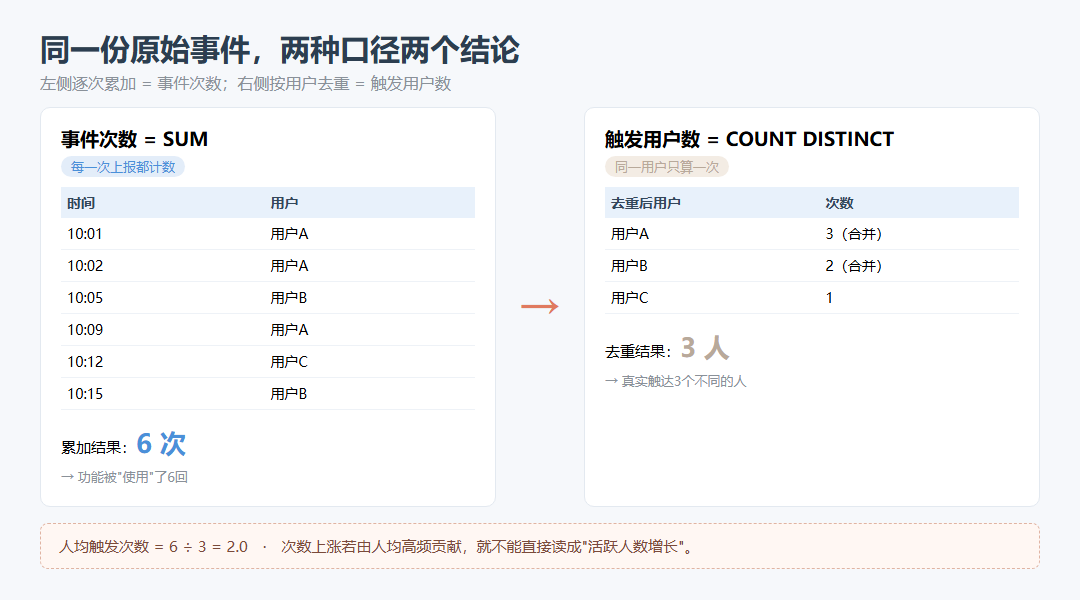 图2 同一批原始事件,用SUM累加与用COUNT DISTINCT去重,得到的是两个完全不同的业务结论
走完这三步,那张剪刀差图就有了着落。如果高频用户是在比价页正常来回比较,那次数上涨是健康的使用强度,不需要当成问题;如果高频用户是在某个提交页反复点却没成功,那上涨其实是失败信号,得去看接口和按钮反馈;如果时间戳高度密集且和用户操作对不上,那多半是埋点重复上报,要回到SDK的触发逻辑里修。
回到剪刀差:结论该怎么下
很多团队看到事件次数上涨,第一反应是“活跃变好,可以加资源”。但经过上面的拆解你会发现,次数上涨本身并不等于活跃增长。因为活跃增长对应的应该是“更多不同的人来了”,而次数上涨对应的可能只是“同一批人点得更频繁”。这两件事在业务上的含义完全不同:前者说明获客有效,后者可能说明产品里存在让人反复操作却无法完成的环节。
在我自己的工作流里,事件次数和触发用户数是必须成对出现的两个数。只看其中一个,就像只看温度不看湿度判断天气,结论一定会偏。之所以要把口径讲清楚,是因为后续所有加预算、改版、埋点修复的决策,都建立在这两个数到底代表什么之上。
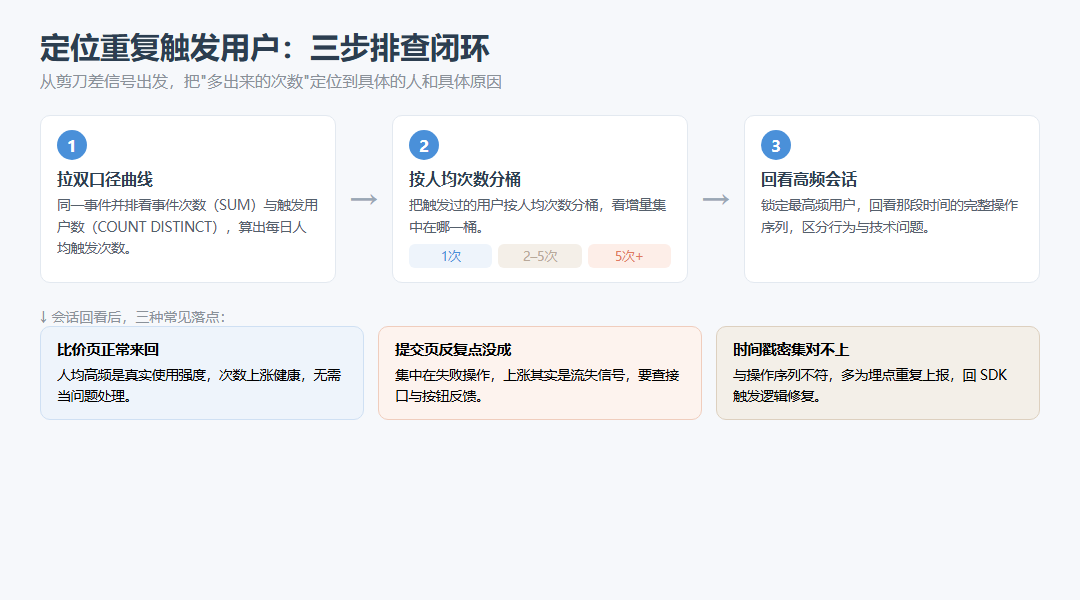 图3 从剪刀差信号出发,到定位高频用户、再到分桶归因的排查闭环
三种取数方式的差异
上面这套并排拉曲线、按人均分桶、回看会话的做法,落到具体工具上通常有三条路:自己写代码埋点数、用网站或 App 自带的后台看板、用第三方分析平台。三条路在接入成本、去重口径、跨端统一、实时性和维护成本上的差别,大致如下表。
| 对比维度 | 自建埋点/代码方案 | 网站/App原生后台 | 456数据 |
|---|---|---|---|
| 接入成本 | 前后端都要自己写上报和数仓,人均触发次数得自己算,周期以周计 | 后台默认开通,零接入 | 嵌入一段 SDK,按文档配置事件名即可,SUM 与 COUNT DISTINCT 现成可用 |
| 去重口径 | 自己写 COUNT(DISTINCT user_id),容易漏会话内重复 | 只给固定 PV/UV,不能按自定义事件去重 | 事件次数与去重用户数一键切换,去重逻辑内置 |
| 跨端统一 | 要自己做多端 ID 映射,去重人数才合得起来 | 网站和 App 后台各自独立,事件次数对不上 | 多端用户打通后,跨端触发数进同一份报表 |
| 实时性 | 自己数仓跑批,多数第二天才出数 | 自带后台多为 T+1 或准实时 | 更新频率以实际配置为准,当天可看次数与人数的剪刀差 |
| 维护成本 | SDK 升级、字段变更都要自己扛,去重 SQL 还得反复校验 | 后台开箱即用,去重口径却动不了 | SDK 升级由平台跟着发版,自己只维护事件名与属性,去重口径不用自己写 |
为什么选用这款工具
前面把口径拆清楚了,再回头看工具选择就顺了。先把次数和去重人数拉在一张图上、再按人均触发分桶、最后回看高频用户的会话——这三步在平台里分别对应事件分析的双指标对比、用户分群的人均值分桶、以及按用户 ID 查看行为路径与事件明细,不用自己写 SQL 拼表,看板上切两下就能拿到。其中 App 与小程序的事件上报属于基础版起开放的能力,用户分群与画像属于专业版起开放;网站分析本身有免费版可用,各版本具体开放能力以产品文档为准。如果你团队已经在用自建方案,对比上面这张表的五项差异再决定;原生后台够用的话,也没有必要额外换工具。
你们团队在看数据时,有没有把“事件次数”和“触发用户数”当成一个数用过?后来是在哪一步发现对不上的?欢迎在评论区说说你遇到过的口径乌龙。
常见追问
Q:事件次数和触发用户数应该看哪个?
A:取决于你要回答什么问题。如果你想衡量功能被使用的强度,看事件次数;如果你想衡量功能触达了多少人,看触发用户数。实际工作中我习惯两个都看,因为它们的比值(人均触发次数)能反映用户行为的深度。
Q:埋点重复上报怎么排查?
A:先看时间戳,如果同一用户在毫秒级内爆发大量相同事件,大概率是重复上报。再回到SDK的触发逻辑,检查是否在页面卸载或状态更新时重复绑定了事件监听。
Q:人均触发次数多少算正常?
A:没有统一标准,因为不同功能的使用频率差异很大。我一般的做法是和自己过去的基线比,如果某个功能的人均次数突然翻倍,就值得拆开看是哪类用户贡献的。